Ozaki II 补充材料:INT8 计算条件与论文性能图表
本页收录计算范围的推导、位数预算,以及完整论文性能表和阶段占比图,供需要核查细节的读者查阅。正文集中分析 H20 上的预处理成本。
1 Ozaki II 的算法流程与 INT8 计算条件
设 、,目标为 。每个输出元素是一个长度为 的内积;方阵实验里 。下文用 表示模数个数,用 表示缩放后的位数预算。
Ozaki II 的基本思路是:先把浮点输入缩放为整数值,再为每个整数生成 组小余数,用 路 INT8 GEMM 计算这些余数矩阵的乘积,最后合并并恢复原尺度。讨论性能之前,需要先确认每一路 INT8 计算能够可靠地承担什么工作。论文 §3
1.1 从 FP64 输入到多路 INT8 GEMM
选择两两互素的模数 ,记其乘积为 。再选择二次幂对角矩阵 、,分别缩放 A 的行和 B 的列。
| 阶段 | 操作 | 得到什么 |
|---|---|---|
| 缩放与整数化 | 控制范围后的整数值输入 | |
| 生成输入余数 | 每个模数对应一对 INT8 矩阵; 表示取对称余数 | |
| 主矩阵乘法 | INT8 输入、INT32 累加与输出 | |
| 输出约化 | 每个输出在该模数下的非负余数 | |
| 合并与逆缩放 | 用 CRT 合并得到 ,输出 | 返回原尺度的 FP64 结果 |
CRT(中国剩余定理)在这里负责合并各路余数。缩放阶段需要保证 ,其中 是整数乘积 的绝对值上界;满足范围与计算精度条件时,重构目标就是 。
这个流程有两项需要分别检查:余数输入能否装进 INT8,以及一个长度为 的乘积累加能否装进 INT32。它们决定低精度核心是否可靠;fast 与 accu 如何选缩放,见正文第二节。
1.2 为什么模数上限是 256
INT8 有 256 个可表示值,范围为 。若直接使用通常的非负余数 ,模数超过 128 时,部分余数就无法用有符号 INT8 表示。Ozaki II 使用对称余数,把它们放在零附近:
余数减去一个模数不会改变它在该模数下代表的整数。因此,对于 ,上面的整个区间都能放入 INT8。边界 对应 ,非负余数 128 以同余的 −128 表示。
这一步保留的是模数意义下的输入信息。原来的整数 可以远大于 INT8 范围,但每一路只保存它对一个模数的余数。多个模数共同承担完整信息的表示,因此不需要直接把整个 压进 8 位。
选择模数还受到两两互素的限制。在这个条件下,模数越大,每一路提供的范围位数 越多,因而有利于用较少的 GEMM 获得足够的总范围预算。论文 §3.1
1.3 INT32 累加的安全范围由内积长度决定
输入装得进去之后,还要保证乘法与累加不会溢出。对第 个模数,一项输出为
INT8 的最大绝对值是 128,因此每项乘积的绝对值至多为 。INT32 的有符号范围为 ,于是可以用绝对值和建立一个与正负抵消无关的保守界:
只要
最终结果就不会超出 INT32。更重要的是,任意中间部分和也受同一个绝对值总和约束,因此这个条件不依赖“最后正负相消”,也能覆盖不同的累加顺序。
当乘法和累加都在整数范围内进行时,它们可以精确完成,没有浮点有效位不足造成的舍入。这就是论文在这里选用 INT8 × INT8 → INT32 的依据:低精度输入减少硬件成本,更宽的累加器保住内积结果。
严格小于号有实际意义。若 ,上述最坏情况上界达到 ,已经超过 INT32 的最大正值。这个条件是充分条件;超过它不代表所有输入都会溢出,但通用保证已不再成立。
对更长的内积,可以沿 维分块,让每块的累加满足范围条件,再对块结果取模并在安全范围内合并余数。必须在发生溢出之前控制它;对已经溢出的 INT32 结果事后取模,一般不能恢复正确余数。论文 §3.1
1.4 一共需要多少路 GEMM
一个模数对应一对余数矩阵和一次主 GEMM,所以 个模数需要 次主 GEMM。各路独立使用 INT32 累加器,增加 不会把上述内积长度变成 。
的选择取决于需要多少总范围预算:
每个接近 256 的模数贡献接近 8 位。论文给出的 16 模数配置合计约 125 位范围预算,供两侧输入的位数、内积累加和符号共同使用。在输入量级分布温和、缩放与重构精度满足要求时,16 路主 GEMM 因而有望支持 FP64 级精度;它不是对任意输入都有效的固定路数。
这里可以把两个限制明确分开:
| 约束 | 由什么控制 | 影响什么 |
|---|---|---|
| 每路整数 GEMM 的累加范围 | 模余数大小与内积长度 | 该路计算能否精确完成 |
| 完整整数乘积的恢复范围 | 模数乘积 与输入缩放 | 能否容纳足够多的输入信息 |
后文 fast- 与 accu- 的后缀都是主计算使用的模数数目。accu 还会为估计上界增加一次 GEMM,这次计算属于预处理。
2 为什么希望缩放后元素不超过
这是控制乘积范围的一种充分条件。若两侧整数输入分别满足 、,那么
限制单个输入,便能在真正执行乘法之前控制所有输出。缩放又应尽量大,因为单位整数网格对应原尺度上的步长为 或 :放大得越多,截断时丢掉的信息通常越少。
在两侧采用相同预算时,论文的式 (18) 为:
把模数乘积展开,可得:
忽略下取整与很小的最后一项,趋势近似为:
模数提供范围位数,内积长度消耗累加预算,符号消耗一位,剩下的由两个输入分享。因此,多一个接近 8 位的模数,单侧预算约增加 4 位; 增加四倍,单侧预算约减少一位。
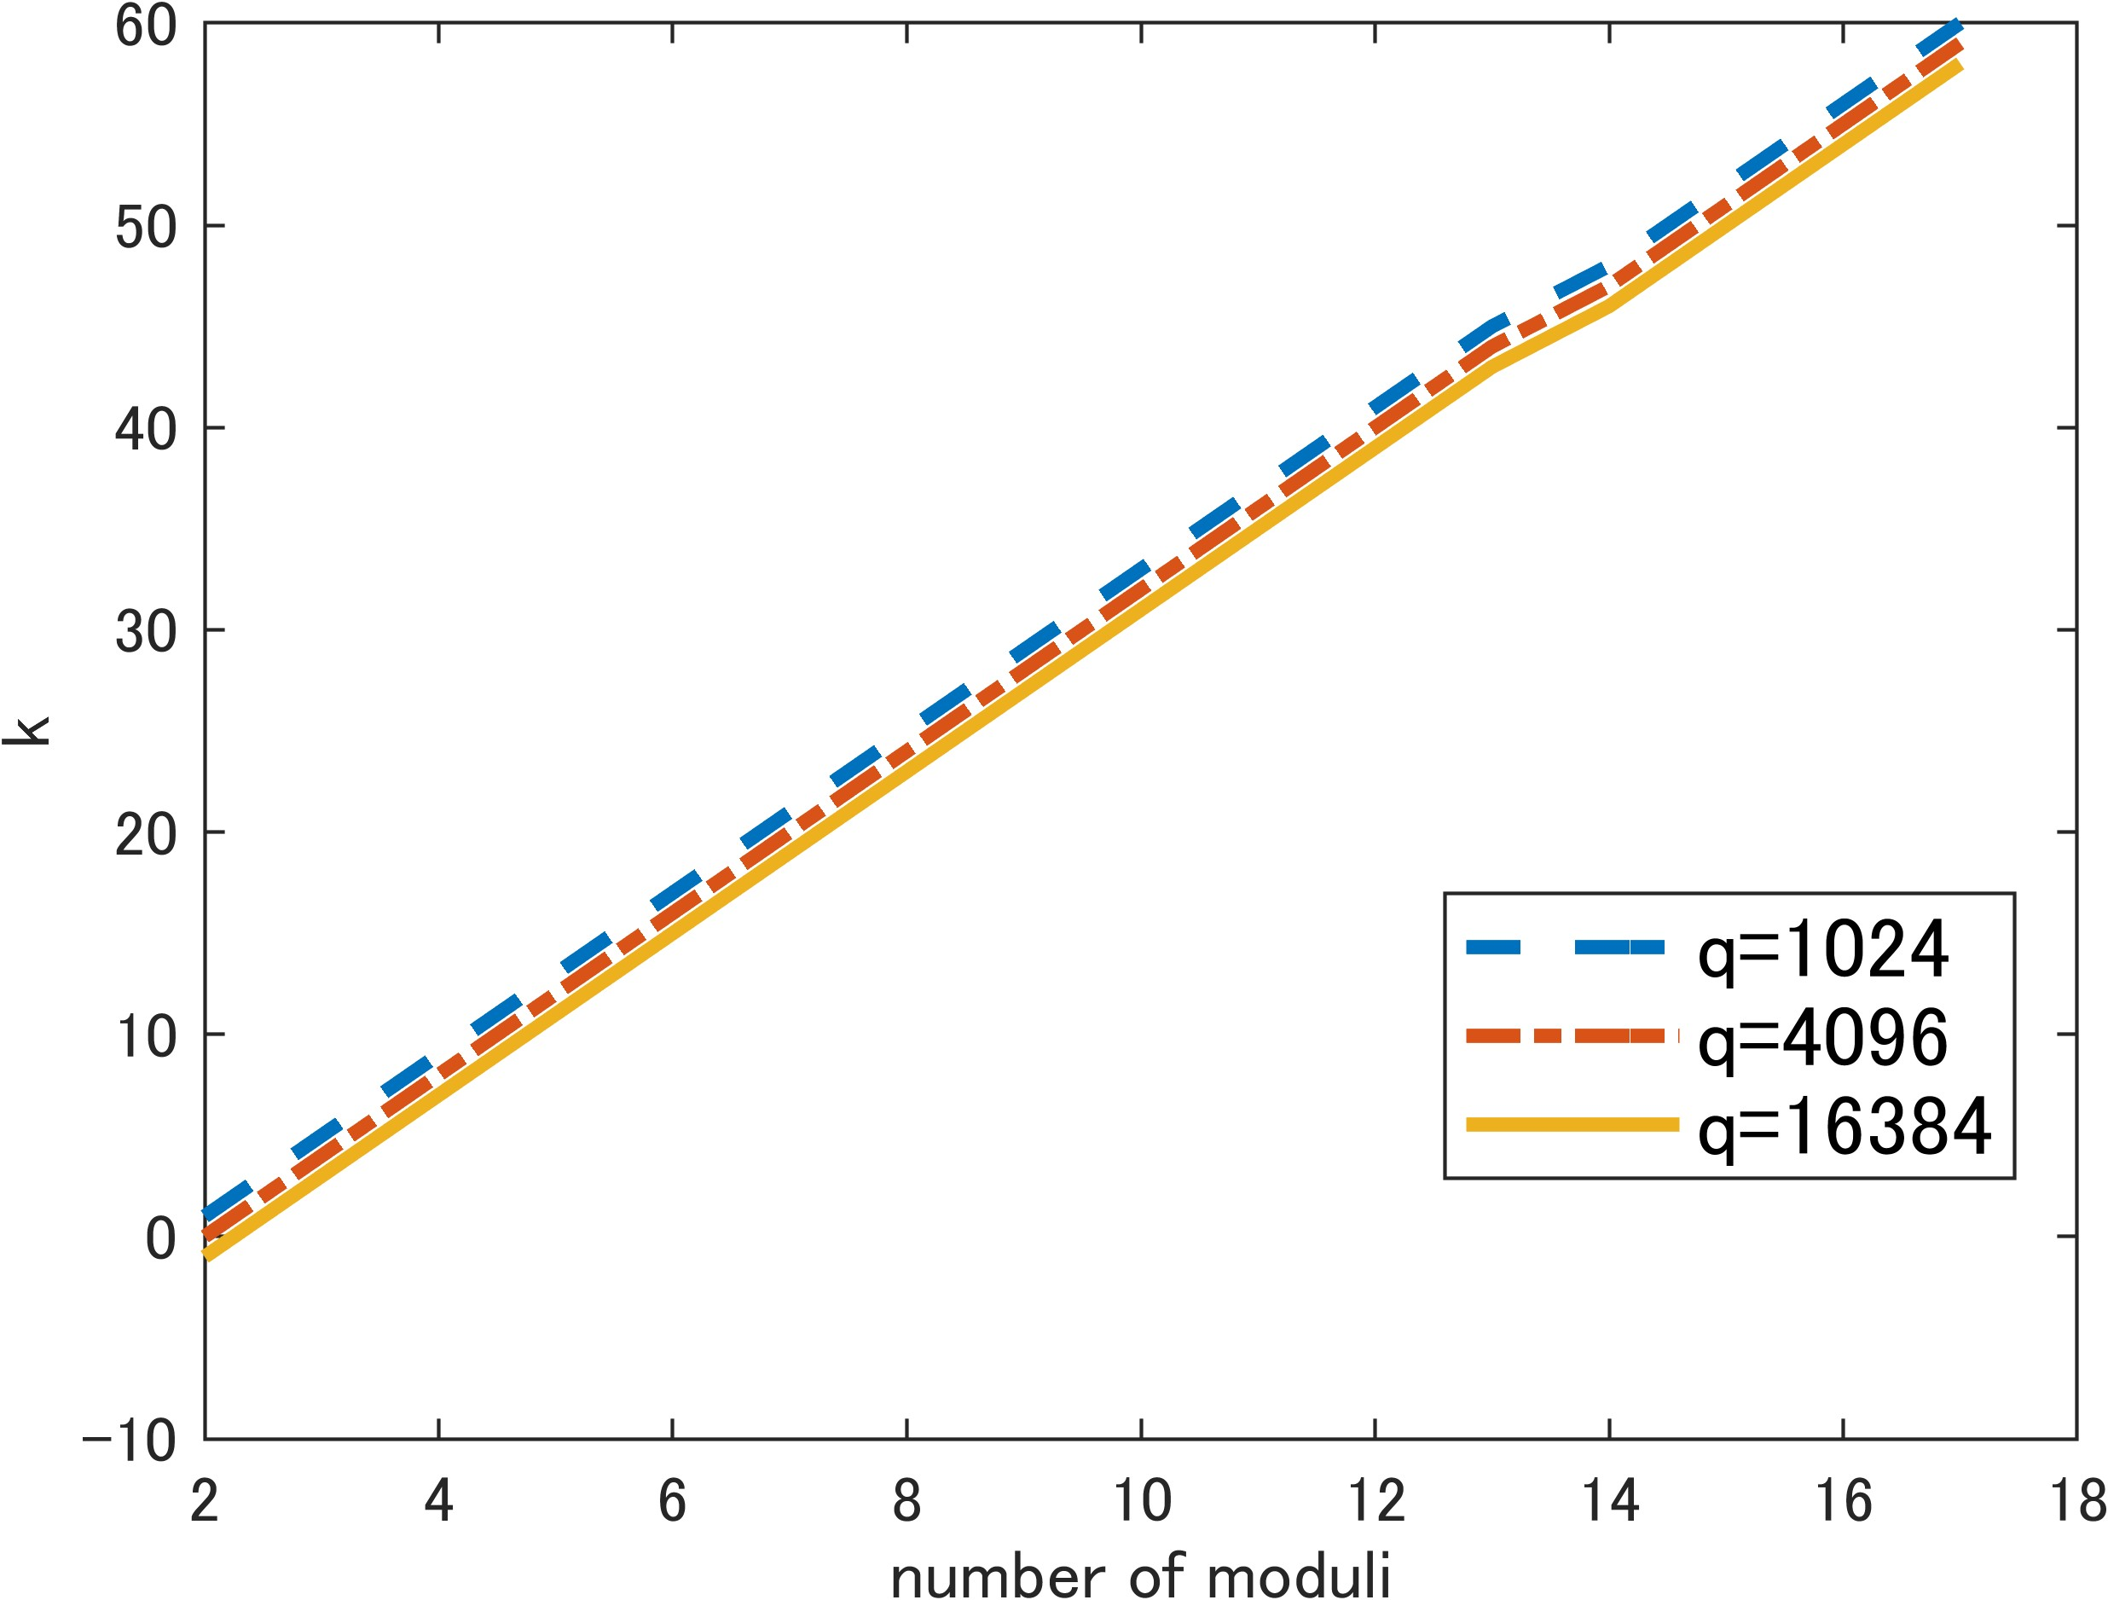
论文 Fig. 3。来源:§3.1。这是固定点范围预算,不是每个元素都保留同样多浮点有效位的保证。
这个公式把模数数量与输入预算联系起来,但共享缩放仍受数值分布影响。若一行中同时有很大与很小的数,小元素可能被截断;更贴近实际输入的乘积上界,便有机会减少过度保守的缩放。
3 性能收益有多大,时间又花在哪里
3.1 用 INT8 模拟 FP64,实际能快多少
先看论文 Table 1 给出的稠密峰值背景。浮点列单位为 TFLOPS,整数列为 TOPS;这些是规格值,不是实测吞吐。
| GPU | 普通 FP64 | FP64 Tensor Core | INT8 Tensor Core |
|---|---|---|---|
| GH200 对应 Hopper 规格 | 34 | 67 | 1979 |
| RTX 4090 | 1.29 | — | 660.6 |
来源:论文 Table 1 及 §4.1。这里不把 GH200 的规格套用到 H20。
原生 DGEMM 指直接执行的双精度矩阵乘法。下列数值来自论文原表,单位为有效 TFLOPS,以最终矩阵乘法的 运算量除以耗时计算。它不是内部执行的 路 INT8 总吞吐。
GH200 吞吐:尺寸与模数数量的影响(论文 Table 3)。
| 方法 | 2048 | 4096 | 8192 | 16384 |
|---|---|---|---|---|
| DGEMM | 56.9 | 61.3 | 62.0 | 60.9 |
| fast-14 | 16.5 | 48.6 | 72.1 | 80.2 |
| fast-15 | 15.4 | 45.2 | 67.4 | 74.6 |
| fast-16 | 14.6 | 43.2 | 63.8 | 70.4 |
| fast-17 | 13.8 | 40.5 | 60.1 | 66.1 |
| fast-18 | 13.0 | 38.3 | 56.9 | 62.6 |
| accu-14 | 14.7 | 42.7 | 64.7 | 71.1 |
| accu-15 | 14.0 | 40.2 | 60.9 | 66.9 |
| accu-16 | 13.3 | 38.5 | 58.0 | 63.3 |
| accu-17 | 12.6 | 36.4 | 55.1 | 59.9 |
| accu-18 | 12.0 | 34.7 | 52.2 | 56.6 |
RTX 4090 吞吐:尺寸与模数数量的影响(论文 Table 4)。
| 方法 | 2048 | 4096 | 8192 |
|---|---|---|---|
| DGEMM | 0.61 | 0.62 | 0.62 |
| fast-14 | 3.73 | 6.94 | 9.81 |
| fast-15 | 3.54 | 6.55 | 9.20 |
| fast-16 | 3.31 | 6.22 | 8.76 |
| fast-17 | 3.07 | 5.90 | 8.29 |
| fast-18 | 2.91 | 5.56 | 7.83 |
| accu-14 | 3.46 | 6.51 | 9.23 |
| accu-15 | 3.29 | 6.04 | 8.68 |
| accu-16 | 3.10 | 5.69 | 8.26 |
| accu-17 | 2.93 | 5.40 | 7.81 |
| accu-18 | 2.84 | 5.18 | 7.41 |
来源:论文 Table 3、4。后缀 14–18 表示模数数量。
GH200 的原生 FP64 很强,小矩阵上 OS II 的额外工作抵消了收益;到 16384 阶时,fast-14 达到 。RTX 4090 的原生 FP64 弱得多,在 8192 阶时,同一方法达到 。收益高度依赖硬件的低精度与高精度吞吐比例。
同尺寸、同模数数量的所有表格条目中,fast 都比 accu 快。模数越多,两者吞吐都下降。然而实际选择应比较满足同一误差要求所需的时间;如果 accu 能用更少模数达标,同 的排名就不能直接回答这个问题。性能表本身没有给出每种输入的精度门槛,实际配置仍需用目标数据验证。
3.2 一次 Ozaki II 调用的时间花在哪里
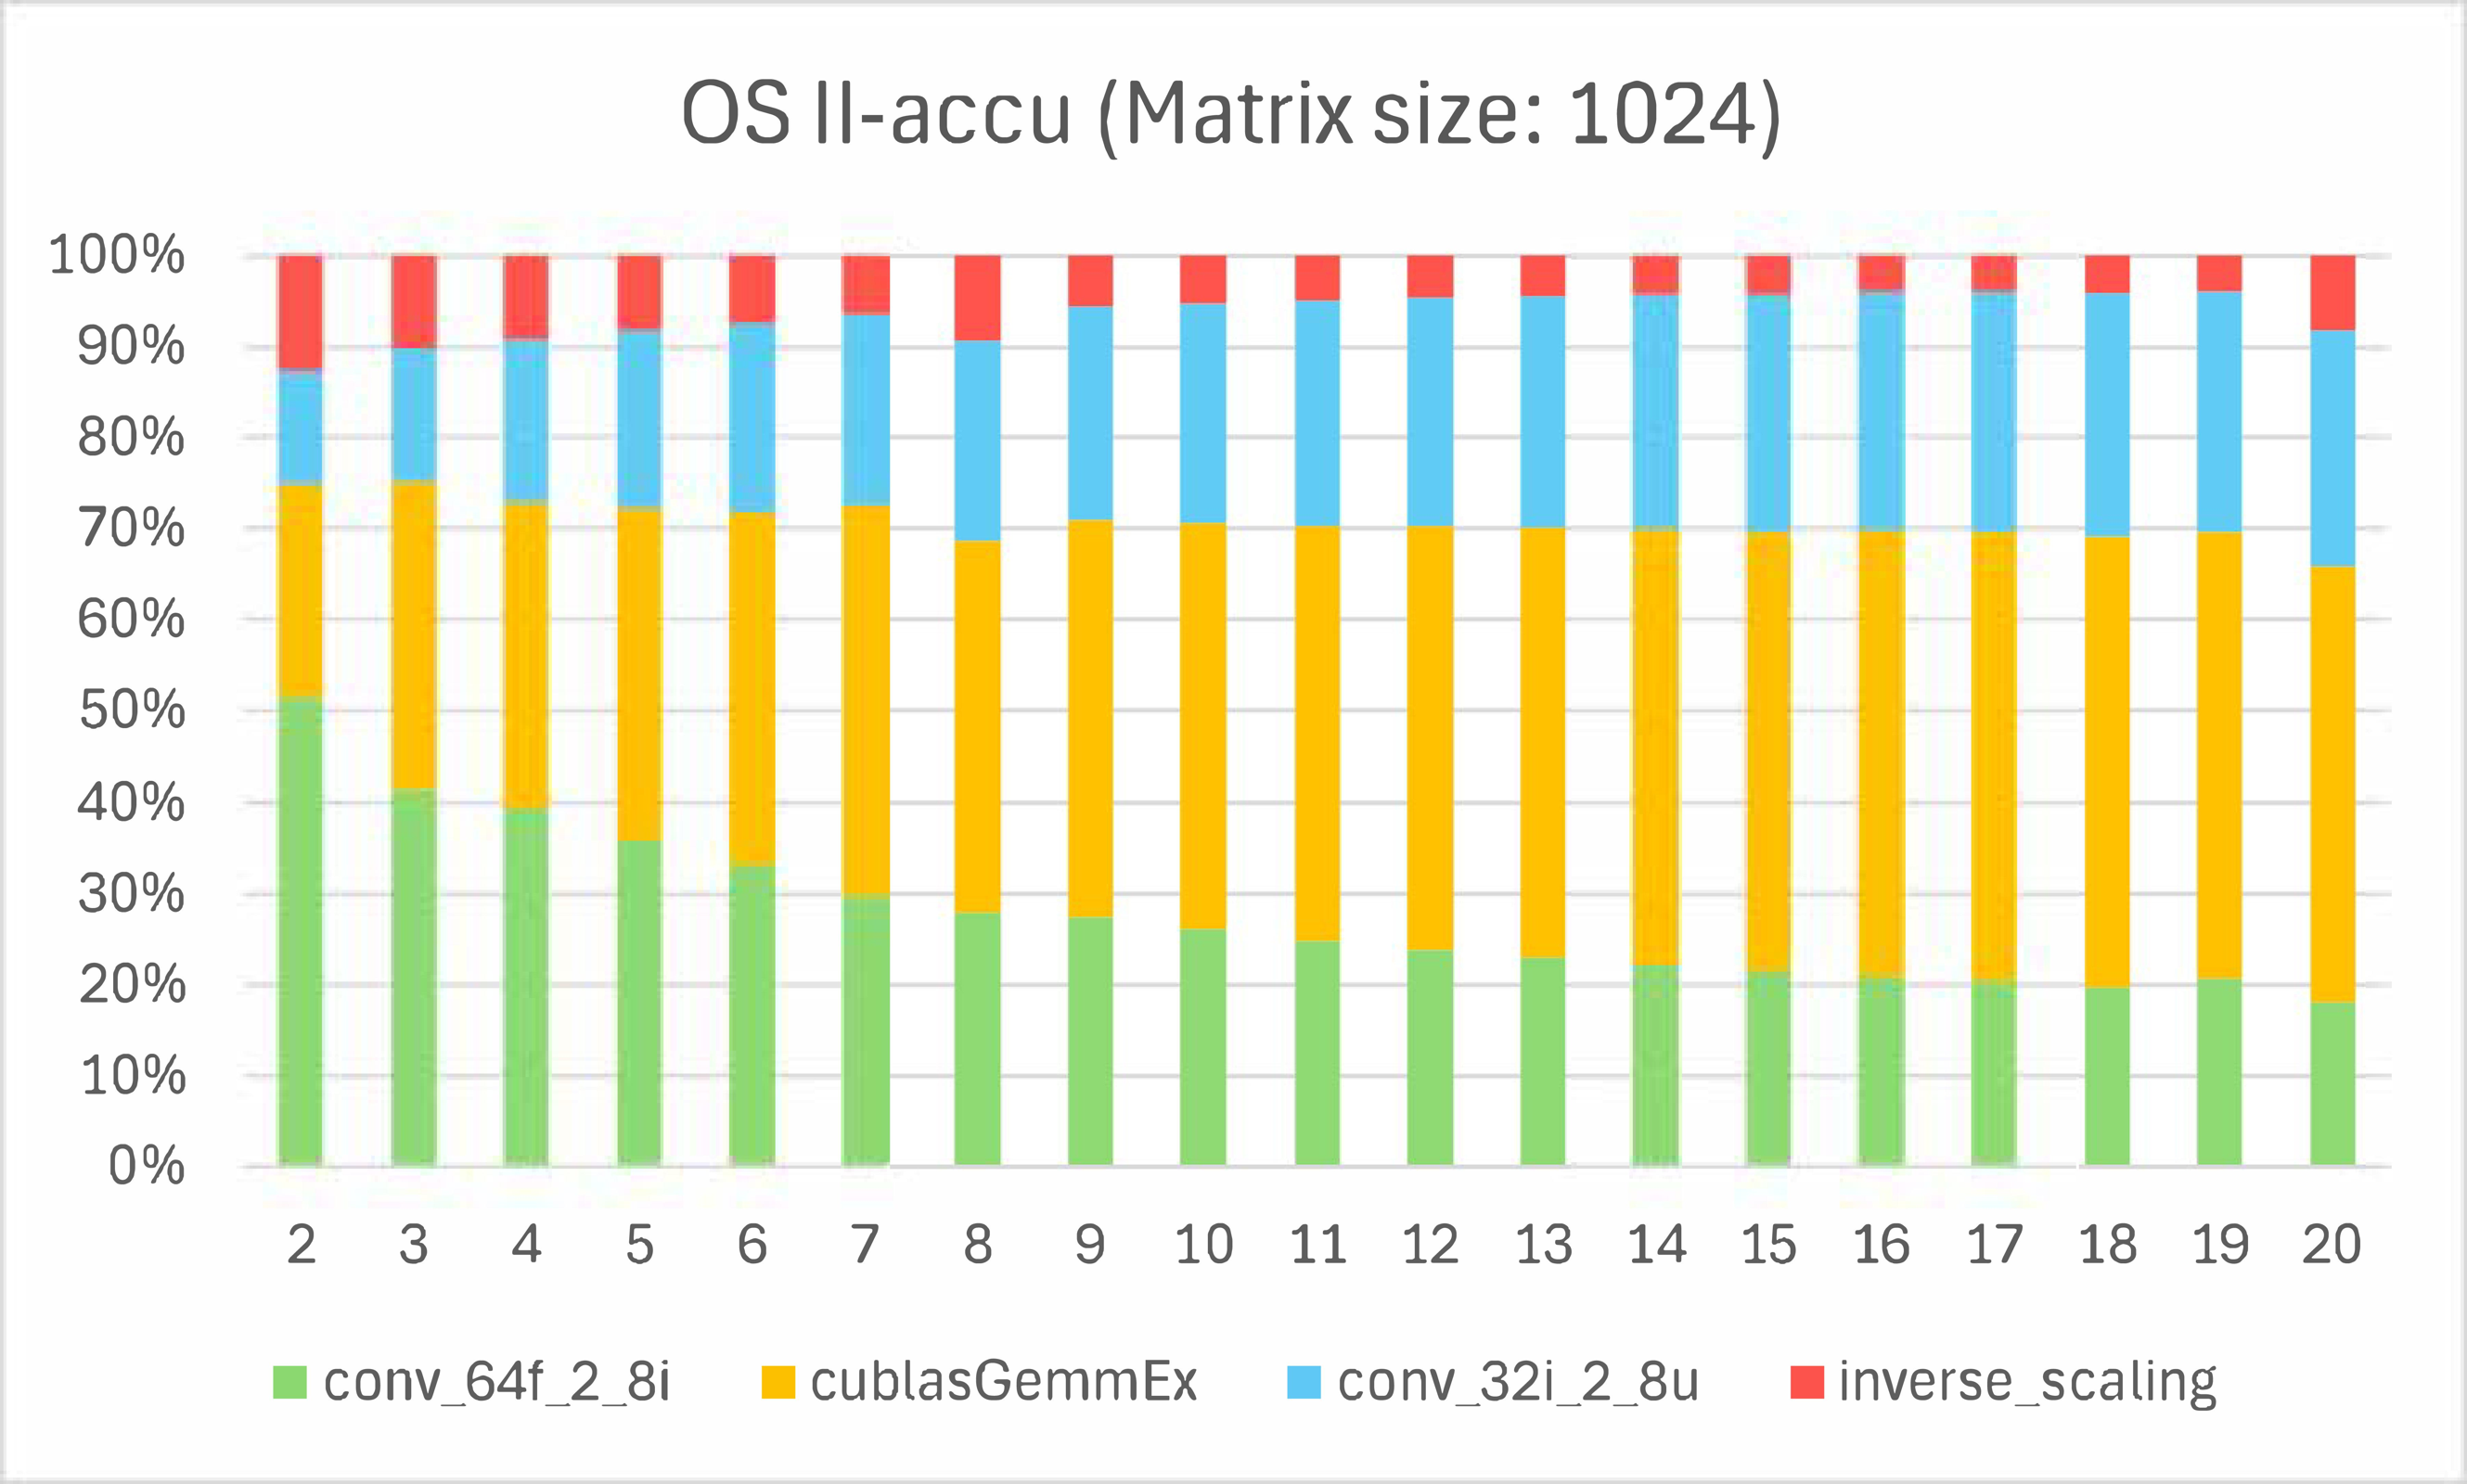
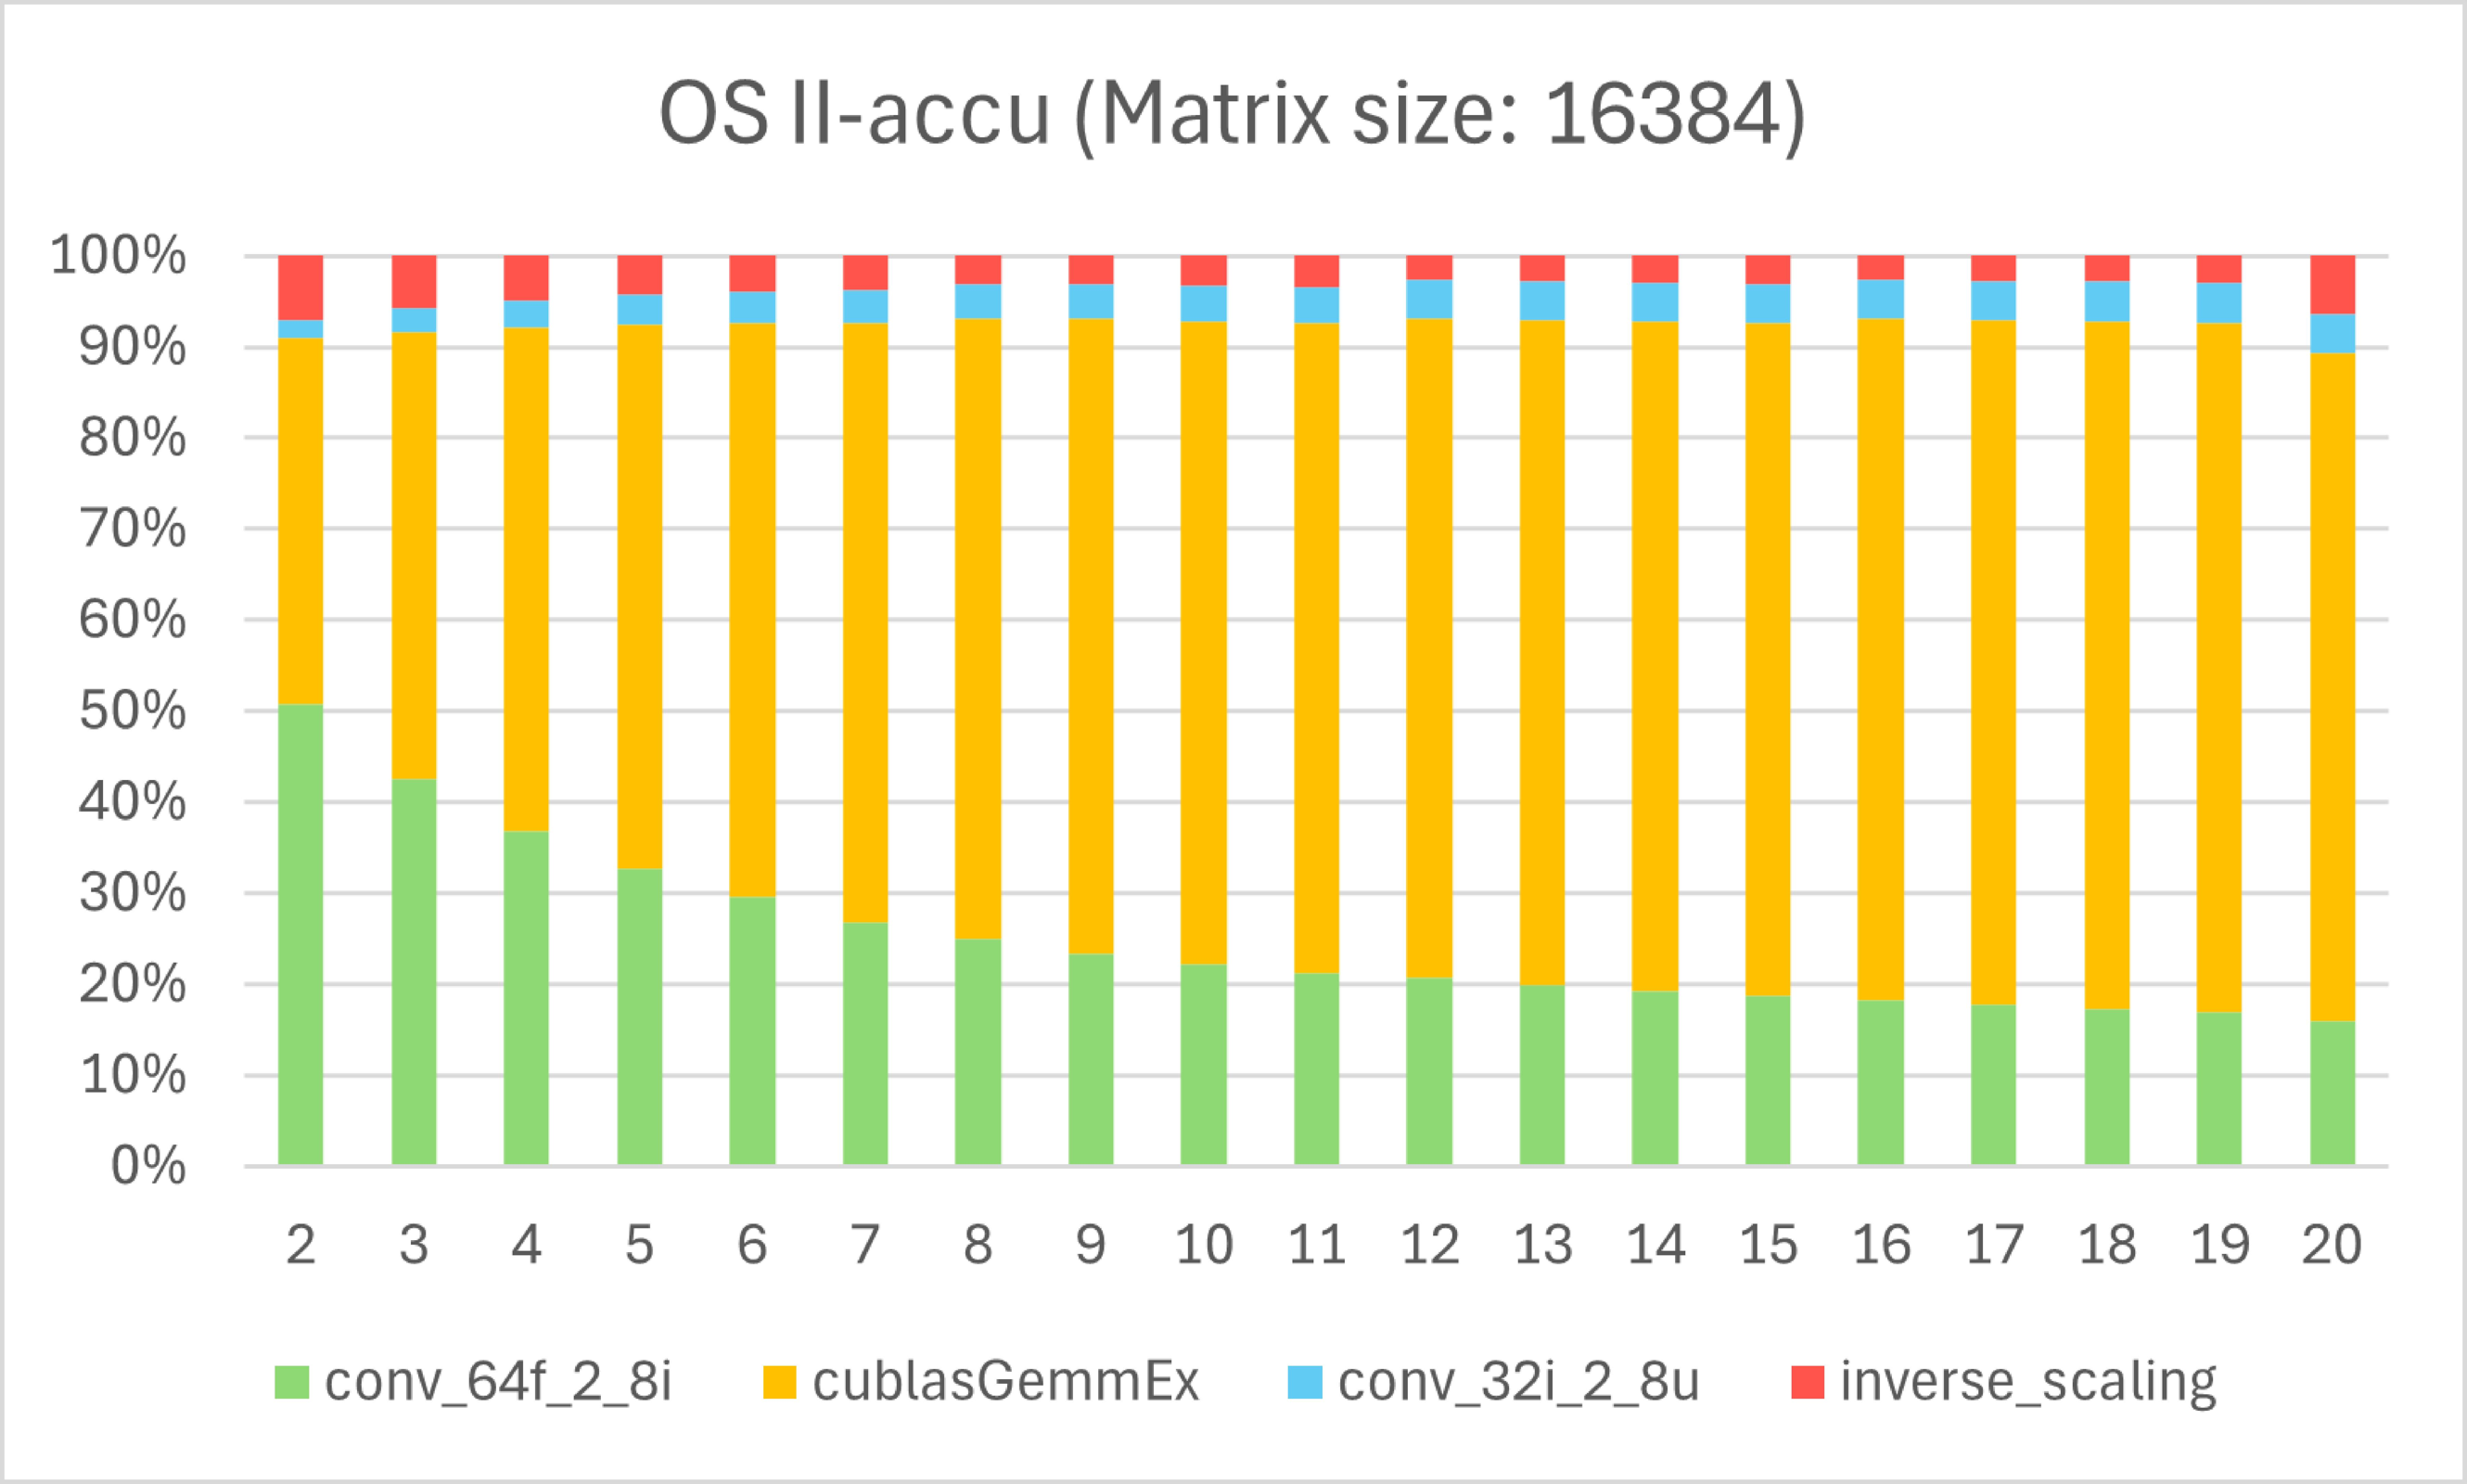
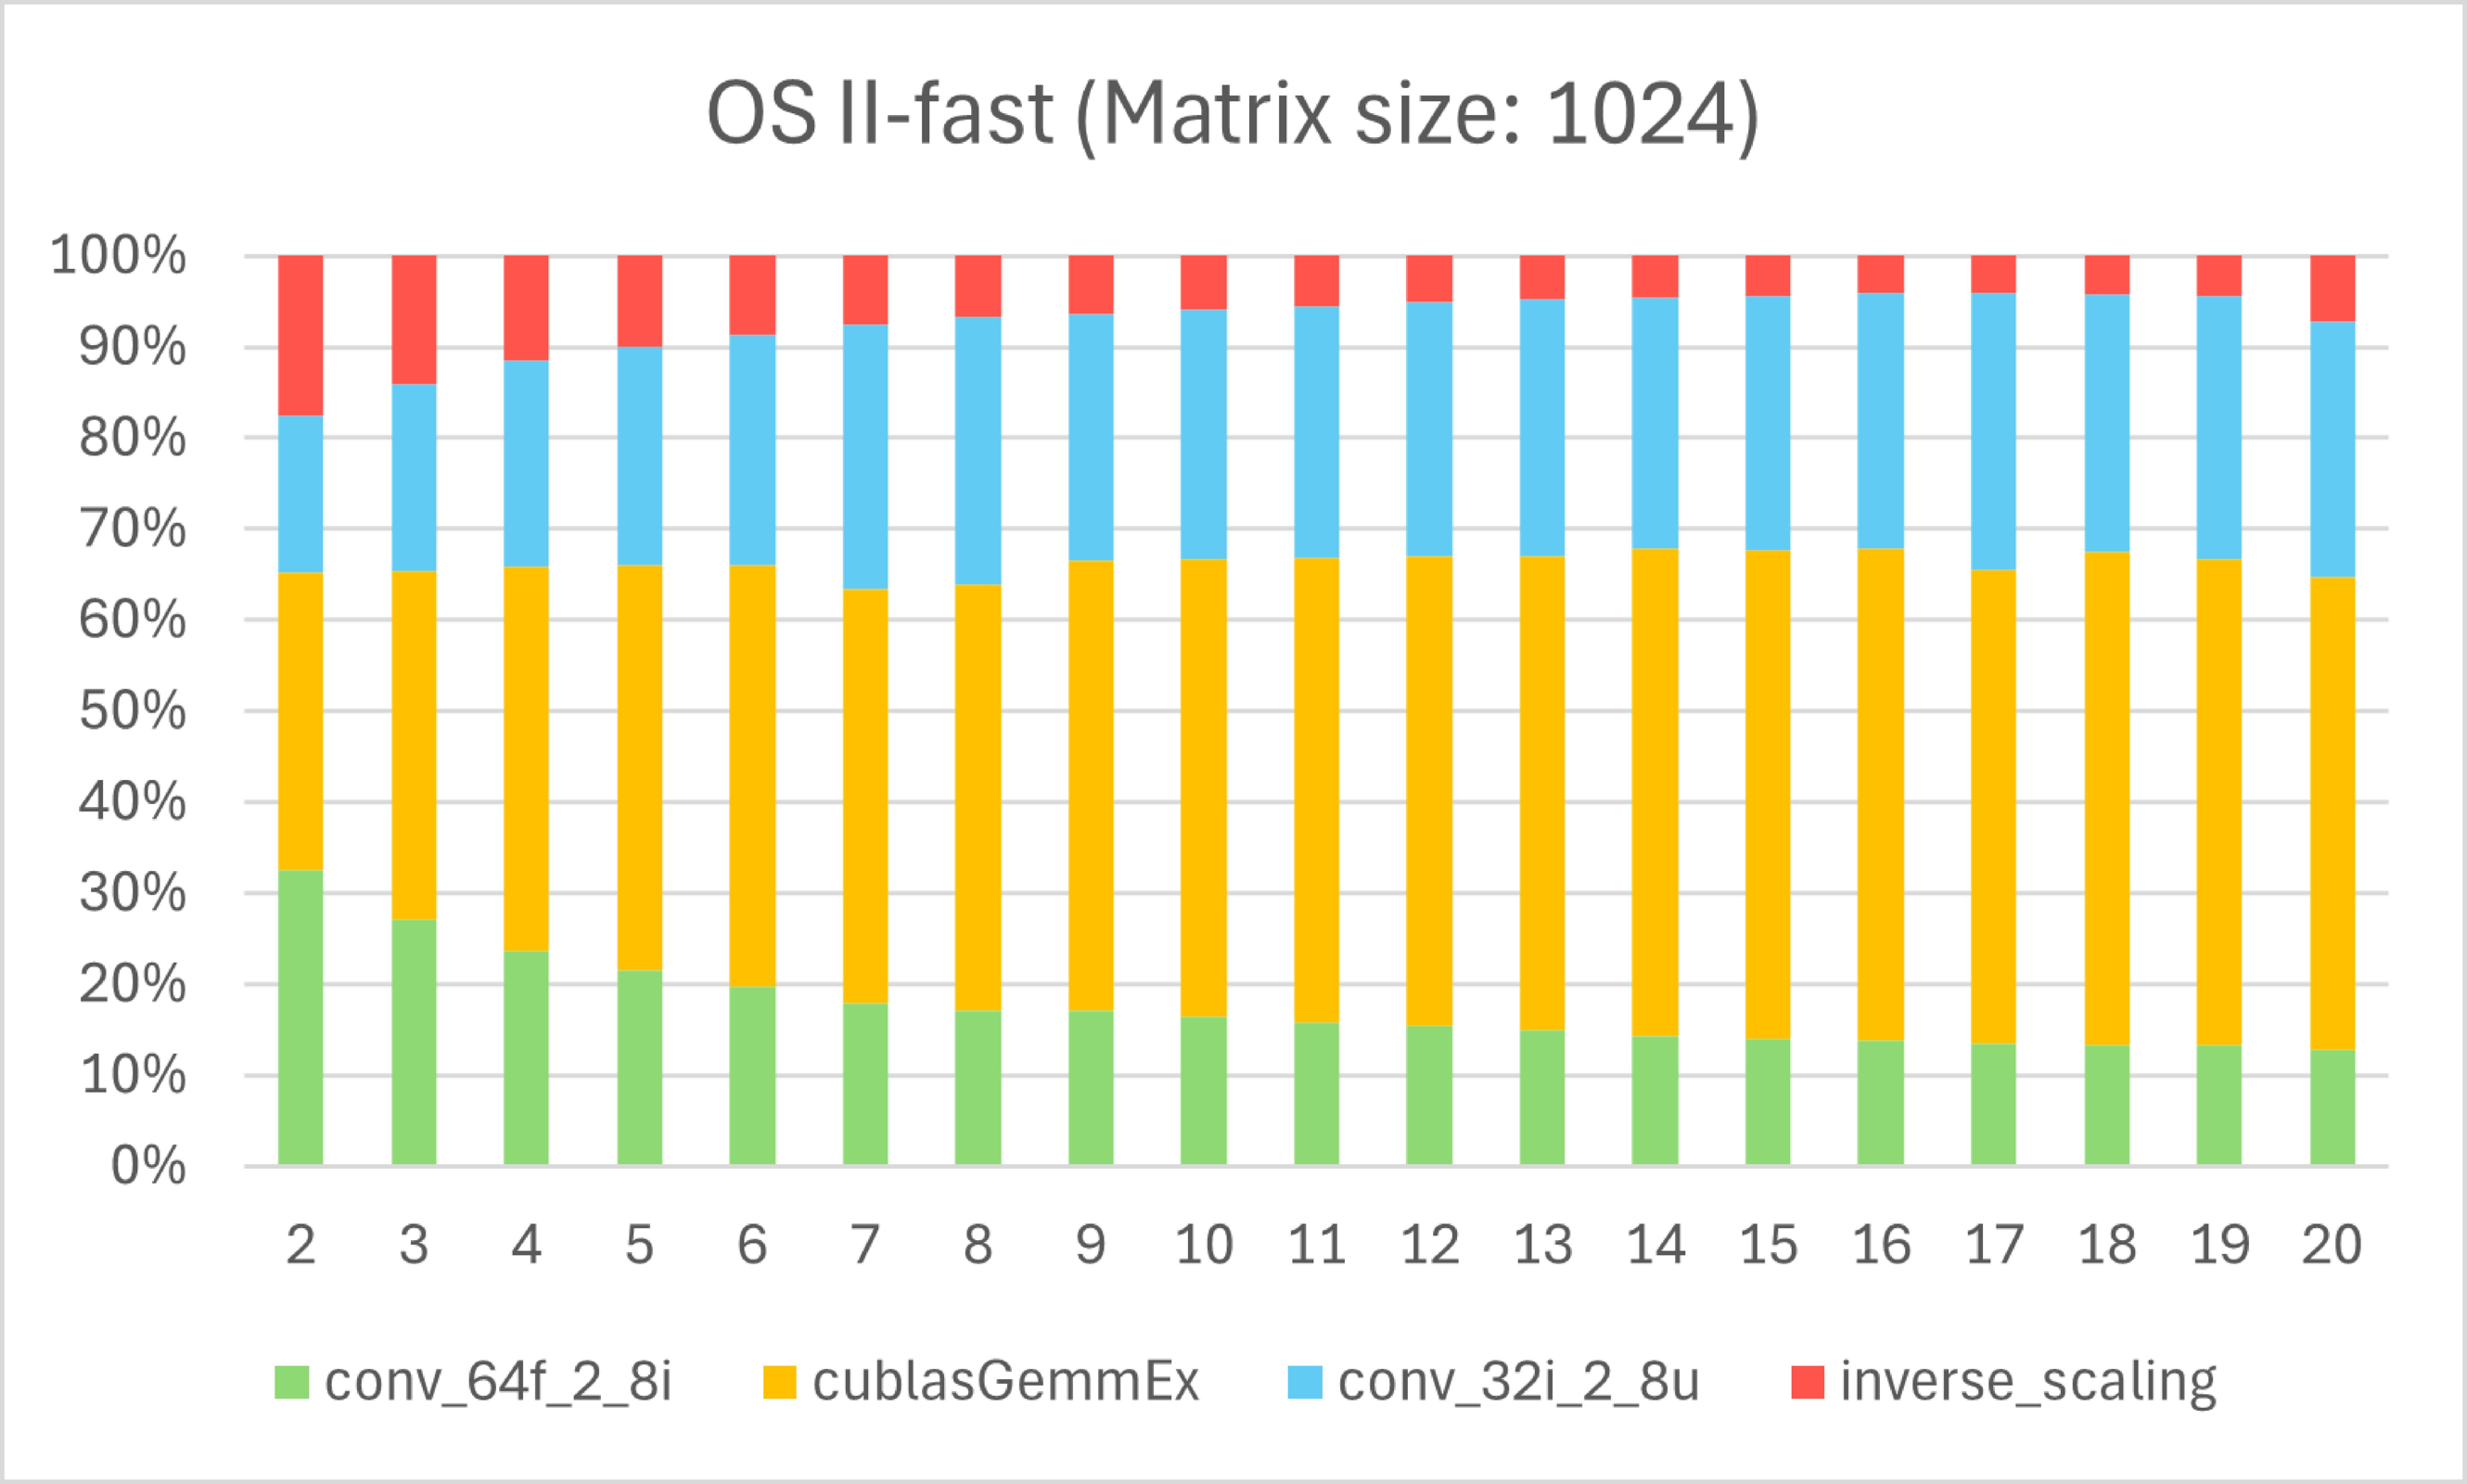
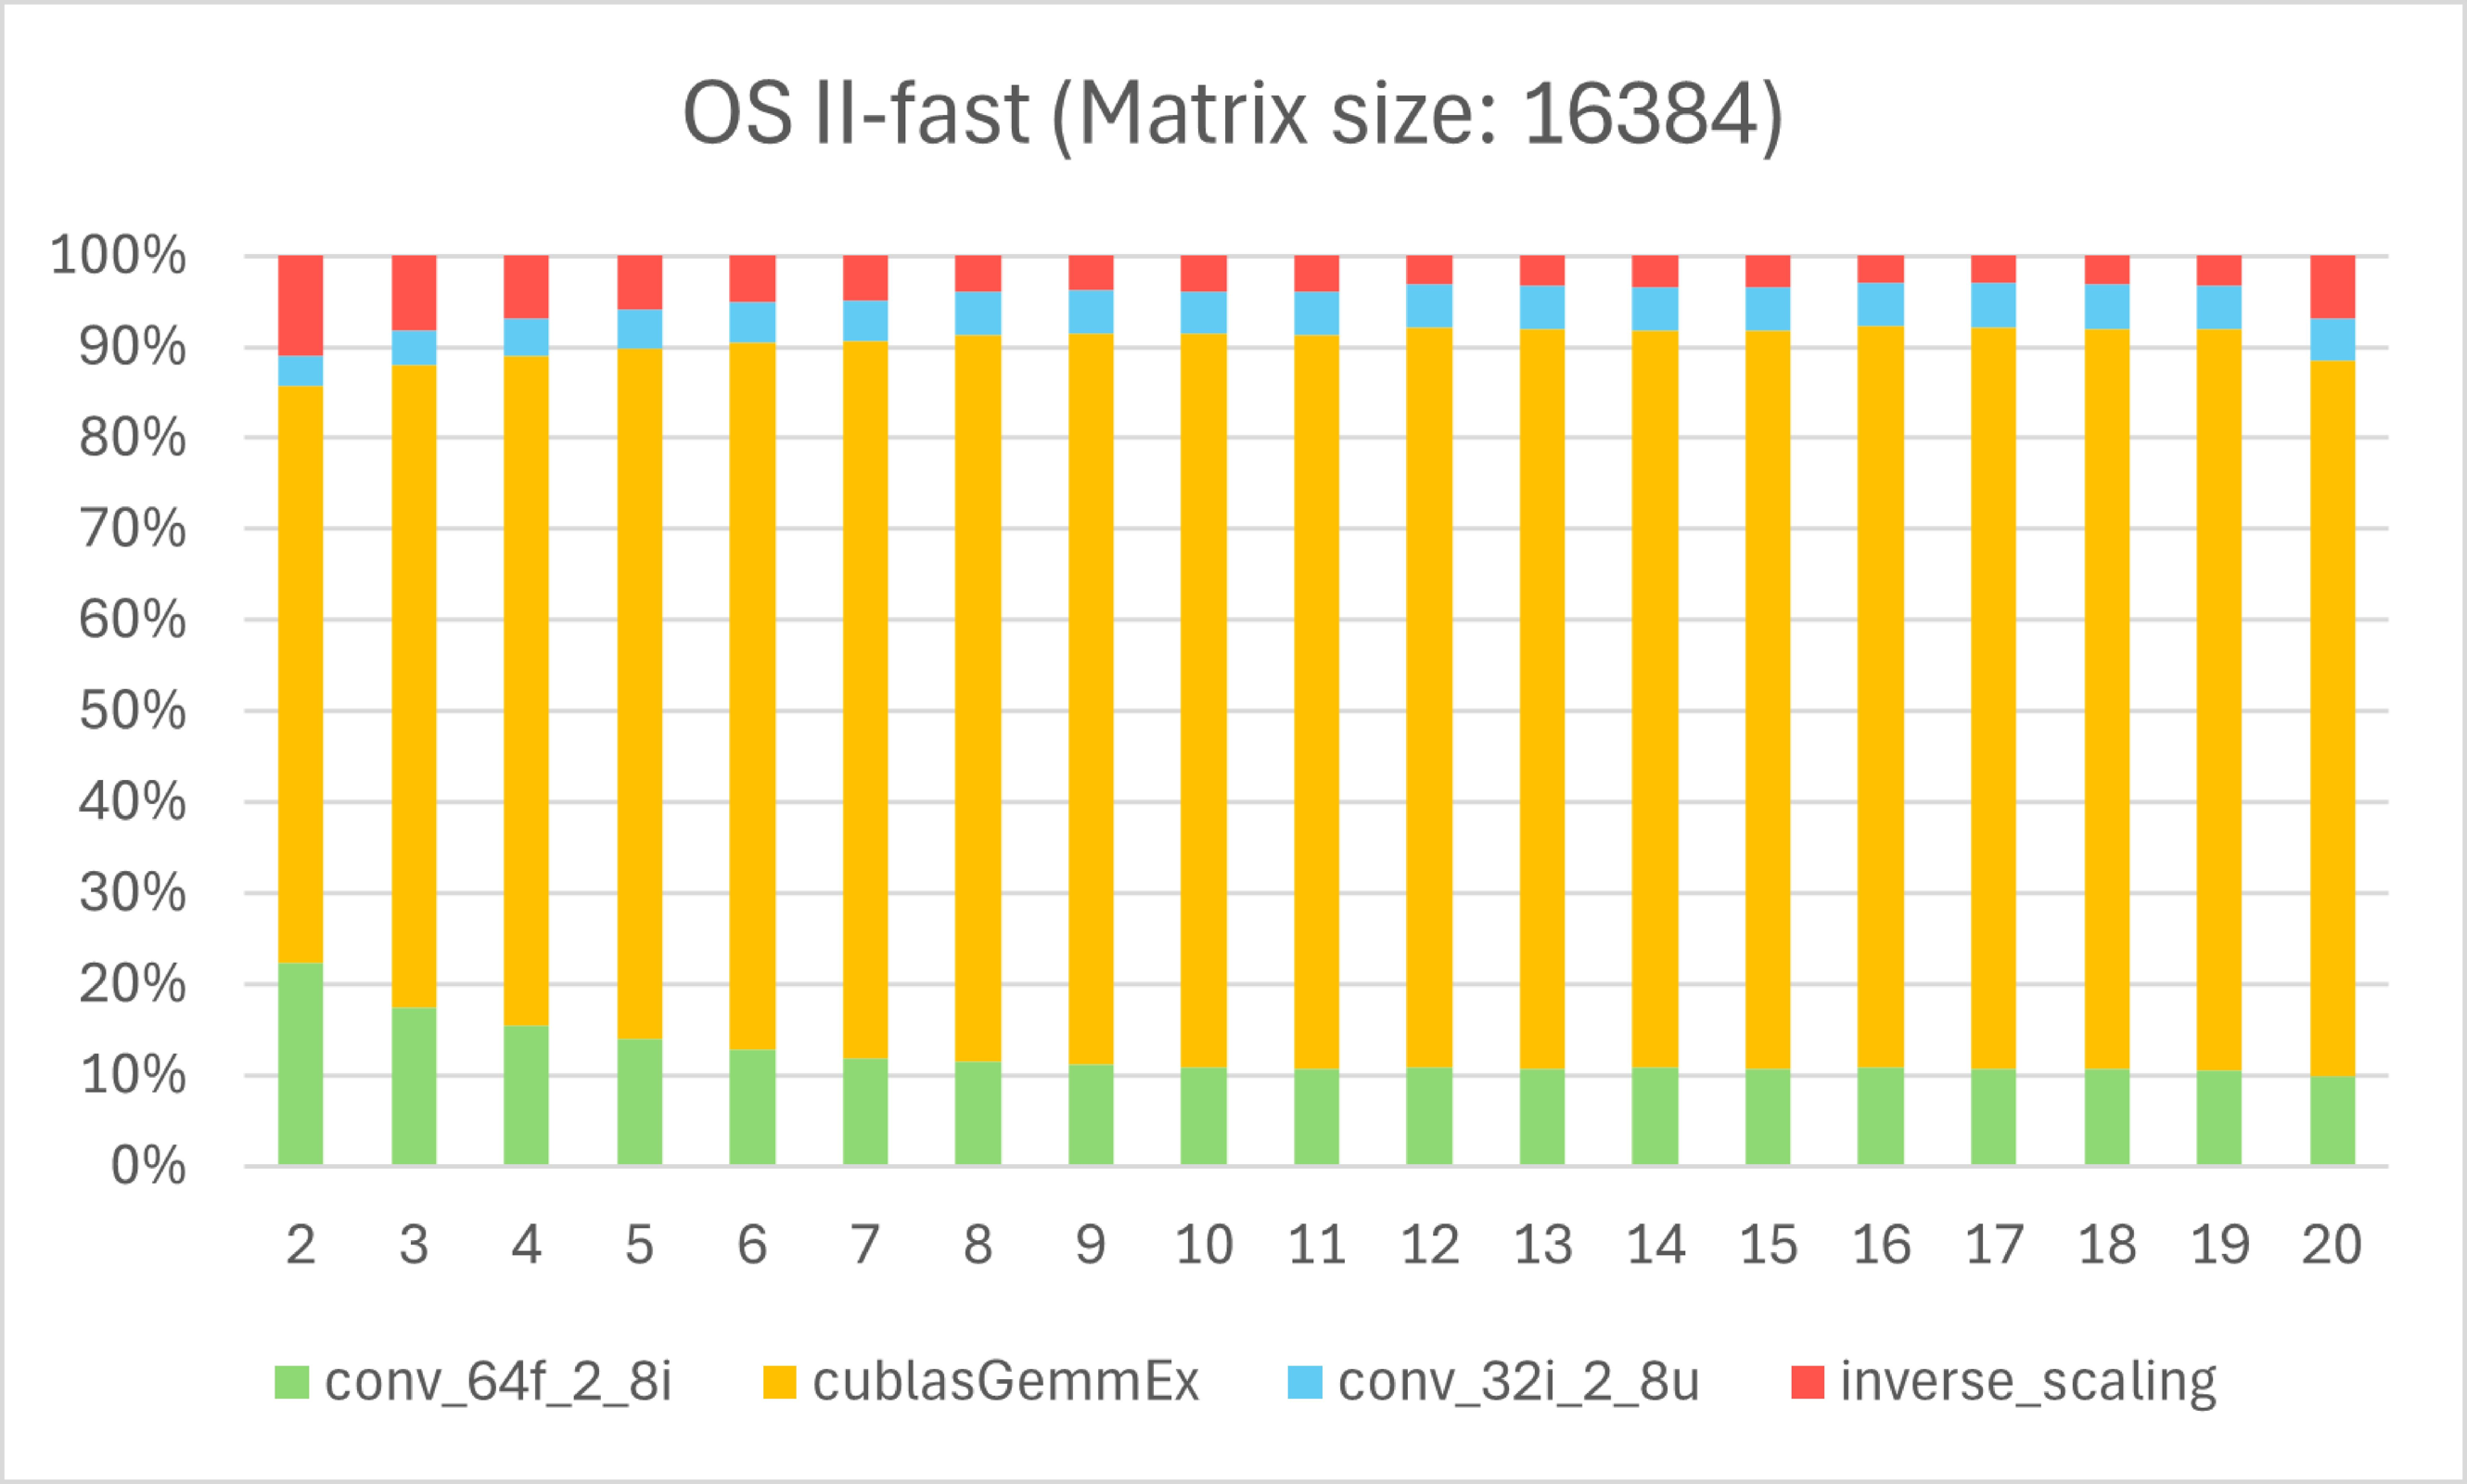
| 颜色 | 实现阶段 | 内容 |
|---|---|---|
| 绿色 | conv_64f_2_8i |
估界、缩放、截断、生成全部 INT8 余数;accu 的估界 GEMM 也在这里 |
| 黄色 | cublasGemmEx |
路主 INT8 × INT8 → INT32 GEMM |
| 蓝色 | conv_32i_2_8u |
把每路 INT32 结果约化为该模数下的 UINT8 非负余数 |
| 红色 | inverse_scaling |
CRT 组合、范围约化与逆缩放 |
论文 Fig. 6,GH200,,accu 与 fast。
论文 Fig. 7,RTX 4090,,accu 与 fast。
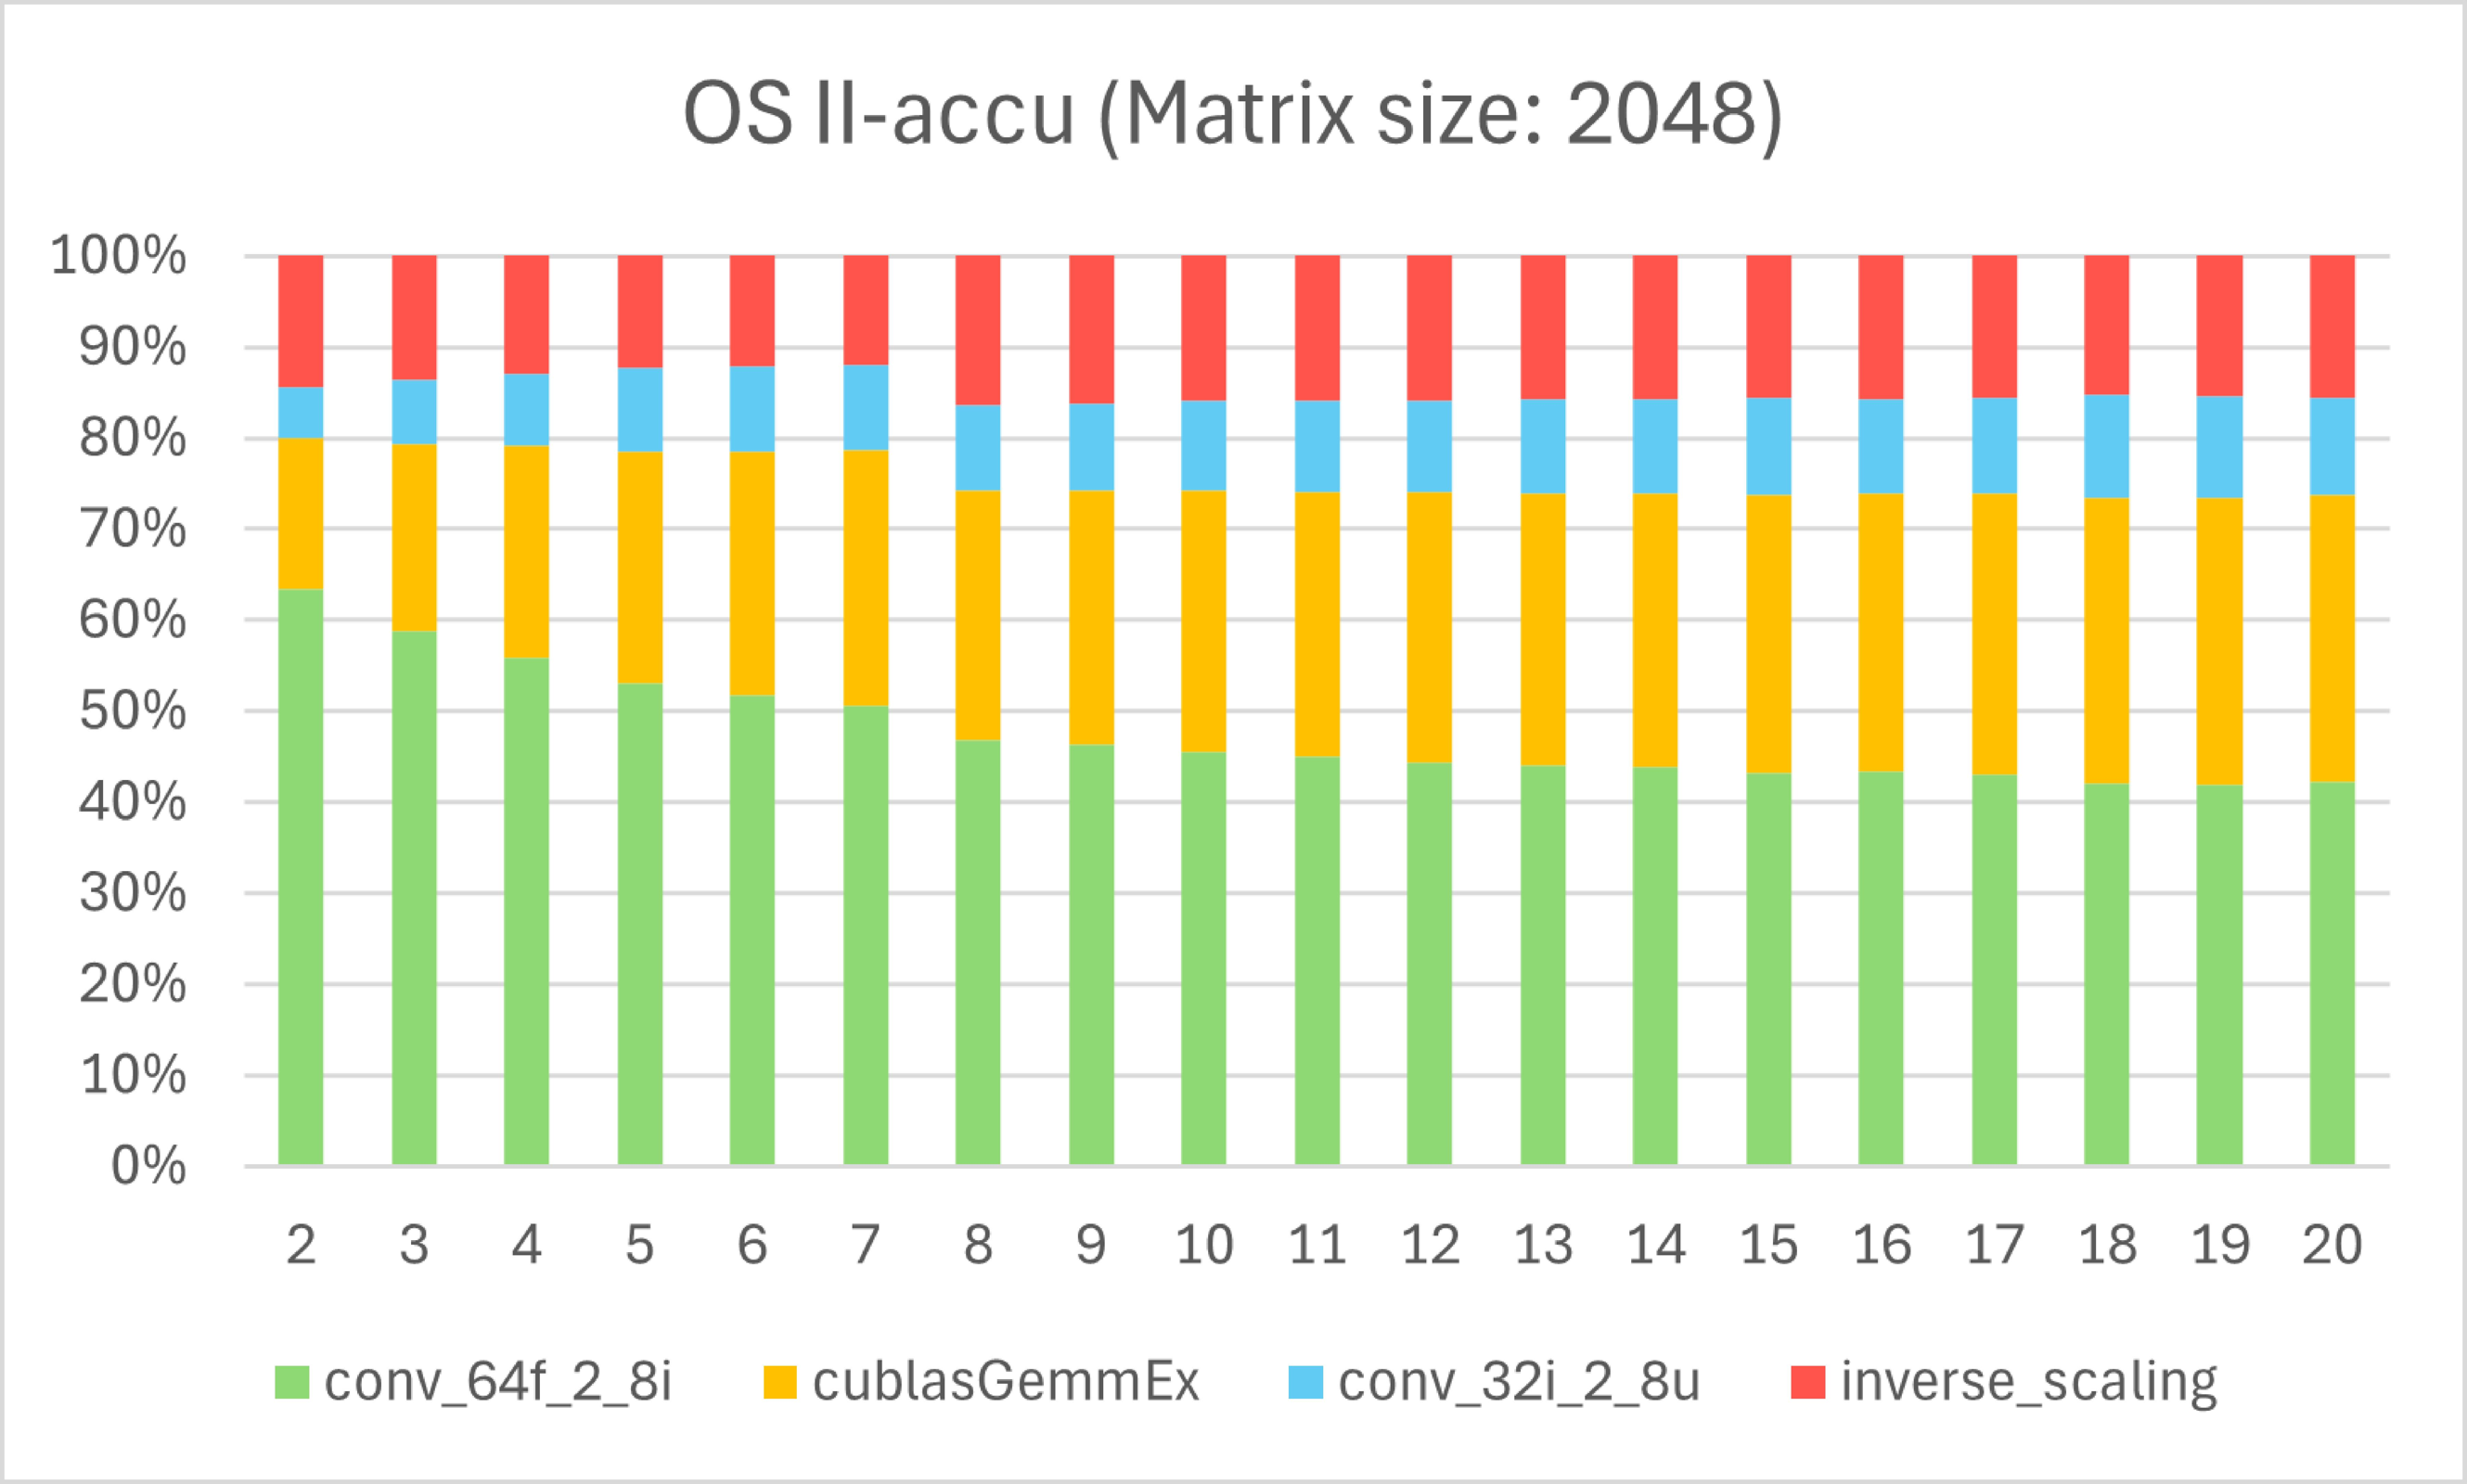
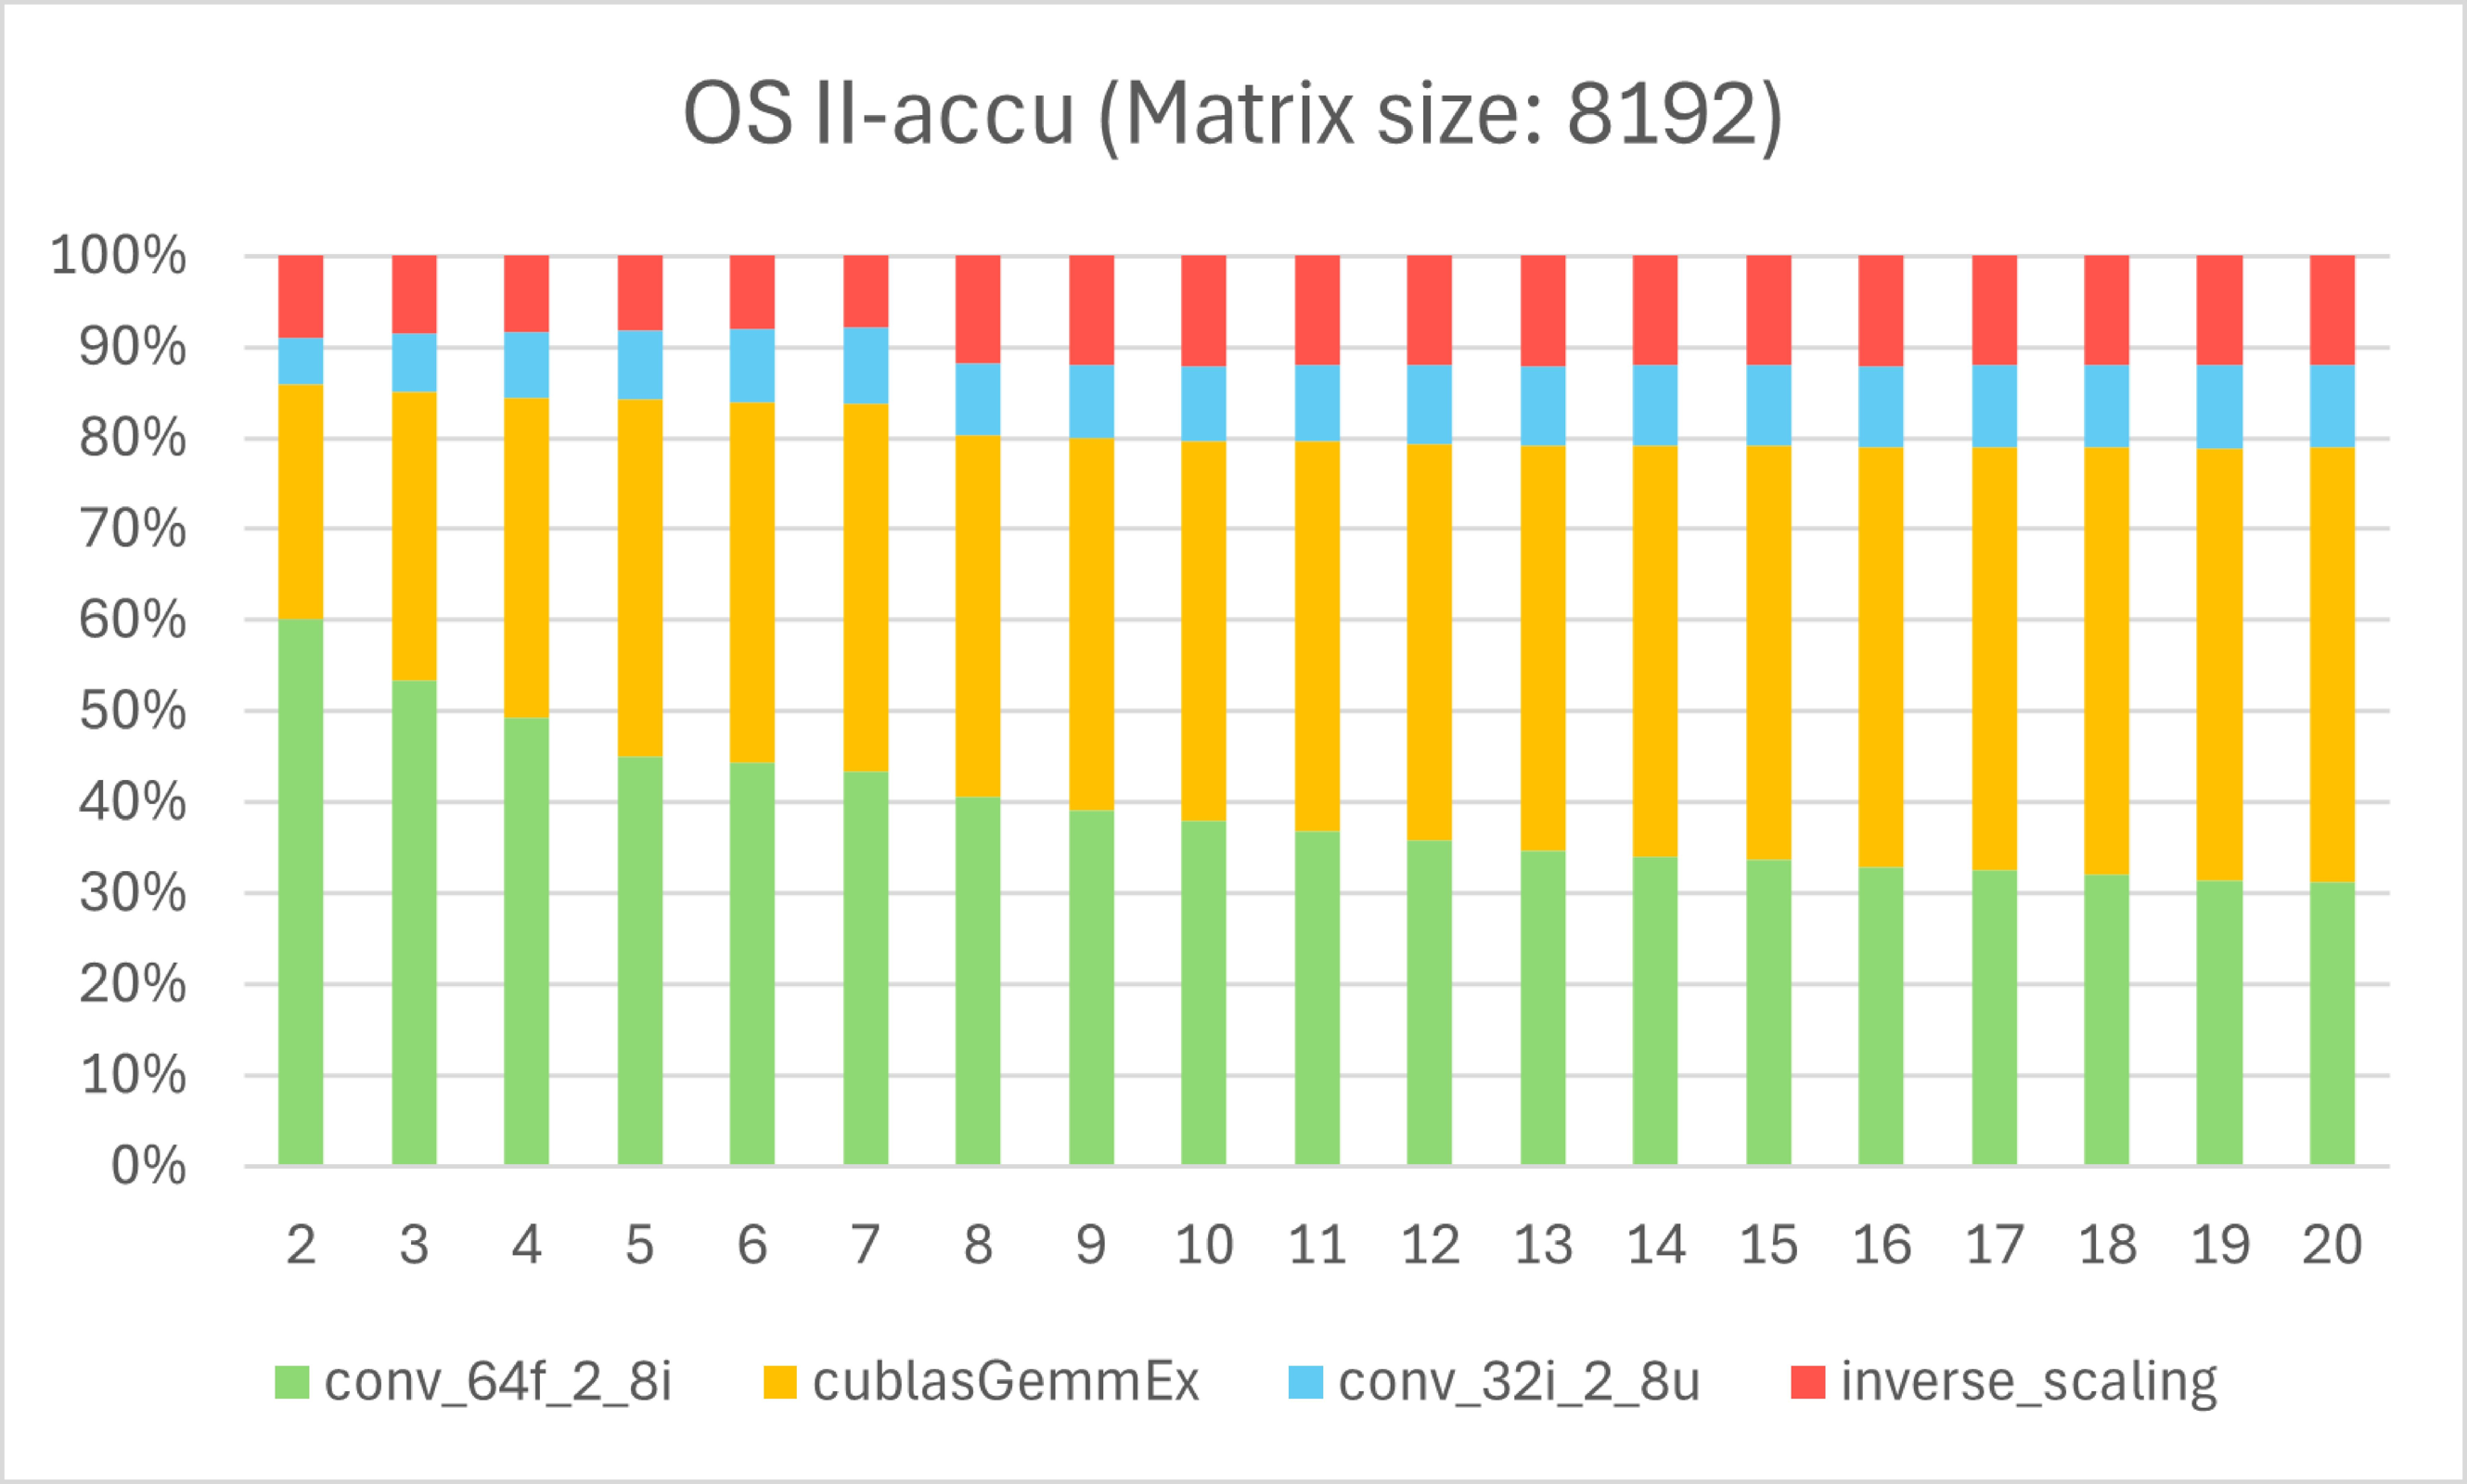
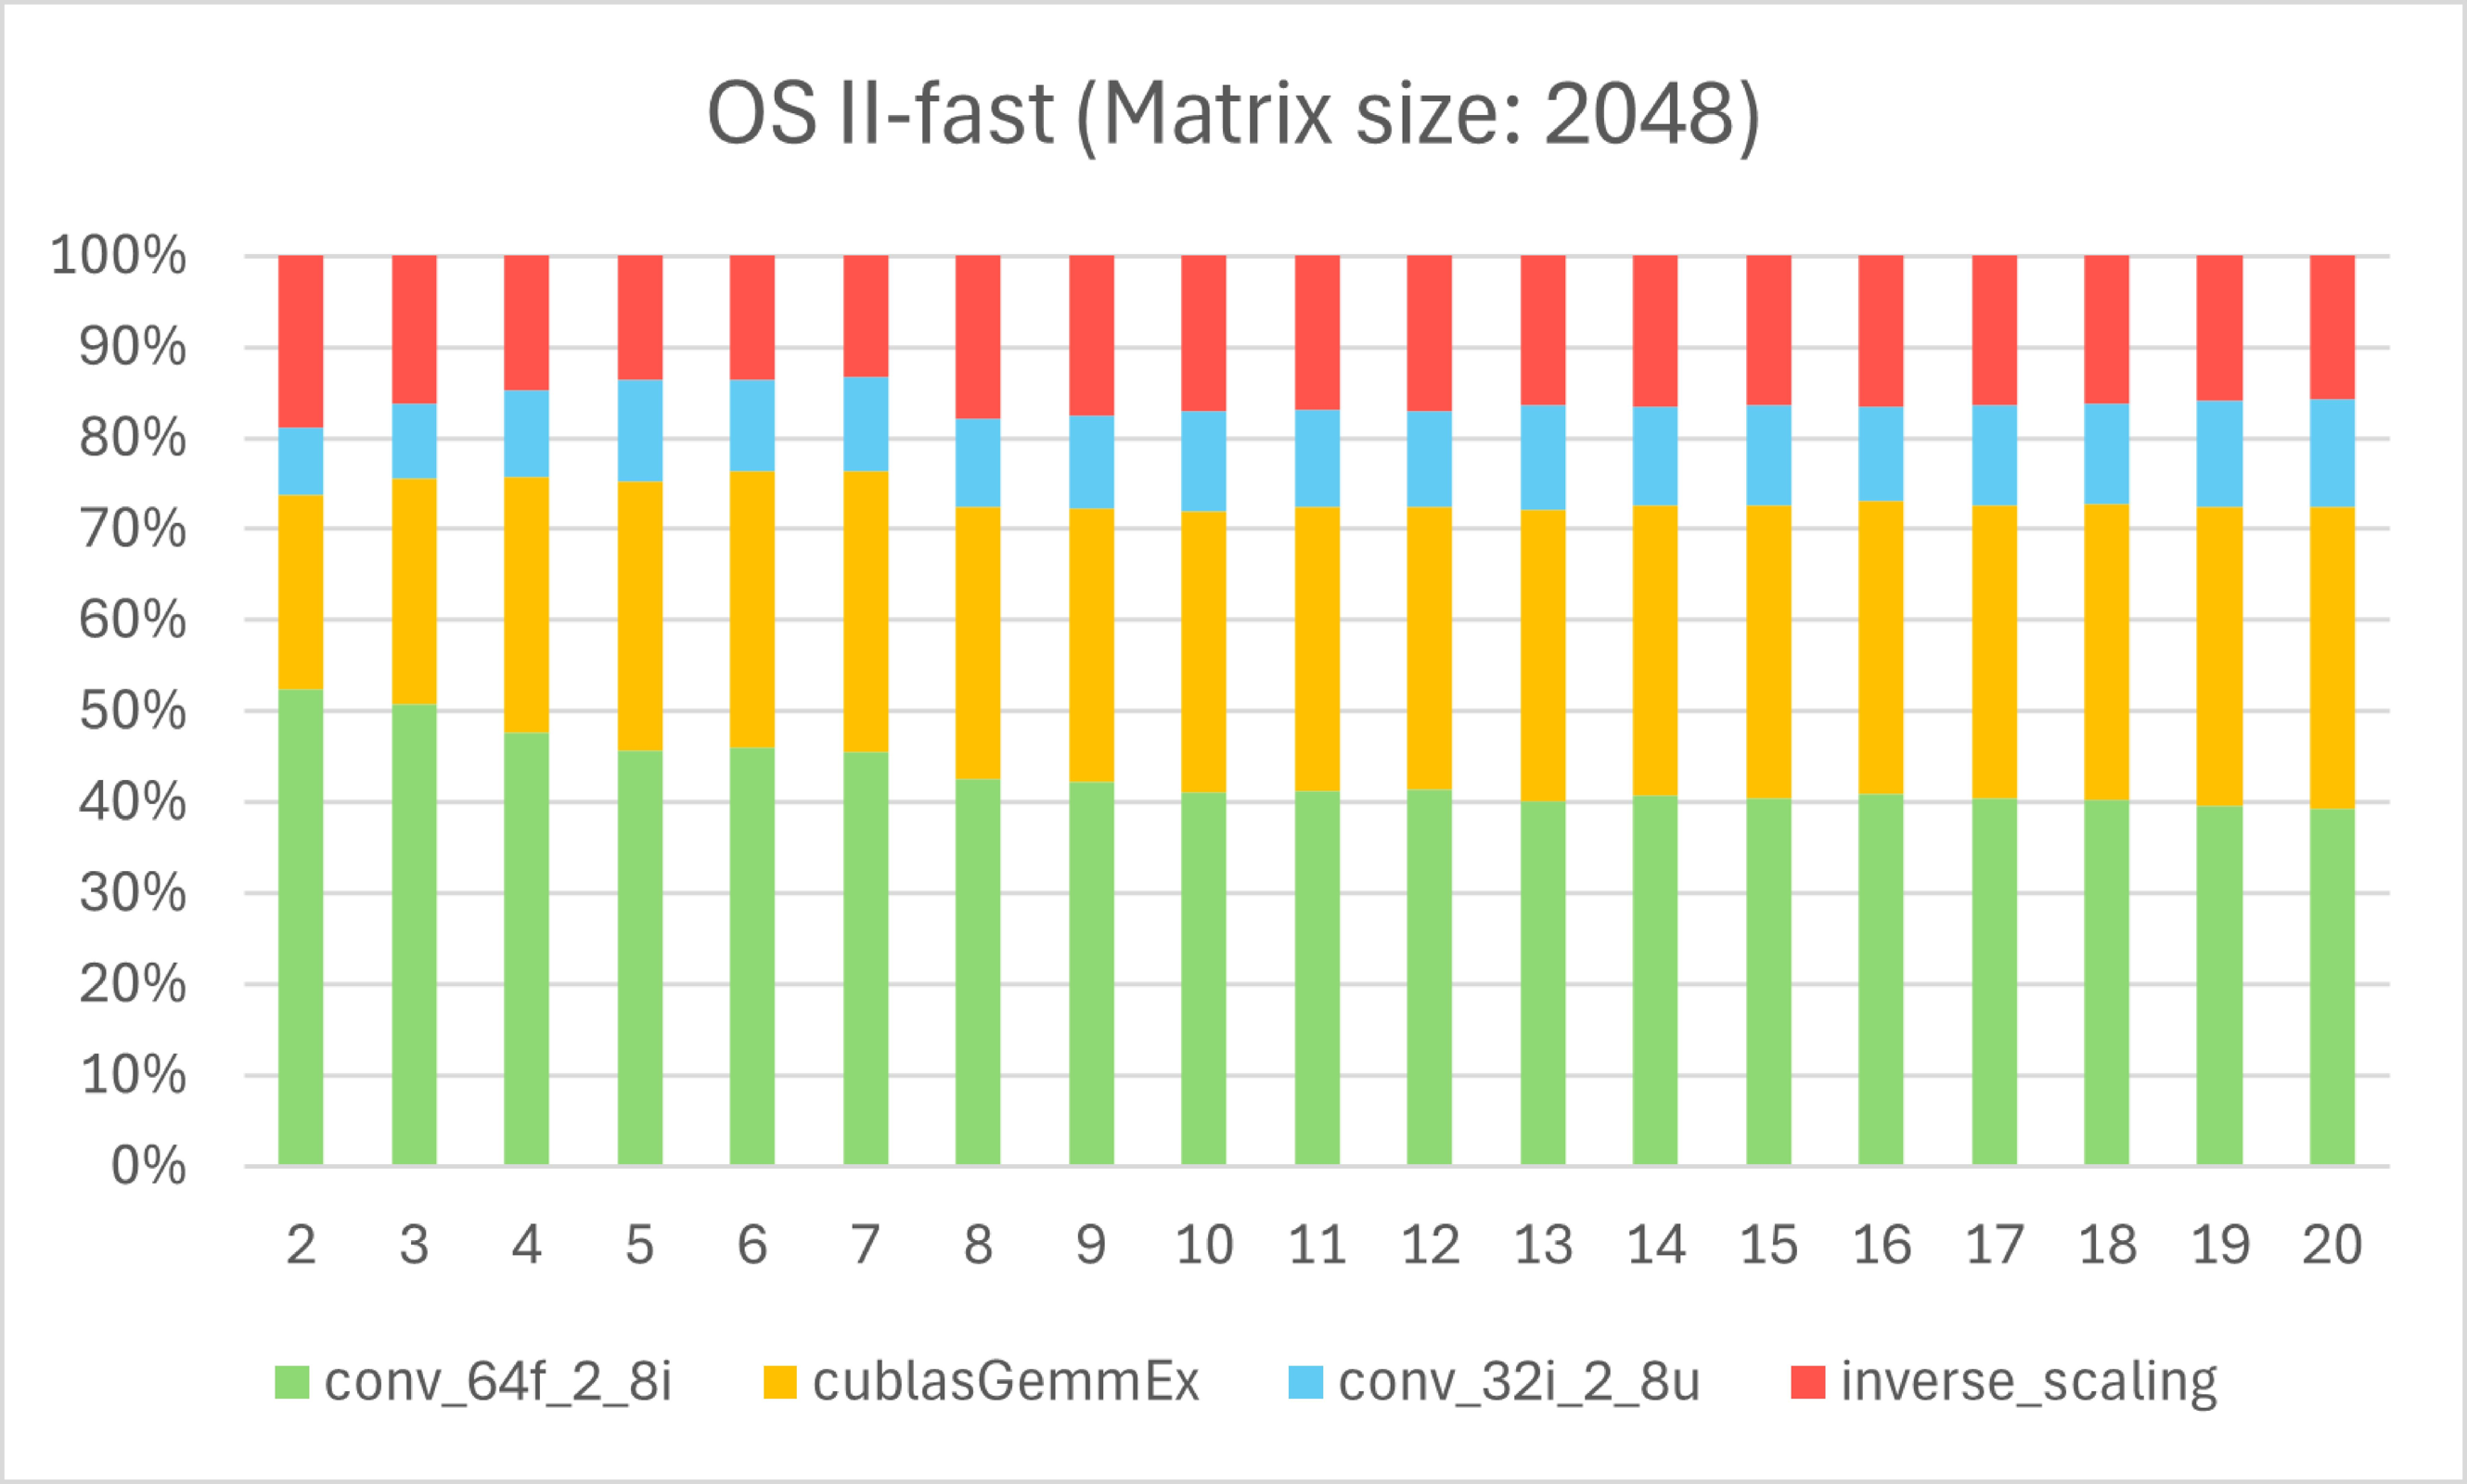
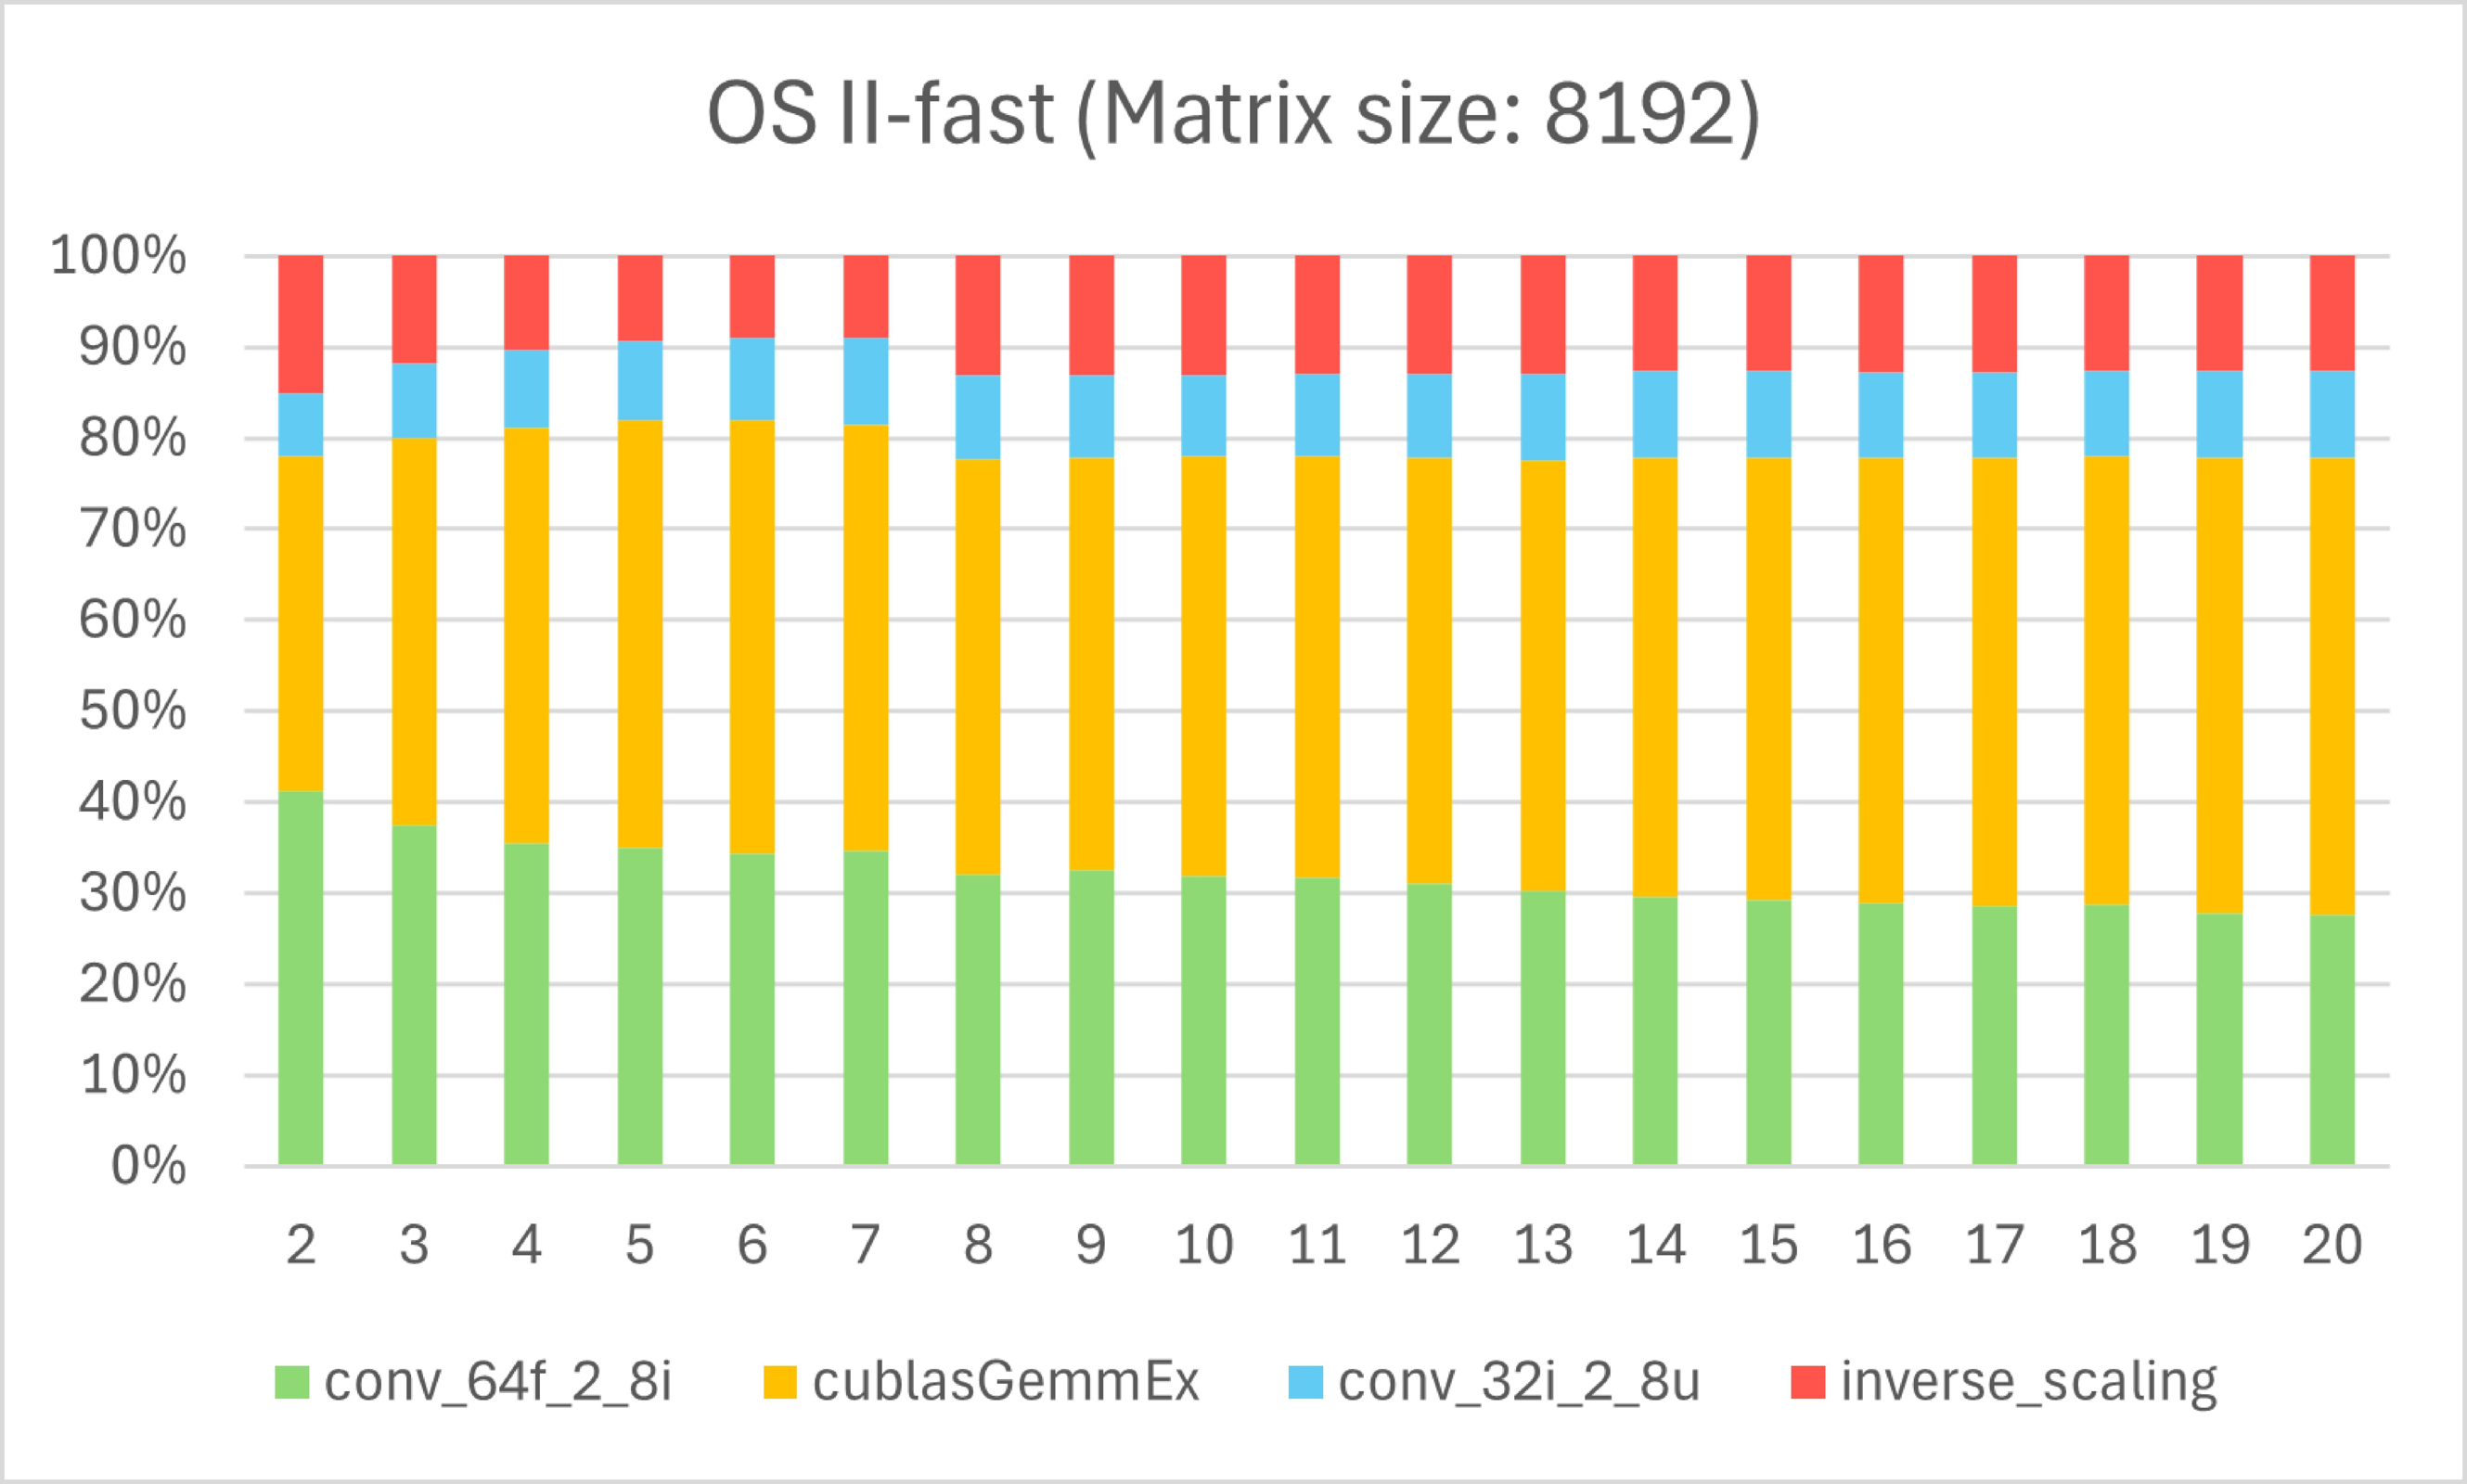
以上均为论文原图,来源:Fig. 6、7。每根柱子归一化到 100%,横轴是模数数量。
Fig. 6 中,GH200 从 1024 阶变为 16384 阶后,主 GEMM 占比明显提高,尤其是 fast;小规模时显著的前后处理更容易被摊薄。accu 的绿色仍然更重,因为其中还藏着一次估界乘法。
Fig. 7 中,RTX 4090 从 2048 阶增大到 8192 阶,也出现黄色占比增加的趋势,但绿色转换与红色重构仍然显著。这与 Table 4 的高加速比并不矛盾:其原生 FP64 基线较弱,即使模拟流程存在额外成本,也可能明显胜出。两张图的尺寸不同,不能直接把相同位置的柱子当作同规模的 GPU 对比。
这些图说明,GEMM 之外的工作不能忽略。它们也有一个局限:百分比只告诉我们时间花在哪里,不解释为什么。绿色占比下降时,它的绝对时间仍可能增加;绿色中出现 GEMM,也意味着按颜色直接判断复杂度会出错。
绿色内部的操作与执行资源,继续见正文 Part II。