
Ozaki II 性能剖析:为什么预处理也能比矩阵乘法更贵?
Oct 1, 2026
TL;DR
- Ozaki II 花若干次非常快的整数矩阵乘法(INT8),替代了一次较慢的双精度矩阵乘法(FP64),在主乘法已经交给 INT8 Tensor Core 的情况下,准备输入的时间反而变得更长,甚至在不少情况下接近甚至超过了主GEMM,本文对其原因进行了探究。
- 预处理的大头是取模生成多组整数余数。 为了把高精度输入交给多路 INT8 矩阵乘法,每个输入元素都要按不同模数反复取余。在我们测试的大矩阵、多模数配置中,这一步占据了预处理的大部分时间。
- 生成 INT8 余数,仍然要付出 FP64 运算的成本。 源码和汇编表明,每次取余都需要多条浮点指令;H20 上的硬件指标也显示,预处理所用的普通 FP64 运算单元已经接近饱和。主 GEMM 则使用吞吐高得多的 INT8 Tensor Core,因此预处理即使计算量更少,也可能花费相近甚至更多的时间。
- 进一步加速,需要关注生成输入的成本。 主 GEMM 越快,预处理在总耗时中就越难忽略。我们的分析指向一个具体优化方向:在保证余数正确的前提下,减少生成多路 INT8 输入所需的 FP64 运算,并用完整流程的耗时检验收益。
Part I 目标:用大吞吐低精度矩阵乘模拟高精度矩阵乘
1 用多路 INT8 矩阵乘法完成一次高精度计算
设 、,目标是 。 是每个输出内积的长度;方阵实验里 。Ozaki II 选择 个两两互素的小模数 ,记 ,用各路余数共同表示缩放后的整数输入。[1]
先根据乘积上界选择对角缩放矩阵 、,其对角元素均为正的二次幂。左乘 缩放 A 的每一行,右乘 缩放 B 的每一列。Ozaki II的整个操作流程大概如下表所示,其中 标记对应模数的计算分支:
| 阶段 | 操作与公式 | 后文图片中颜色表记 |
|---|---|---|
| 输入预处理 | 估界并确定 ,再缩放并向零截断:,。 生成 INT8 余数:,。 | 绿色 |
| 主矩阵乘法 | ,使用 INT8 × INT8 → INT32 GEMM。 | 黄色 |
| 输出取余 | ,逐元素得到非负余数。 | 蓝色 |
| 合并与逆缩放 | 合并各路余数:。 恢复原尺度:。 | 红色 |
这里 表示逐元素取零附近的对称余数; 表示通过中国剩余定理逐元素重构到 。缩放需要保证 ,这样在精确算术下,重构得到的就是 。最终用 表示近似结果,因为输入整数化与实际重构仍可能引入误差。
低精度核心能够精确计算,依赖两个范围条件。 每个模数不超过 256,取零附近的对称余数后,输入能放入 INT8 的 。每项乘积的绝对值至多为 ,因此
是 INT32 累加不溢出的充分条件;它也约束中间部分和。范围内的整数乘加是精确的,但完整 FP64 结果仍受输入截断和重构误差影响。论文 §3.1[1]
个模数就需要 次主 GEMM。模数越多,可恢复范围越大,通常能保留更多输入信息,但每多一路,都要增加输入取余、GEMM 和输出处理。后文 fast-14、accu-14 中的 14 都指主计算使用 14 个模数。
2 fast 与 accu 如何取舍估界成本和精度
缩放要在两个要求之间取舍:放大得足够多,减少整数化丢失的信息;又不能让整数乘积超出可恢复范围。 因而,在主乘法之前,必须先估计每个输出的绝对值上界。
fast 用行、列范数估界。 由 Cauchy–Schwarz 不等式,
它只需扫描 A 的行、B 的列,成本为 。这个界忽略元素的配对位置:两侧的大元素即使错开,范数仍然可能很大,导致缩放过于保守。
accu 多做一次 INT8 GEMM 来估界。 它将绝对值输入缩放并向上量化成 INT8 矩阵,保证还原尺度后逐项不小于原绝对值,再用它们的乘积建立上界。这保留了对应位置的关系,通常能减少过度估计,从而在同一模数预算下保留更多信息;具体效果仍取决于数据和量化。
对后面的性能分析,关键是这笔额外工作的位置:accu 的估界输入转换、一次估界 GEMM 和结果归约,全都计入绿色预处理。 因此绿色并非全是逐元素操作,accu 还含有一次 的矩阵乘法。论文中的两种估界[1]
3 主乘法加速之后,预处理成为一笔不小的成本
论文用 NVIDIA 的矩阵运算库 cuBLAS 中的原生 DGEMM(双精度矩阵乘法)作为基线。下面摘取两张 GPU 上的代表性结果,单位为有效 TFLOPS:用最终任务的 除以完整计算耗时,而非内部 路 GEMM 的总运算量。
| GPU / 方阵阶数 | 原生 DGEMM | fast-14 | accu-14 | fast-18 | accu-18 |
|---|---|---|---|---|---|
| GH200 / 16384 | 60.9 | 80.2 | 71.1 | 62.6 | 56.6 |
| RTX 4090 / 8192 | 0.62 | 9.81 | 9.23 | 7.83 | 7.41 |
来源:论文的 GPU 吞吐测试(Table 3、4[1])。完整尺寸与模数配置见补充图表。
fast-14 在这两个配置上分别达到原生 DGEMM 的约 1.32× 和 15.8×。差异与硬件的吞吐比例有关:论文列出的 GH200 稠密 INT8 Tensor / FP64 Tensor 峰值分别为 1979 TOPS / 67 TFLOPS;RTX 4090 的 INT8 Tensor / 普通 FP64 峰值则为 660.6 TOPS / 1.29 TFLOPS。RTX 4090的原生 FP64 吞吐相较于GH200弱得多。论文硬件规格[1]此外,同尺寸、同模数数量下 fast 均快于 accu,增加模数会降低吞吐。
再看两组大矩阵的阶段占比:
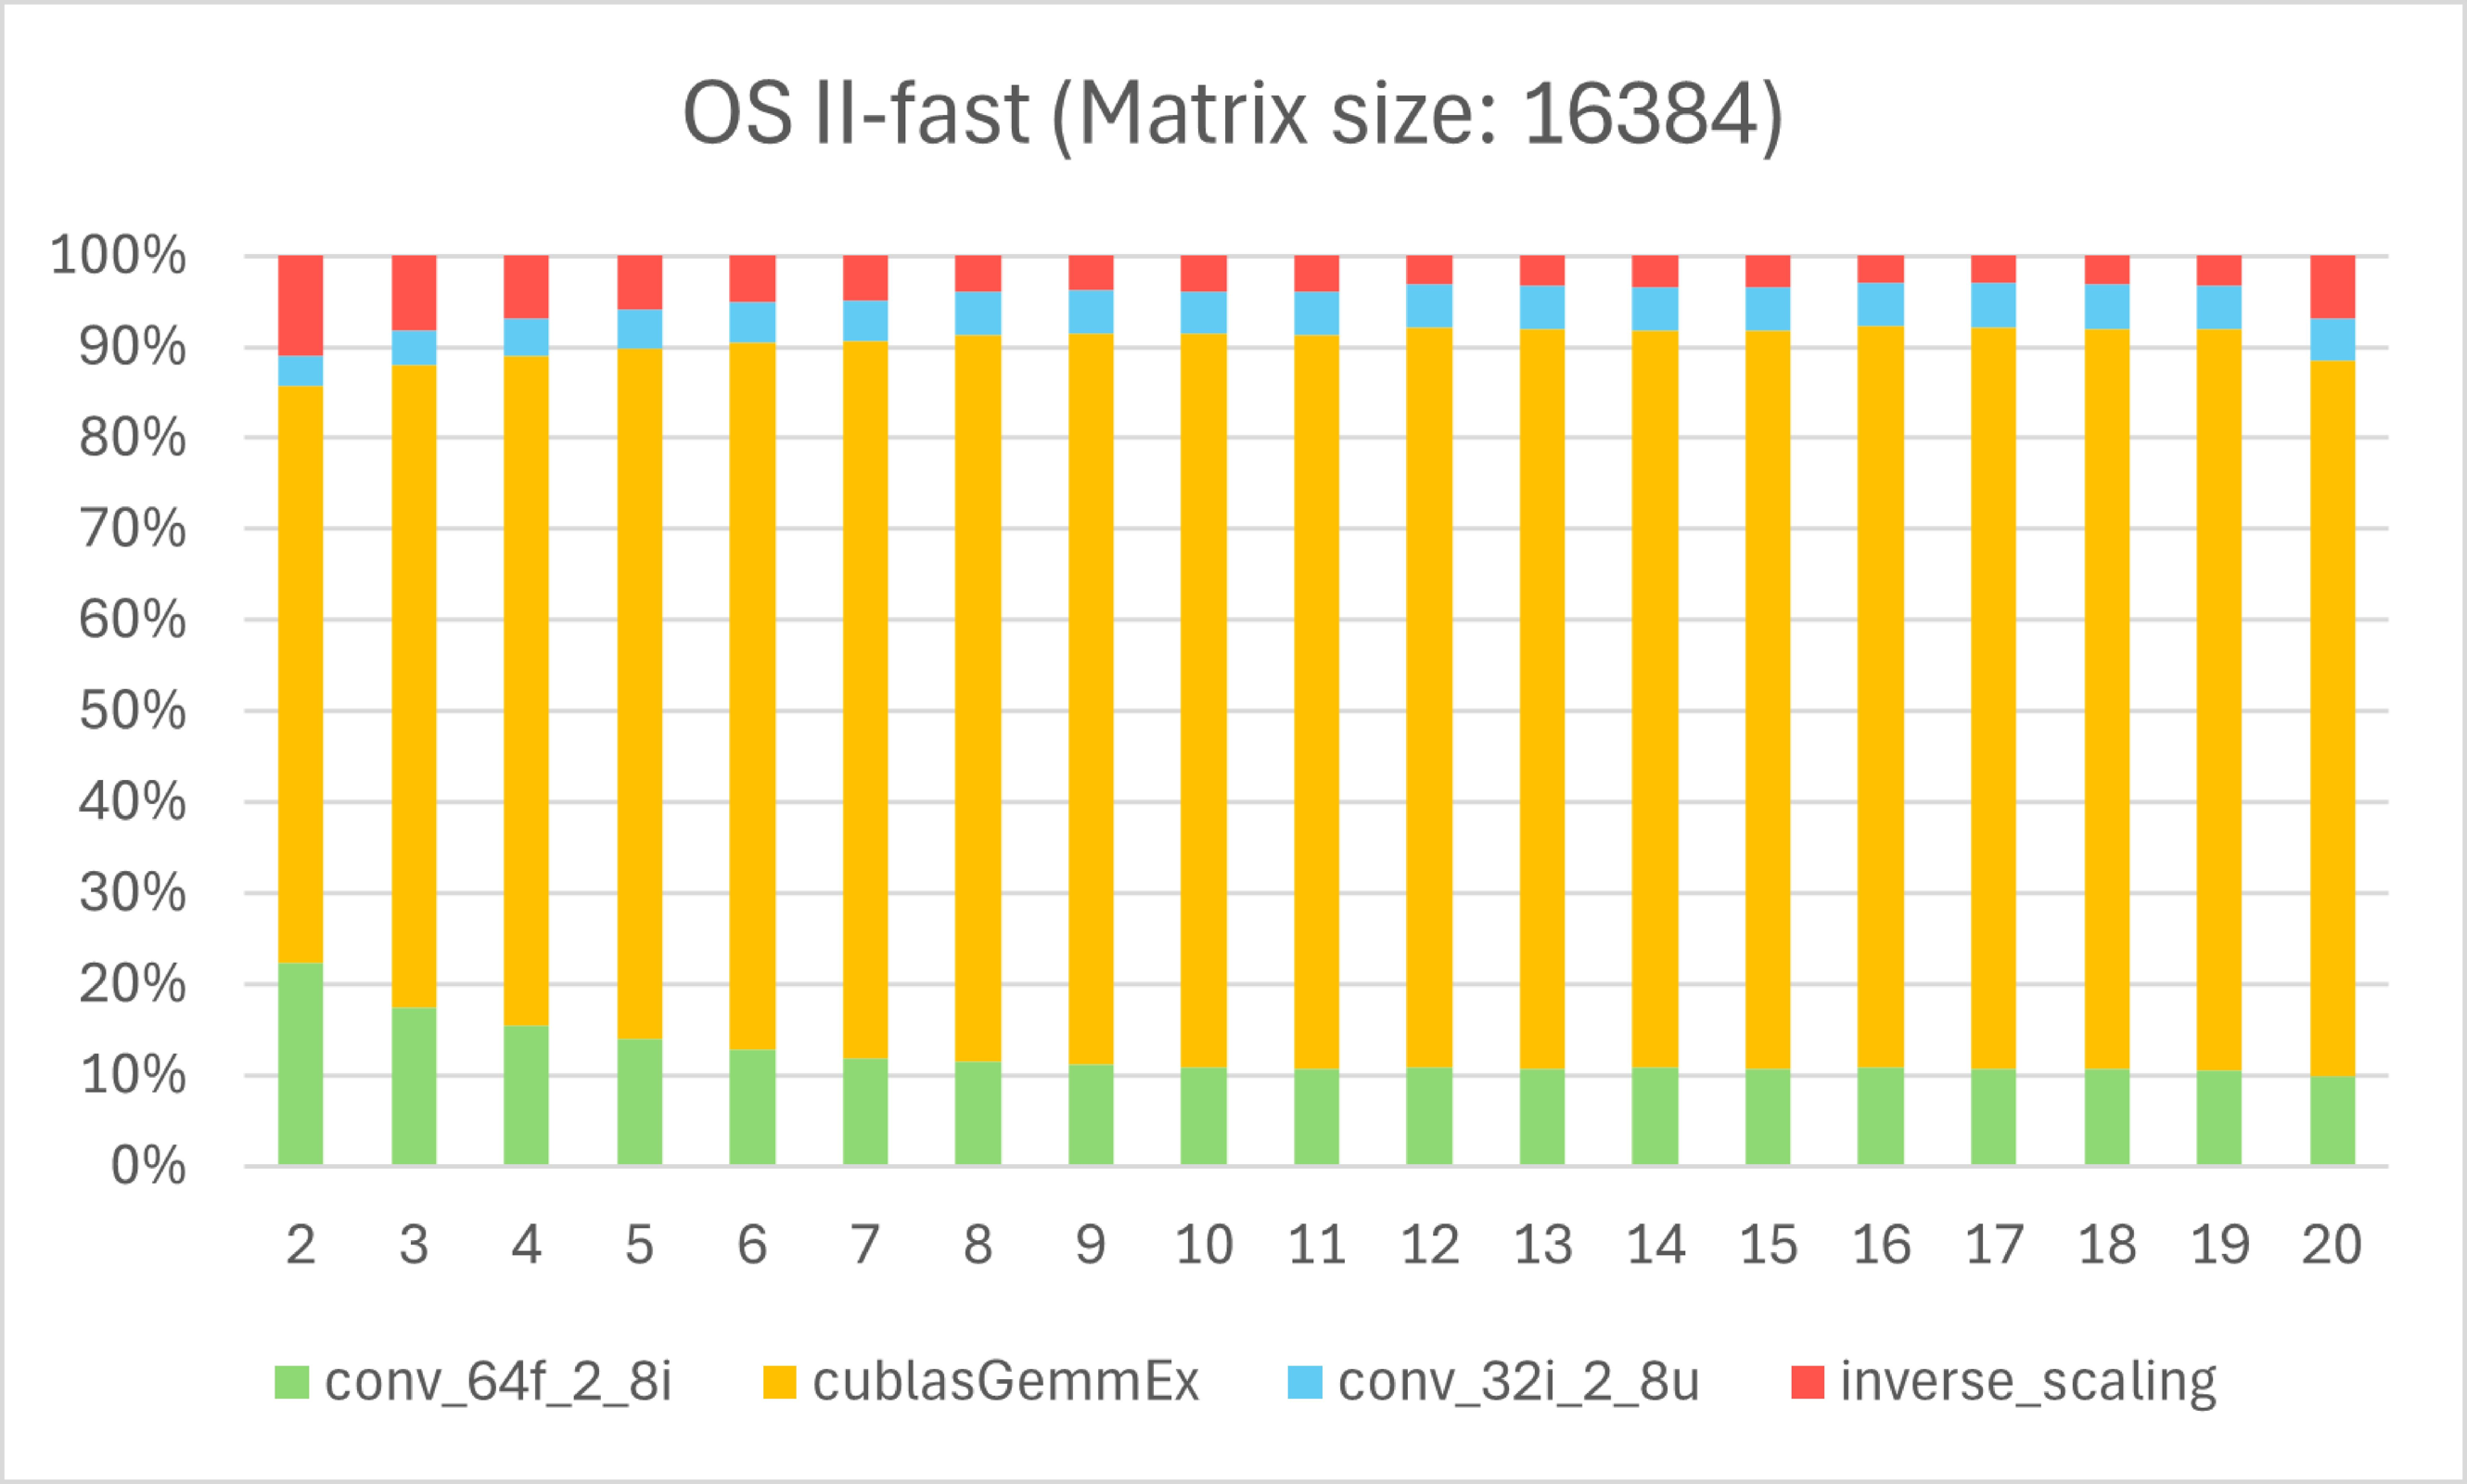
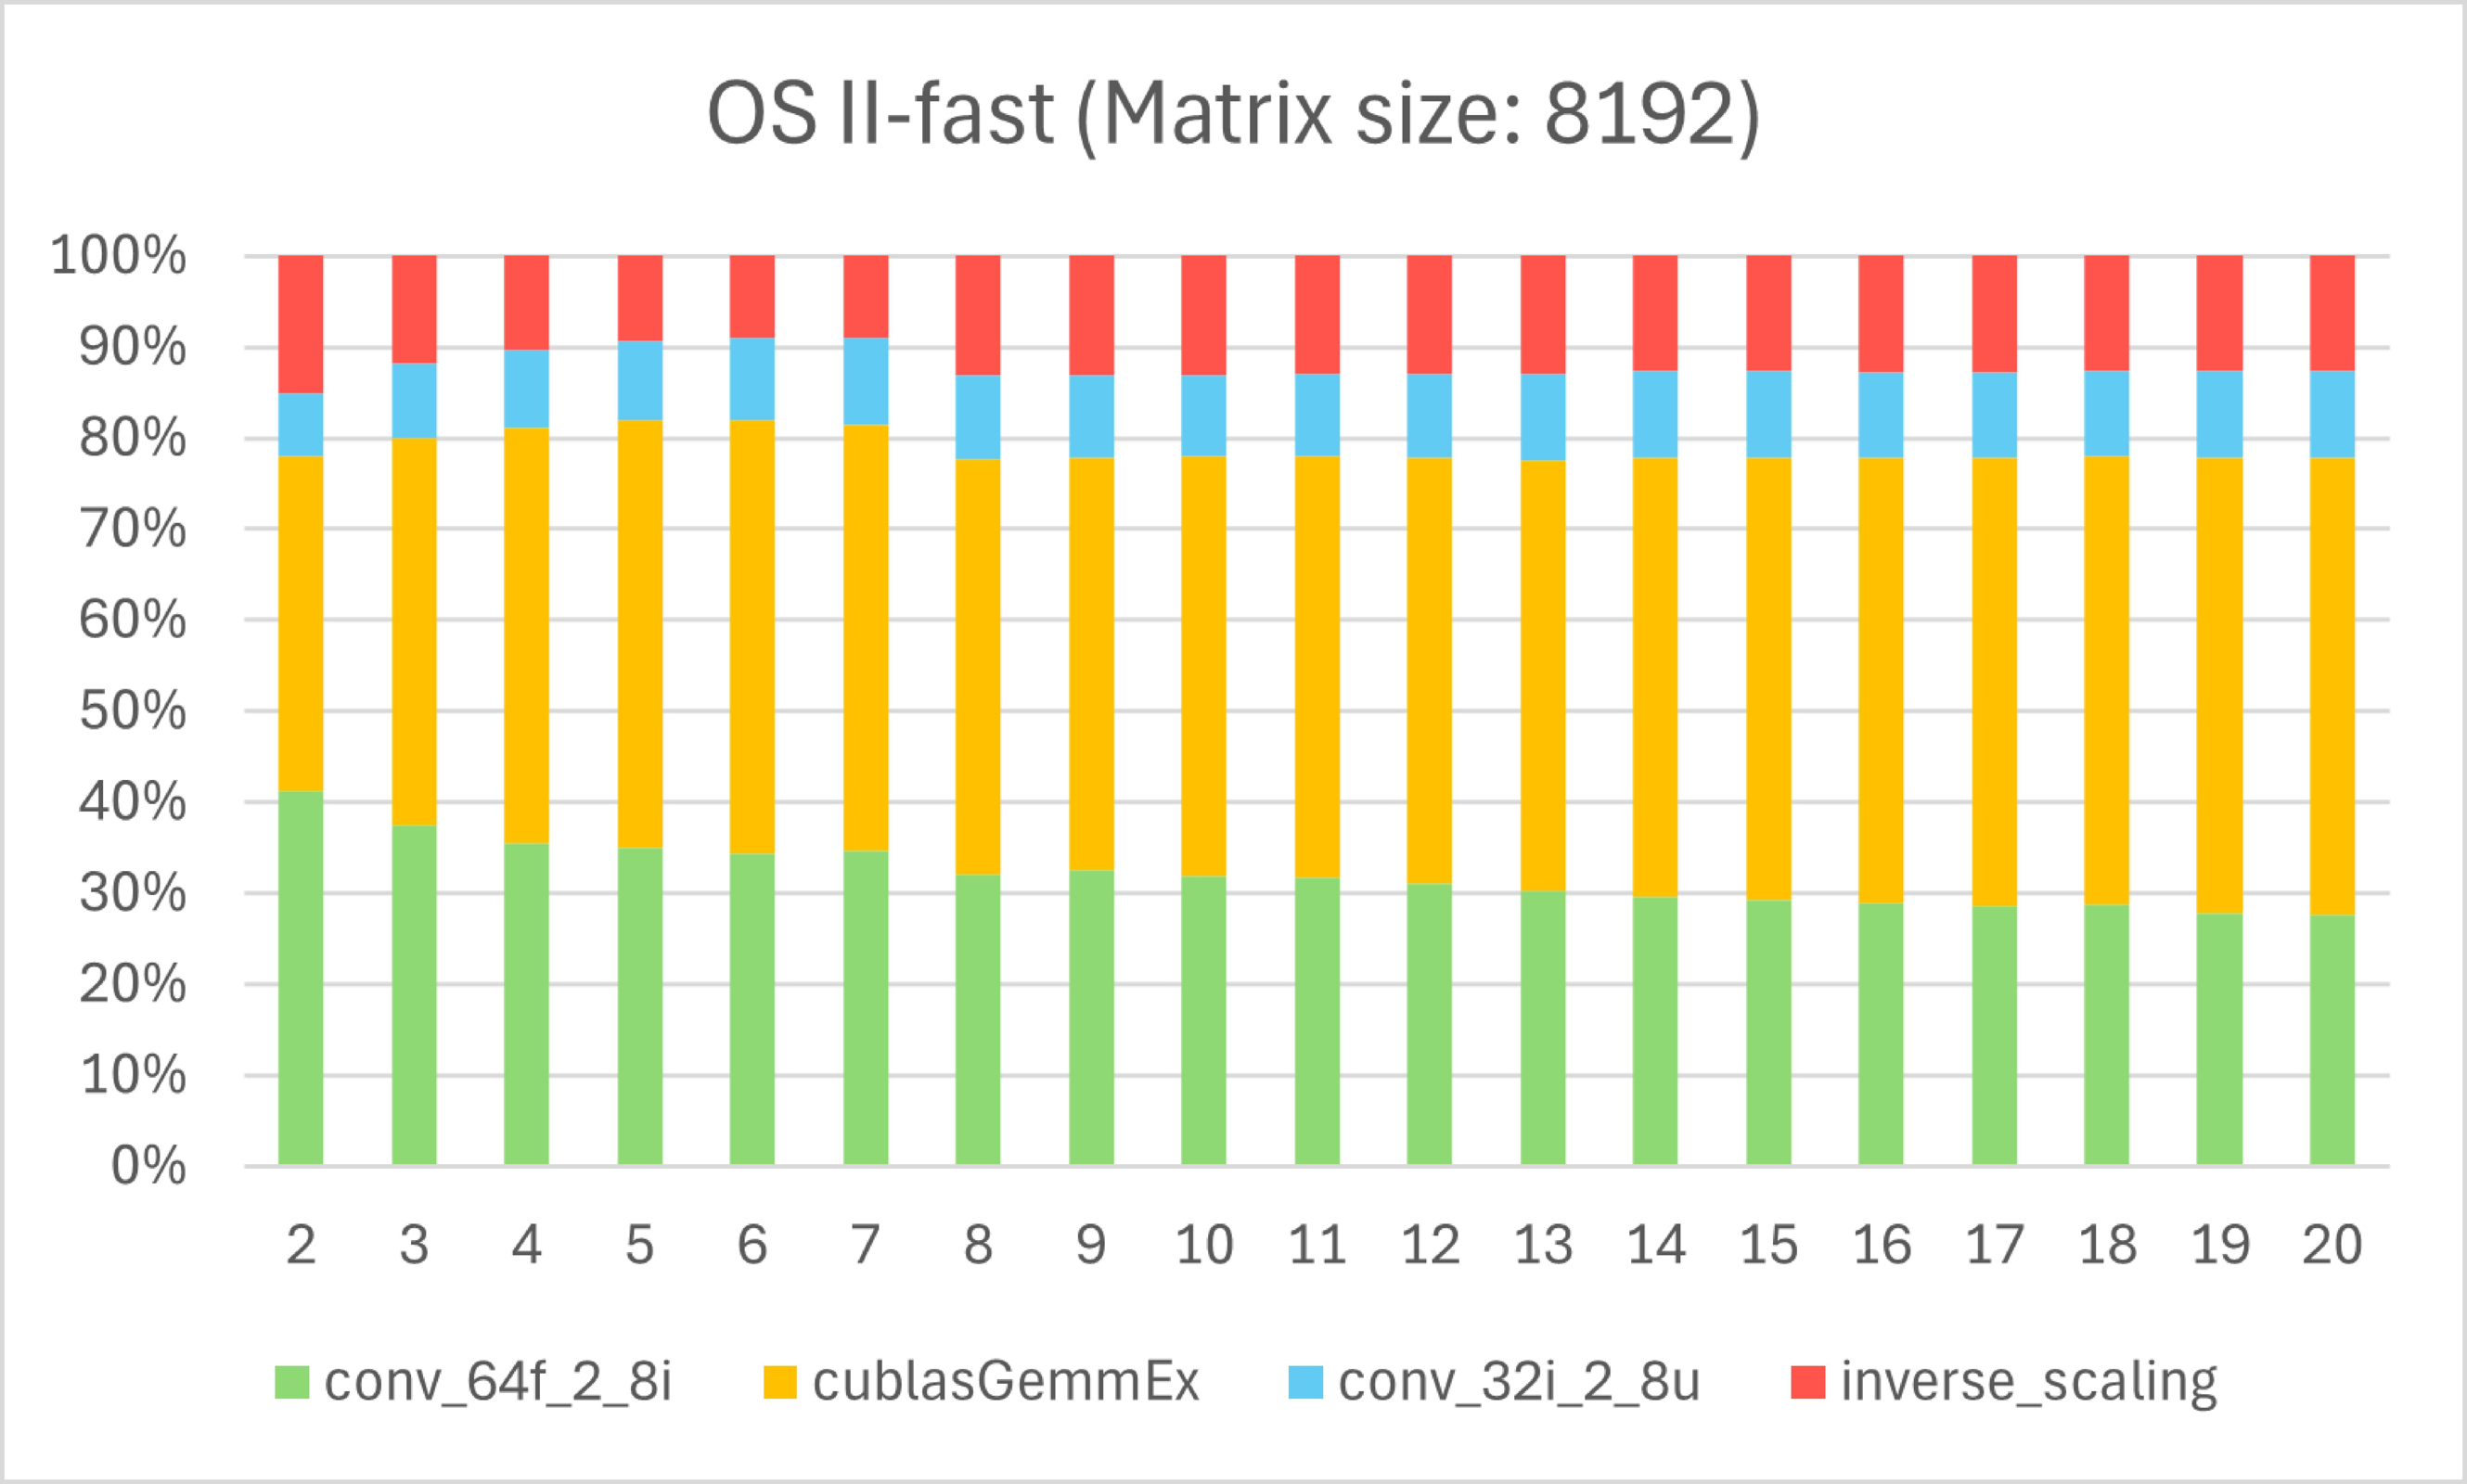
左图为 GH200,右图为 RTX 4090;窄屏按上下排列。横轴是模数数量,每根柱子归一化为 100%;颜色与 §1 的流程表一致。摘自论文 Fig. 6(d)、7(d)[1],两图尺寸不同,只显示相对速度而非绝对速度。
从图中我们看到,规模增大时主 GEMM 占比通常提高,但即使主 GEMM (黄色)已占大头,预处理(绿色)仍然是一笔显著的开销。我们在 H20 设备上用profiling工具对这个问题进行了详细的探究:先从耗时角度测量,再用复杂度、硬件计数器和机器指令逐层进一步分析解释。
Part II 思考:对Ozaki II方法Profiling的进一步分析
4 在H20-3e上的复现实验
我们采取的第一步是先把耗时搞清楚,预处理(绿色)有多大开销,哪些尺寸和配置下接近或超过主GEMM(黄色)?随后逐层追查其中的操作和硬件成本。
我们在单张 H20-3e上进行了复现实验,测试四种方阵规模 ,两种估界模式(fast和accu),以及模数 。每配置预热 3 次、测量 30 次。输入沿用历史代码的生成方式,、seed=123456;A/B 使用相同种子。
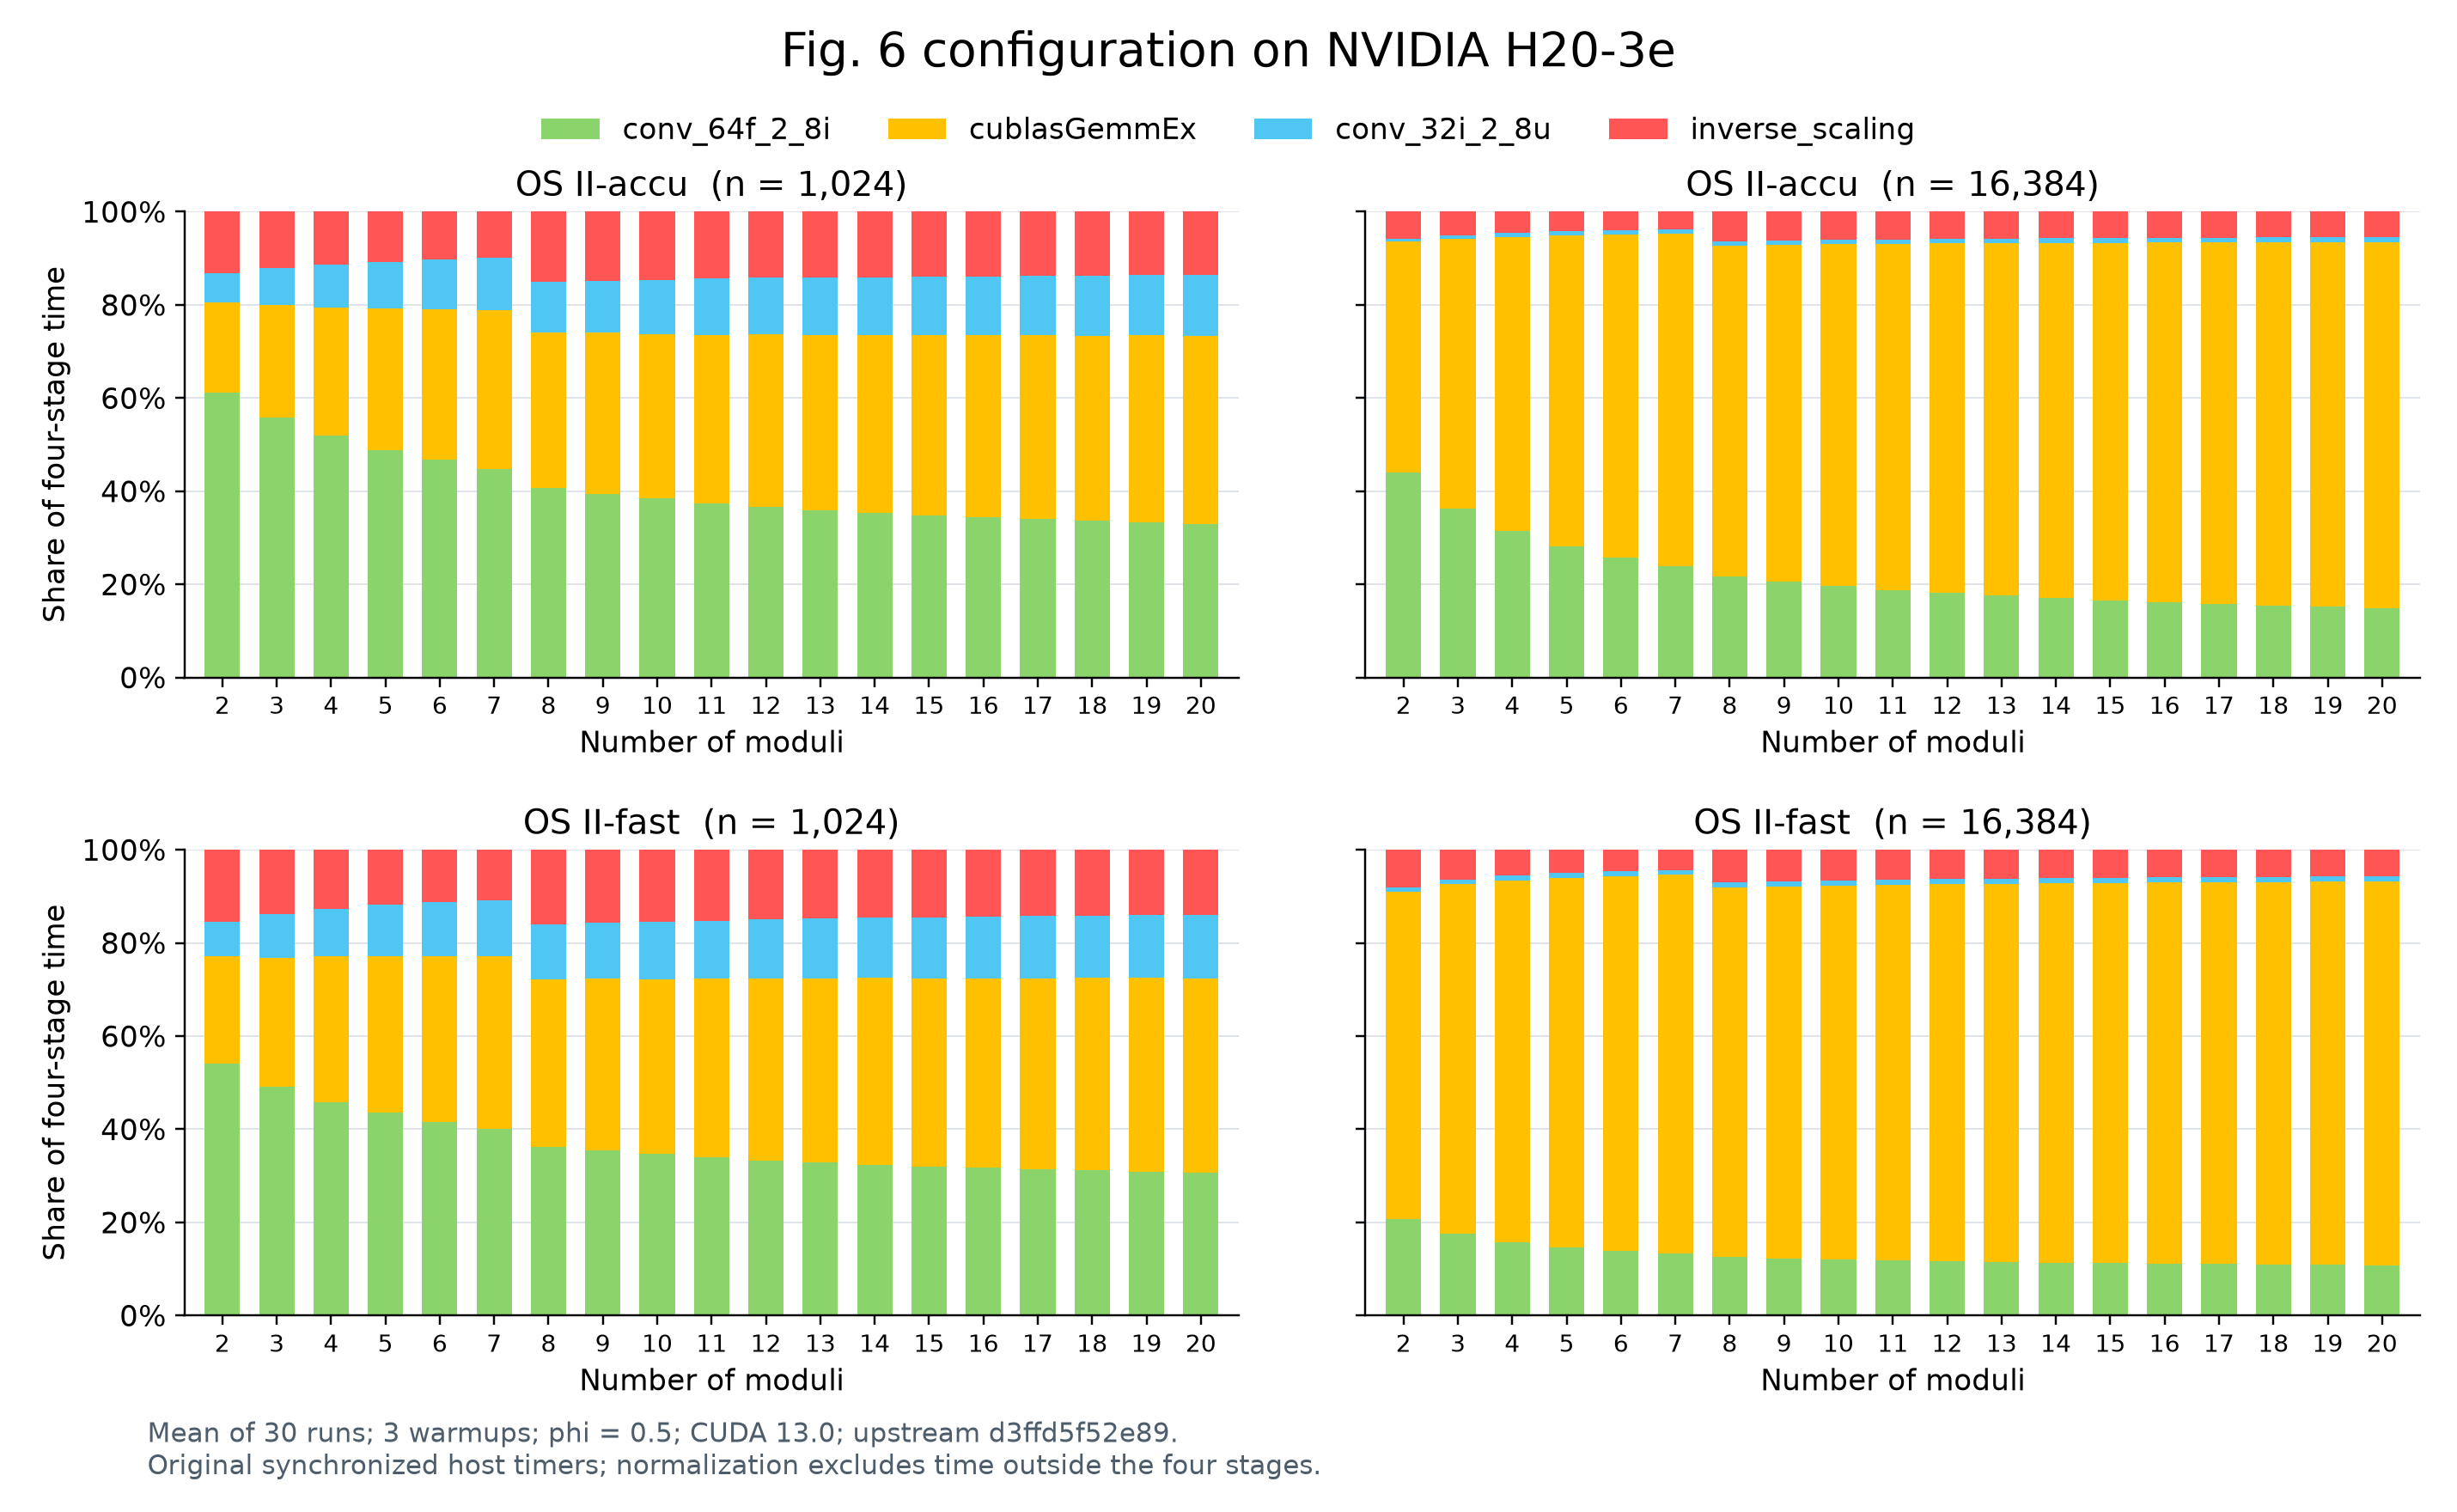
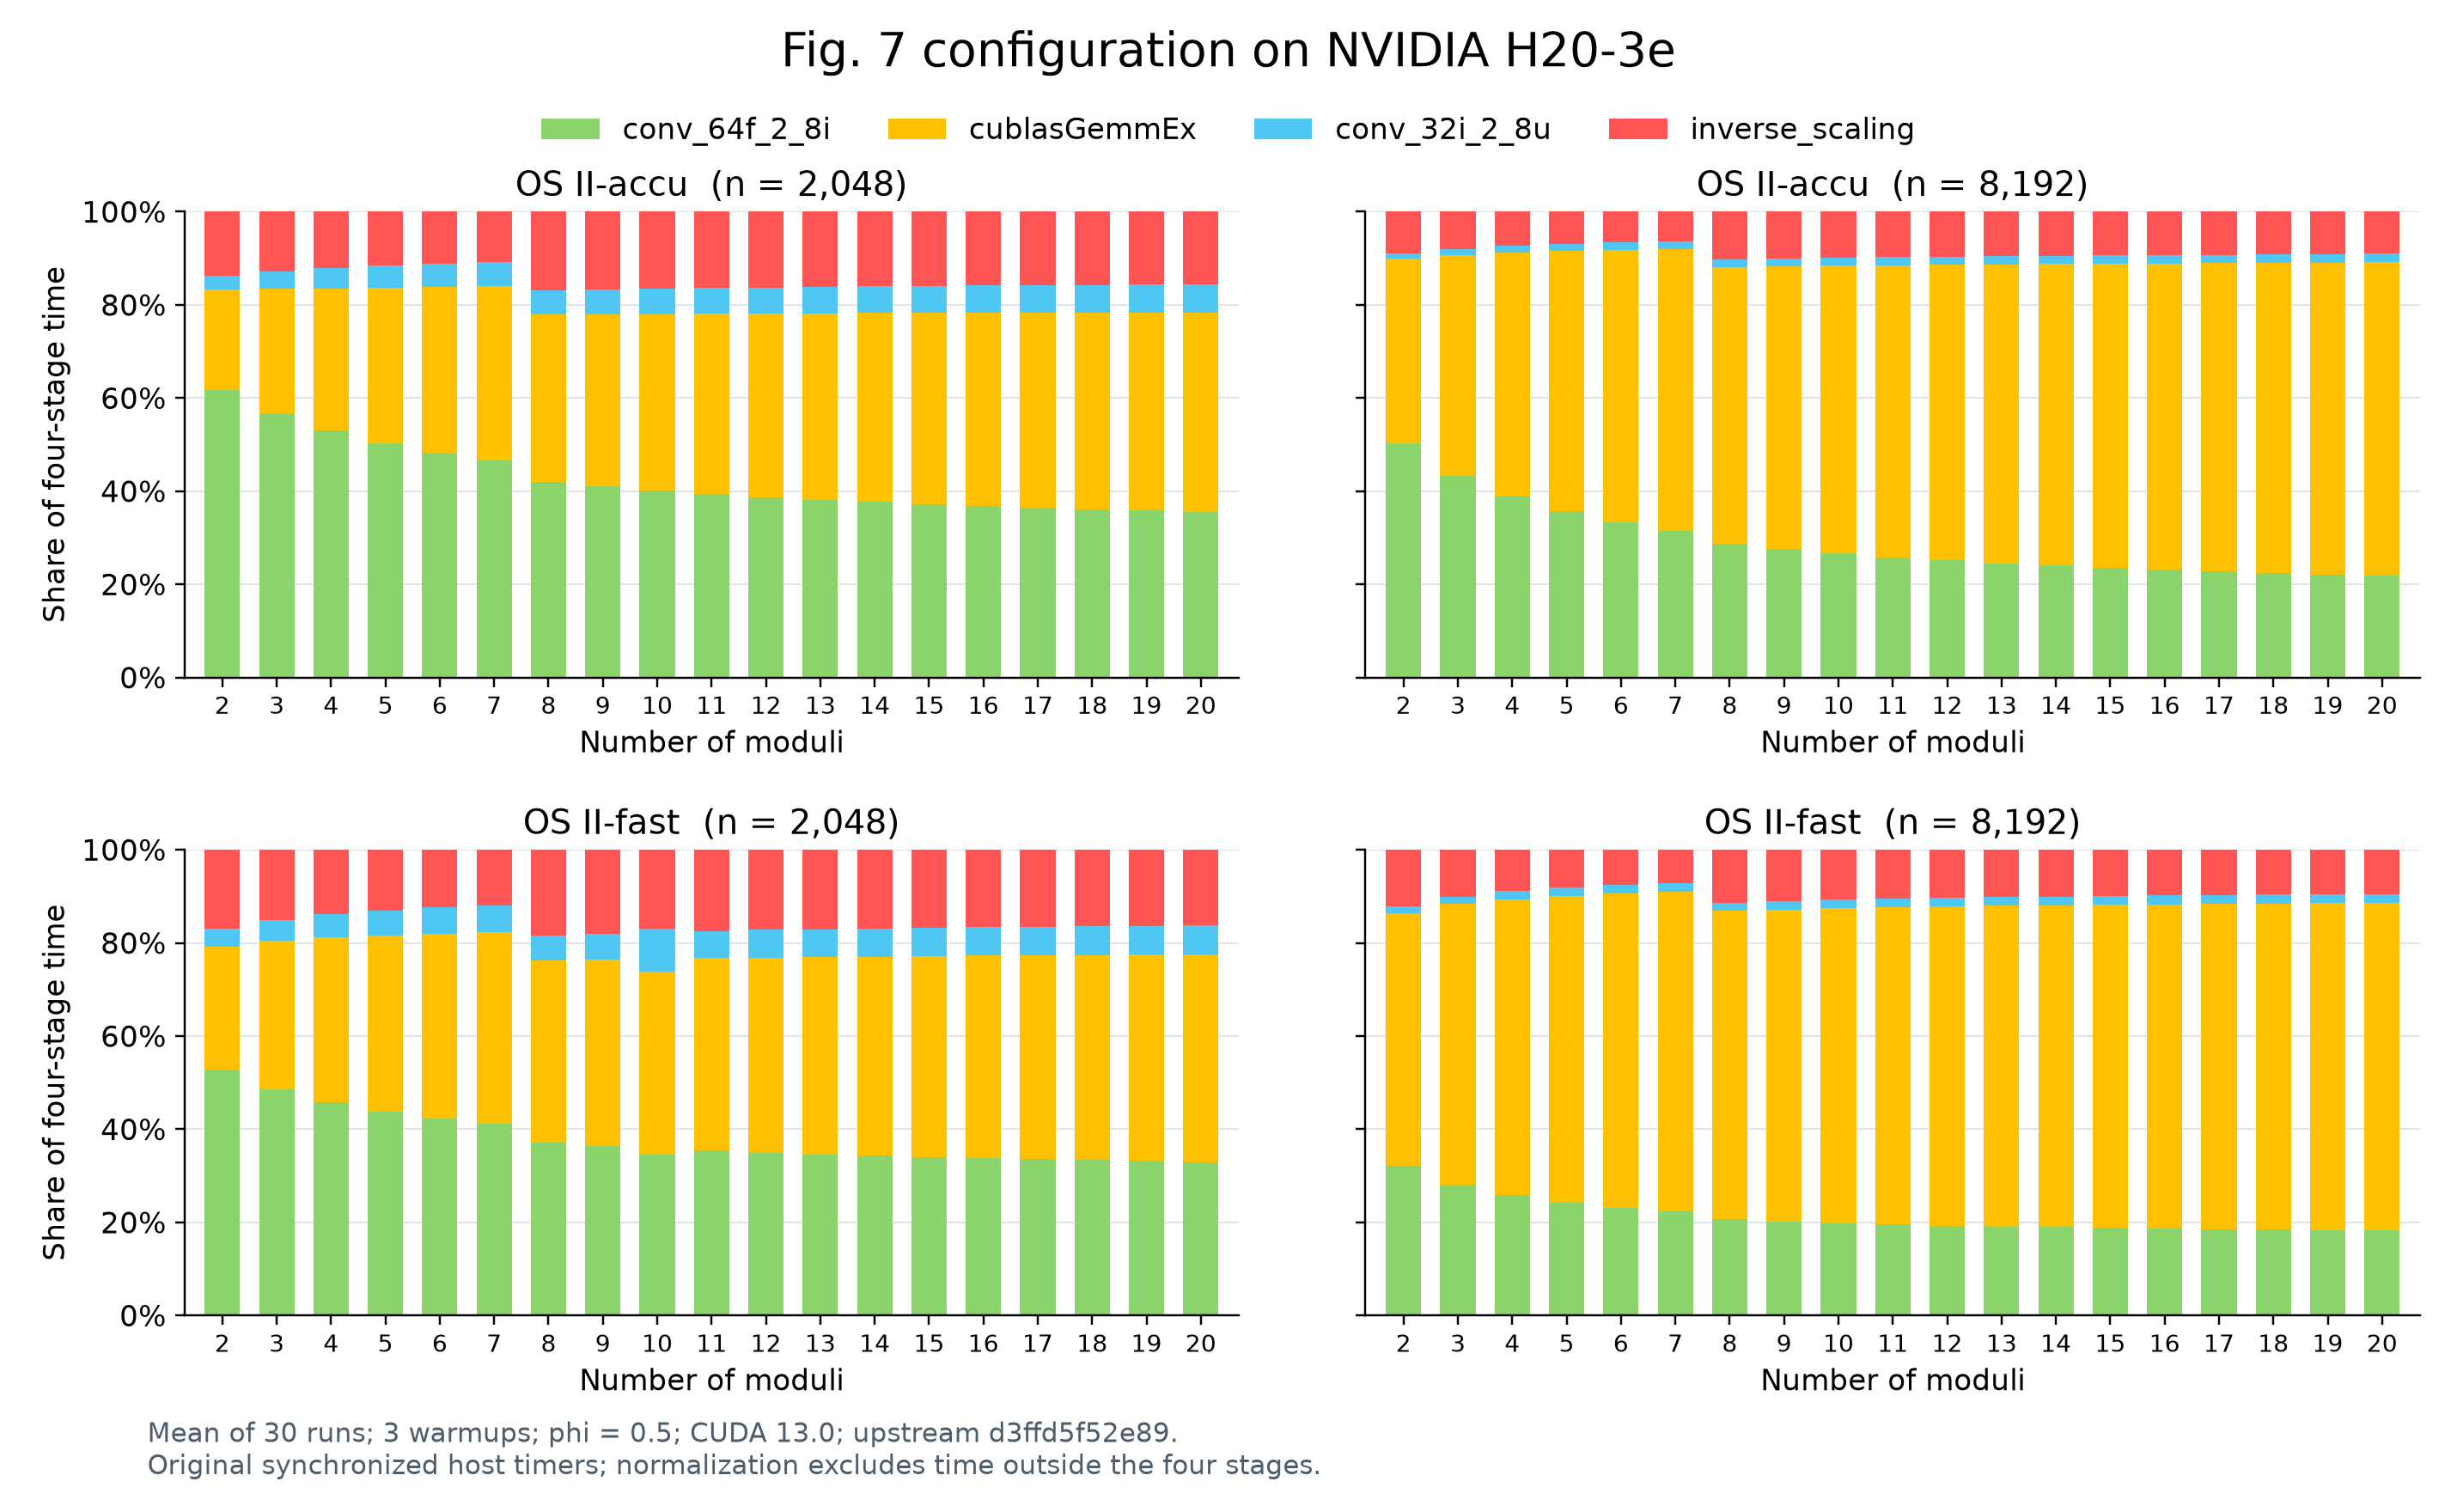
我们在 H20-3e 上测得的阶段占比。第一张沿用论文 Fig. 6 的尺寸布局,第二张沿用 Fig. 7;这两组数据是我们的复现数据而非原论文结果。
先看 fast 配置下的几个绝对时间以及占比:
| 绿色 ms | 黄色 ms | 绿色 / 黄色 | 黄色 INT8 TOPS | ||
|---|---|---|---|---|---|
| 1024 | 2 | 0.1267 | 0.05394 | 2.35 | 79.6 |
| 2048 | 14 | 1.0554 | 1.3161 | 0.802 | 182.8 |
| 8192 | 14 | 15.3937 | 55.9376 | 0.275 | 275.2 |
| 16384 | 14 | 60.5876 | 436.3535 | 0.139 | 282.2 |
在不少配置下 (例如2048 阶、14 路时),预处理几乎和全部主GEMM开销一样大。即使到 8192 阶,绿色仍占黄色的 27.5%。这正是需要解释的现象。
5 计时测量:输入预处理
5.1 输入统计决定缩放量
fast 对 A 的每一行、B 的每一列扫描最大绝对值和平方和,通过线程间数据交换(warp shuffle)、共享内存和线程块内归约,合并各线程的局部结果,得到统计量,再计算二次幂缩放指数。
这里的 statistics 是数值算法的一部分:平方和用于范数相关估界,最大值及指数用于缩放计算。它不是性能日志,也不是简单求均值。平方和与加法使用向上舍入,帮助避免把上界算小。
原始代码把这些工作与后面的缩放、截断、取余融合在两个 GPU kernel 中,分别处理 A 和 B。所谓 kernel,是很多 GPU 线程共同执行的一次函数调用;它可以包含多种操作。
fast
  A 行统计 → 缩放指数 → 缩放截断 → s 路余数
  B 列统计 → 缩放指数 → 缩放截断 → s 路余数

accu
  A/B 绝对值向上量化 → 一次估界 GEMM
  上界矩阵的行列最大值 → 最终缩放指数
原 A/B 缩放截断 → s 路余数注释:输入生成、工作区分配、主机到设备传输不在本次绿色计时内。历史实现
scaling.hpp[2]
5.2 对预处理的细致拆分计时
新增诊断版本,把最终融合内核拆为统计、缩放截断、余数生成三个阶段。保留原访问方向和线程映射,并把中间整数暂存到 FP64 数组中。三个尺寸、两种模式、两种诊断变体的全部 12 组校验,都与原实现的所有 INT8 余数和缩放指数逐项一致。
在 时,A/B 的时间合并如下:
| 诊断阶段 | fast ms | fast 占比 | accu ms | accu 占比 |
|---|---|---|---|---|
| 生成估界 INT8 输入 | — | — | 2.486 | 11.6% |
| 估界 GEMM | — | — | 4.034 | 18.8% |
| 统计与确定最终缩放 | 1.239 | 8.0% | 0.656 | 3.1% |
| 缩放、截断与中间写回 | 1.937 | 12.5% | 1.936 | 9.0% |
| 路余数生成与写回 | 12.330 | 79.5% | 12.330 | 57.5% |
| 总计 | 15.506 | 100% | 21.442 | 100% |
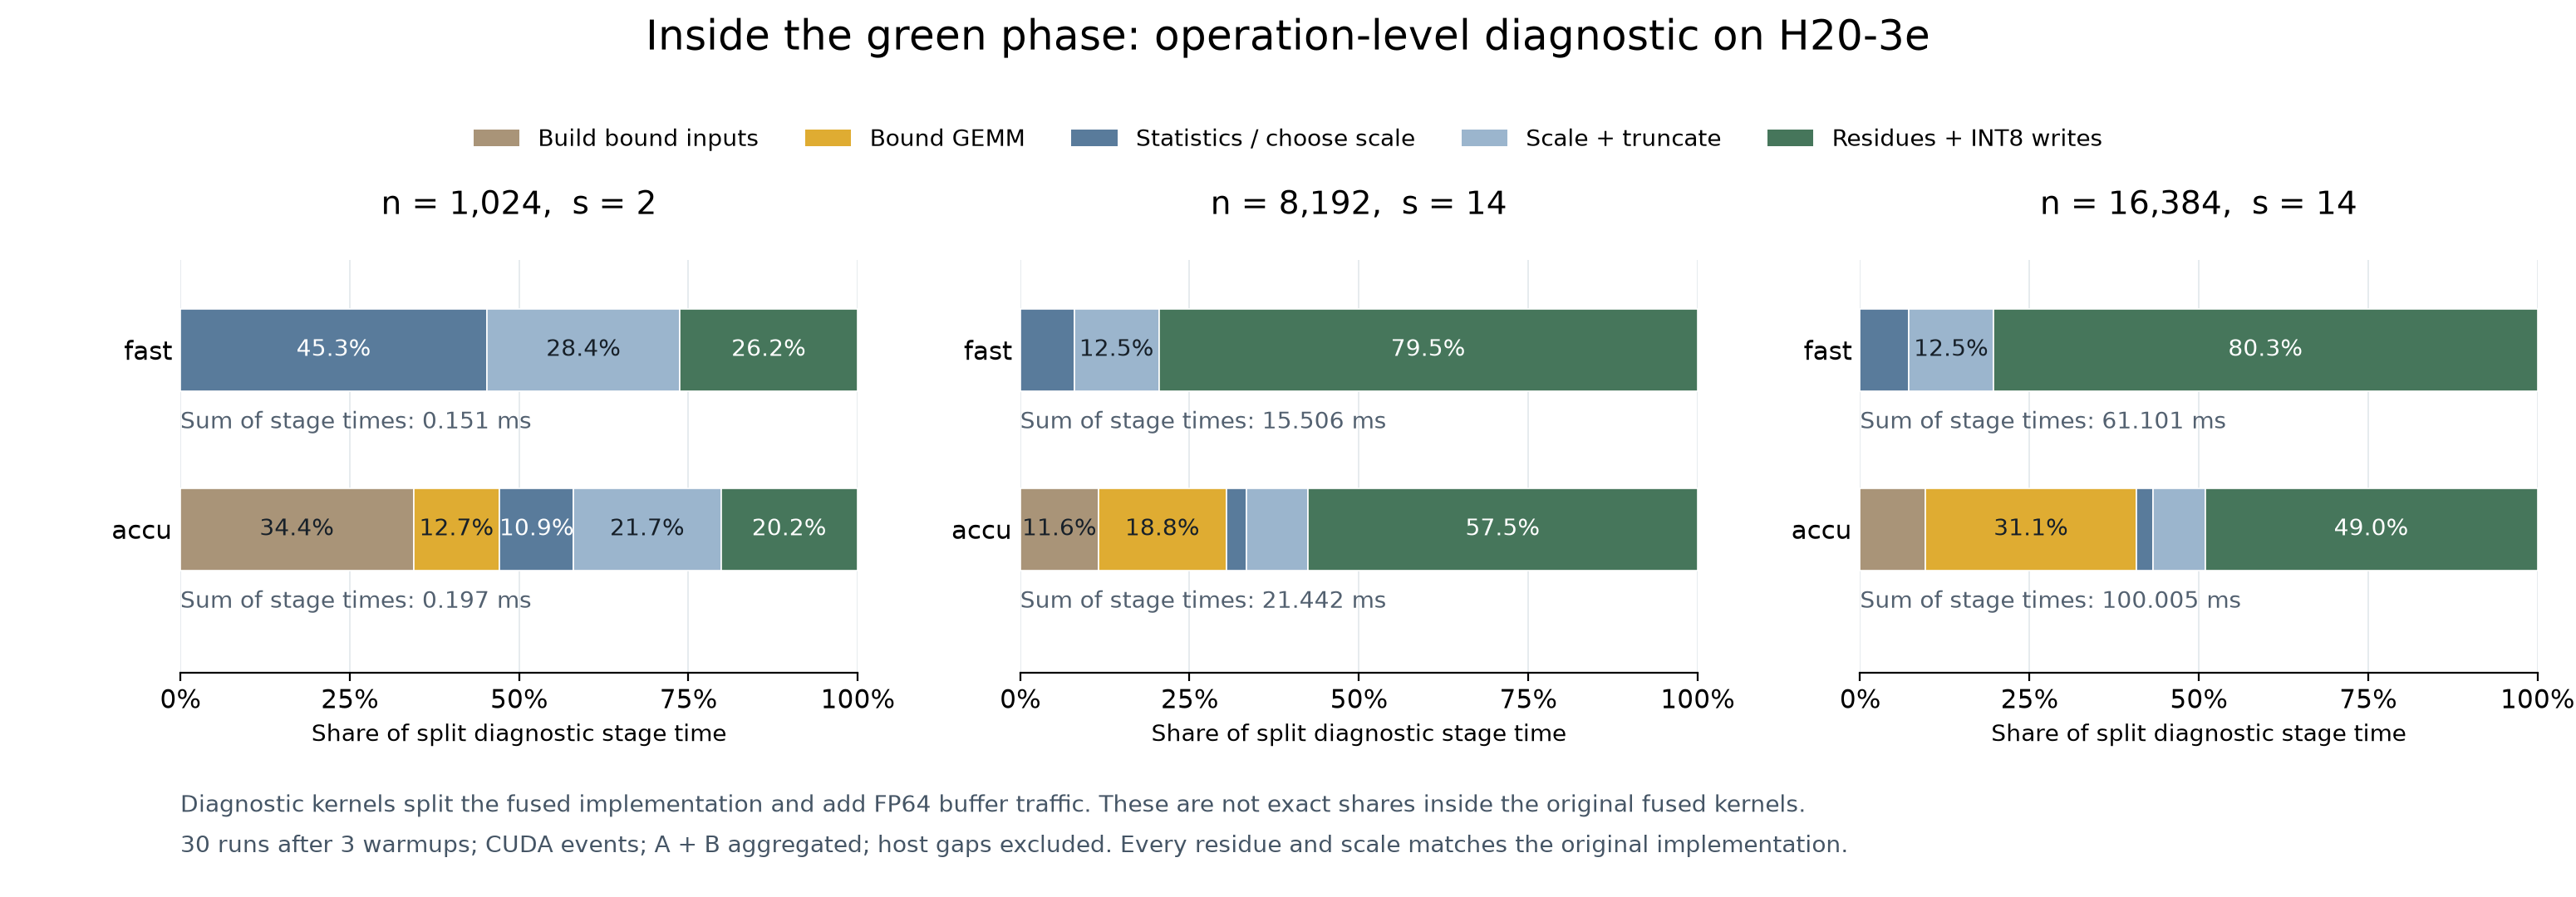
拆分之后的阶段占比。
注释:拆分会引入额外的 FP64 中间读写、启动,以及寄存器和缓存行为变化。在 8192 阶,fast 总设备时间增加约 0.7%,accu 增加约 3.3%;在 1024 阶、2 路时,扰动约为 19%。但这些结果足以定位开销的占比大头:多模数、大矩阵下,余数生成占据 fast 绿色的大部分。不过在1024 阶、2 路的拆分结果中,统计约 45.3%、缩放约 28.4%、余数约 26.2%,固定扫描成本更突出。
对 accu 路径,预处理阶段也要做一次GEMM作估计(图中黄色),这个额外 GEMM 则随着规模变大愈发显眼。在 CUDA event 测量中,它在 8192 阶占预处理过程的约 19.5%,在 16384 阶增至约 32.0%。
6 复杂度分析:矩阵规模和模数数量如何影响耗时
以串行工作量衡量各阶段,忽略固定精度算术的常数,我们进行如下的估计:
| 操作 | 一般形状的工作量 | 方阵情形 |
|---|---|---|
| fast 输入统计 | ||
| 缩放与截断 | ||
| 输入余数生成 | ||
| accu 估界输入转换 | ||
| accu 估界 GEMM | ||
| accu 上界矩阵归约 | ||
| 黄色主 GEMM | ||
| 蓝色输出取余 | ||
| 红色 CRT 与逆缩放 |
注释:最后一行针对本实现固定的一字或双字工作精度;若目标精度无限增长,还需计入多精度算术自身的成本。
所以 fast 的绿色整体的复杂度约为 ,accu 则多出了一个 项。固定 ,从 8192 到 16384,fast 预处理(绿色)实测增加 3.94 倍,主GEMM(黄色)增加 7.80 倍,accu 预处理(绿色)增加 4.70 倍。二次、三次以及混合项的增长关系都得到了印证。
固定 ,对 的绿色时间做线性拟合得到:
斜率几乎相同,accu 截距更大,反映与 无关的额外估界工作。这说明每多用一个模数,fast 和 accu 增加的预处理时间差不多;但 accu 还要额外支付一笔估界成本。
在分析了复杂度以后,我们实际上需要回答的问题变成了这样:预处理部分 与主GEMM 花差不多时间的原因在哪里? 由于受到硬件等各方面条件限制,算法层面的复杂度分析并不能与实际执行时间直接划等号,因而我们还需要结合硬件实际进行进一步求证和分析。
7 内核分析:查明预处理受限的原因
Nsight Compute(下文简称 NCU)是 NVIDIA 的 GPU 内核分析工具,可以读取执行流水线和内存系统的硬件指标。[4]表中的 DRAM 吞吐指 GPU 显存的数据传输速率。我们用它对未拆分的原始 fast 内核采样,得到:
| 内核 | FP64 流水线 % | INT Tensor 流水线 % | DRAM 吞吐 % | |
|---|---|---|---|---|
| 1024/2 | 绿色 A | 88.1 | 0 | 1.13 |
| 1024/2 | 绿色 B | 89.3 | 0 | 0.62 |
| 2048/14 | 绿色 A | 95.6 | 0 | 3.62 |
| 2048/14 | 绿色 B | 95.8 | 0 | 3.46 |
| 2048/14 | 黄色 GEMM | 0 | 73.4 | 2.56 |
| 8192/14 | 绿色 A | 98.0 | 0 | 5.04 |
| 8192/14 | 绿色 B | 98.3 | 0 | 4.88 |
| 8192/14 | 黄色 GEMM | 0 | 95.4 | 9.79 |
注释:各列按各自资源的可持续峰值归一化。[4]
理解这组数据的关键是:H20 上普通 FP64 CUDA Core 算术的吞吐,远低于 INT8 Tensor Core 矩阵乘加。 这里的普通 FP64 CUDA Core 指 SM 内执行逐线程双精度算术的单元。绿色的 FP64 指标达到约 98%,说明这条执行路径已经很忙;黄色的 INT Tensor 指标达到约 95.4%,说明矩阵乘法也充分使用了自己的执行资源。两个百分比相近,但各自对应的吞吐上限相差很大。换句话说,绿色已经接近一条吞吐较低的 FP64 路径的能力上限,黄色则在一条吞吐高得多的 INT8 Tensor Core 路径上执行。 即使两边都高效利用了各自的硬件,绿色仍然可能因为每单位工作的执行成本更高,而花掉与黄色相近甚至更多的时间。这里比较的是大量并行计算的吞吐,不是某一条 FP64 指令与某一条 Tensor 指令的延迟。
A 在列主序矩阵中按行读取,存在跨步访问;B 按列读取较连续。然而两者时间接近,都表现出很高的 FP64 流水线利用率。结合较低的 DRAM 与缓存吞吐指标,证据指向这些采样内核的 FP64 执行吞吐限制。跨步访问值得优化,不过仅凭源码中的跨步,暂时不能认定当前主要瓶颈是显存带宽。
我们把 SM 内部的功能逻辑理解为:
SM 中的调度器与寄存器
    ├── 普通 FP64 CUDA Core 路径:逐线程的双精度算术,吞吐较低
    ├── INT8 Tensor Core 路径:线程组协同执行矩阵块乘加,吞吐很高
    └── 访存、转换与其他执行路径
这种吞吐差距来自不同的计算结构与硬件资源配置。普通 FP64 算术处理宽有效位、指数、规格化和舍入;INT8 Tensor Core 使用较窄整数,并通过专门的矩阵乘加结构,每个周期批量执行大量运算、复用操作数。它能够以很高的吞吐消化 GEMM 的大量乘加。NVIDIA 对 Hopper Tensor Core 的说明[3]
预处理(绿色)最终写出 INT8,但是生成它们的计算却并非使用 INT8 Tensor Core。取余、舍入、求最大值并不直接具有矩阵乘加的结构。普通逐元素操作仍然由很多 GPU 线程并行执行,但其总吞吐受到相应执行资源限制。
因此,第 6 节的复杂度比较还需要加上硬件执行速率:fast 预处理的主要工作量为 ,但其中反复出现的 FP64 运算走的是吞吐较低的路径;主 GEMM 虽然有 的工作量,却能使用吞吐高得多的 INT8 Tensor Core。这就是“预处理做得更少,却仍然很贵”的硬件原因。 下一节,我们会继续检查源码和汇编,确认生成一个 INT8 余数究竟需要哪些 FP64 运算。
8 生成一个 INT8 余数,需要执行哪些指令?
第 7 节已经指出,预处理受到普通 FP64 执行吞吐的限制。接下来我们要追查这些 FP64 工作从哪里来:我们最终需要的是 INT8 余数,为什么准备它们会让双精度执行单元这么忙?
第 5 节的拆分结果把重点指向了余数生成。下面沿着一个输入元素、一个模数的计算过程,依次看函数的输入输出、数值计算步骤和实际机器指令,再把这笔成本放回整个矩阵。
8.1 对FP64的取余
调用取余函数之前,原始元素已经经过二次幂缩放和向零截断。它在数学上是整数值,但程序仍将它保存在 double 中。这里记这个值为 ,当前模数为 。目标是计算一个与 模 同余的小整数,供后续 INT8 GEMM 使用。
数学上,可以通过减去整数倍的模数,把值移到零附近:
如果能准确得到最近整数商,残余就落在半个模数左右的范围内。实现的难点在于: 和商可能很大,最后想保留的余数却很小。因此,计算大数相减时能否保住低位信息,直接影响余数是否正确。
历史实现的核心函数如下:
const auto val = oz2_table::moduli_dev[j];
float tmp = __double2float_rn(fma(rint(a * val.y), val.x, a));
tmp = __fmaf_rn(rintf(tmp * val.w), val.z, tmp);
tmp = __fmaf_rn(rintf(tmp * val.w), val.z, tmp);
return static_cast<int8_t>(tmp);
先把常量表中的四个字段翻译成数学含义:
| 字段 | 数据类型 | 含义 |
|---|---|---|
val.x | FP64 | |
val.y | FP64 | 预先计算的近似倒数 |
val.z | FP32 | |
val.w | FP32 | 预先计算的近似倒数 |
倒数预先存入 GPU 常量内存,每次取余通过乘法估计商。源代码见 mod_8i<double> 和模数常量表[2]。
8.2 三轮归约进行取余和修正
第一轮:用 FP64 消去输入中的大部分模数倍数。
代码里的第一行计算可以拆成:
这里 、 表示舍入到对应浮点格式;rint 将数值舍入到最近整数,中点取偶数,返回值仍然是浮点类型。三个步骤分别是估计整数商、计算剩余部分,再将这个较小的残余转为 FP32。
fma(h0, -m, a) 很关键:它将 作为一次融合乘加计算,乘法中间结果不单独舍入,只对最终结果舍入。如果先把较大的 舍入,再与 相减,中间丢失的低位就可能影响我们需要的小余数。CUDA 对 rint 和 fma 的定义[6]
但 FMA 只解决乘加过程的舍入方式。近似倒数和计算 时的舍入,仍可能使 偏离理想的最近整数商,所以第一轮之后的残余还可能包含若干个模数。
第二、三轮:在较小的残余上继续做 FP32 修正。
源码中的两条 __fmaf_rn 执行相同的操作,只是第二条使用第一条更新后的 tmp。用公式表示为:
每轮都在问:当前残余里还可以减去多少个模数,使它更接近零?然后通过 FMA 减去这个整数倍。第一轮 FP64 已大幅缩小数值范围,后续便在较小的数上进行归约;这解释了代码为何采用“FP64 起步、FP32 修正”的混合精度结构。
最后把 转换为 INT8 输出。完整路径是:
缩放、截断后的 FP64 输入
    → FP64 估商、融合减去模数倍数
    → 转为 FP32
    → FP32 估商与修正,两轮
    → 转换、打包为 INT8
这也说明,最终结果只占 8 位,并不意味着中间计算都能用 8 位完成。若一开始就把大的 转为 FP32,舍入可能已经改变其模余数,后续修正无法自动找回丢失的信息。混合精度实现先处理大数,再降低残余计算的精度。rintf 的浮点取整语义[6]
8.3 每一步在实际汇编中的对应
源码说明了计算步骤,编译后的指令则能确认这些步骤实际产生了哪些工作。SASS 是 NVIDIA GPU 的机器指令表示;这里检查的是主实验原有 gemmul8.o 中的 SM90 代码:
cuobjdump --dump-sass build/gemmul8.o下面沿 vecnorm::scalingB_kernel<double> 中一个元素的数据依赖摘取指令。R16、R32 等是寄存器编号,FP64 值使用相邻的两个 32 位寄存器。地址不连续,是因为编译器在中间穿插了其他元素的计算。
| 地址 | 实际指令 | 对应的计算 |
|---|---|---|
1780 | DMUL R32, R16, R24.reuse | FP64 乘倒数,估计 |
17d0 | FRND.F64 R32, R32 | 将近似商舍入为浮点表示的整数 |
1800 | DFMA R32, R32, R22, R16 | FP64 融合计算 |
1830 | F2F.F32.F64 R27, R32 | 将残余转换为 FP32,得到 |
1890 | FMUL R36, R23.reuse, R27 | 用 FP32 估计 |
18c0 | FRND R36, R36 | 得到第一轮 FP32 修正的整数商 |
18f0 | FFMA R27, R22, R36, R27 | 计算修正后的 |
1910 | FMUL R30, R23, R27 | 用更新后的残余估计 |
1920 | FRND R30, R30 | 得到第二轮修正的整数商 |
1960 | FFMA R27, R22, R30, R27 | 计算 |
1980 | F2I.TRUNC.NTZ R26, R27 | 转换为整数寄存器值,供后续 INT8 打包使用 |
D 开头的 DMUL、DFMA 是双精度乘法和融合乘加;FMUL、FFMA 在这里用于单精度。FRND 将浮点数舍入为整数值,F2F 改变浮点格式,F2I 才转换到整数表示。后续还存在 PRMT 字节打包与写回指令,所以最后一行并不代表整个预处理已经结束。NVIDIA 指令分类[5]
按这一条元素计算链,可以数出 1 次 FP64 乘法、1 次 FP64 舍入、1 次 FP64 FMA、1 次 FP64→FP32 转换、两组三条 FP32 修正指令,以及整数转换。它们之间还存在数据依赖:FP32 修正需要等待 FP64 残余,第二次修正需要等待第一次修正的结果。
编译器通过交错执行多个元素,能够隐藏部分等待时间。更多线程也可以提供并行工作,但这些安排不会减少每个余数必需的算术需求;当受限执行路径已经很忙时,增加并行度无法无限提高吞吐。各指令具体占用哪条硬件流水线,还应结合计数器判断,不能仅按助记符把所有指令耗时都归到 FP64 一列。
这里使用原实验目标文件做只读反汇编,未重新运行 GPU 性能测试。
8.4 这条指令链会重复多少次
外层内核先将一个元素缩放并截断,再在模数循环中反复调用 mod_8i。代码每次处理四个元素,分别对四个值调用这个函数;这仍然是四条逐元素取余计算链。
对于两张 输入矩阵和 个模数,有效输入共需生成
个余数。在 时,这就是 1,879,048,192 个,约 18.79 亿个余数。按每个有效元素的计算需求展开,单是这部分就包含约 18.79 亿次 FP64 乘法和同样多的 FP64 FMA,此外还有舍入、FP32 修正、转换与写回。
这些数是按元素累计的操作需求。GPU 以 warp 等粒度发射指令,一条指令服务多个线程,因此不能把它们直接当成硬件发射的指令条数,更不能把上表的 11 行乘以余数数量,就当作整个内核的动态指令计数。
绿色中其他操作也会使用 FP64。输入统计部分的 DFMA.RP 和 DADD.RP 对应向正无穷舍入的平方和累加、求和归约;缩放与截断同样产生指令。因此,第 7 节看到的高 FP64 指标来自原始融合内核的综合需求。第 5 节的拆分计时进一步表明,在这组大矩阵、多模数测试中,反复生成余数是其中最大的耗时来源。
8.5 与主 GEMM 的执行路径对照
主 GEMM 接收到的是已经准备好的 INT8 矩阵。它可以直接进行矩阵块乘加,无需在每次乘加时重新执行上面的取余步骤。Nsight Systems 在 8192 阶主乘法中记录了以下 cuBLAS 内核:
sm90_xmma_gemm_i8i32_i8i32_i32_tn_n_tilesize256x128x128_
warpgroupsize2x1x1_execute_segment_k_off_kernel__5x_cublas
运行内核的 INT8/INT32 矩阵乘法标识,与 NCU 中约 95.4% 的 INT Tensor 指标相互印证。这里用运行内核和计数器确认主乘法的 Tensor Core 路径,没有导出 cuBLAS 动态库的完整汇编。
至此,预处理的成本就具体了:每个输入元素、每个模数都需要一条包含 FP64 运算的取余链;主乘法则在已生成的余数矩阵上,以 INT8 Tensor Core 的吞吐执行大量乘加。 在下一节,我们会把两边的工作量和实际处理速率放在一起,核对它们能否解释测到的时间比例。
9 为什么更少的计算量仍然可能花更多时间
9.1 22% 对应哪一组测量?
本节所有时间比例都以黄色主 GEMM 为分母;例如 22% 表示余数生成耗时是主 GEMM 的 22%,不是整根柱子的 22%。
方阵的 A/B 输入需要生成
个余数;主 GEMM 执行
次整数乘加。数量之比是 。如果把每个工作单元都当作同样快,当然会预期 GEMM 占绝大部分时间。
令 为每秒生成的余数数, 为每秒整数乘加数。按这些有效速率的定义,有:
代入 8192 阶、14 路的测量:
| 工作 | 数量 | 耗时 | 有效处理速率 |
|---|---|---|---|
| 余数生成 | 约 18.79 亿个 | 12.330 ms | 约 152.4 G 个余数/s |
| INT8 乘加 | 约 7.697 万亿次 | 55.938 ms | 约 137.6 T 次乘加/s |
乘加的数量是余数数量的 4096 倍,但其有效处理速率约为后者的 903 倍。因此余数生成时间仍可达到黄色的
22% 是这组 8192 阶、14 路测量的换算结果,不能作为其他配置的理论预期值。 903 来自两个阶段的实测有效速率,不是固定的硬件峰值比,也不是两条指令的延迟比。用实测时间计算速率,再代回公式,并没有产生独立的性能预测;它的作用是说明工作量差距如何被执行速率差距抵消。前面的拆分计时、硬件计数器和汇编,才提供了定位原因的证据。
9.2 为什么完整绿色是 27.5%,而不是 22%?
22% 只包括余数生成;fast 的绿色还包含输入统计、缩放和截断。同一组拆分诊断中,这两部分分别耗时 1.239 ms 和 1.937 ms,因此完整预处理与黄色的比值约为
原始融合预处理的实际比例则是
两者接近但不完全相等,因为拆分引入了额外中间读写、kernel 启动和执行行为变化,诊断与原始阶段的计时边界也不同。这里用于说明量级,不能把诊断内核的时间当作原融合内核内部的精确分摊。
9.3 同样是 8192 阶,为什么有些配置远高于 27.5%?
先只改变模数数量。第 6 节对 8192 阶预处理给出的经验拟合是:
在这些测量中,每路主 GEMM 大约耗时 4 ms,即 ms。因此:
第一项是随模数一起增加的预处理工作相对于主 GEMM 的成本,在这组数据里约为 22%。第二项来自与模数数量近似无关的预处理工作,被黄色的 路 GEMM 摊薄。模数越少,这笔开销相对于黄色就越显眼。 这里的“固定”只指固定矩阵规模时对 近似不变,并不表示它与矩阵大小无关。
| 模数 | fast 拟合比例 | fast 实测比例 | accu 拟合比例 | accu 实测比例 |
|---|---|---|---|---|
| 2 | 59.7% | 59.3% | 126.1% | 126.3% |
| 14 | 27.5% | 27.5% | 37.0% | 37.0% |
| 20 | 25.9% | 25.9% | 32.6% | 32.3% |
所有行均为 8192 阶。拟合复用了同批数据,用于解释变化,不是额外的预测验证。
以 fast 为例,14 路时,约 3 ms 的非逐模数开销只相当于黄色约 56 ms 的 5.4%;2 路时,它却相当于黄色约 8 ms 的 37.6%。加上逐模数部分,绿色/黄色就从约 27.5% 升到约 59.3%。
accu 还要生成估界输入、执行一次估界 GEMM 并处理上界,其与 无关的成本更高。在 2 路时,这一部分已经足以让完整预处理超过主 GEMM,所以出现 126.3% 并不矛盾。
9.4 矩阵变小时,工作量比例和有效速率也会改变
固定模数数量,改变矩阵规模,同样不能沿用 22%。工作量之比是 :8192 阶时为 4096,2048 阶时为 1024,1024 阶时只有 512。矩阵越小,GEMM 的三次方工作量相对于预处理的二次方工作量越少;因此,在有效速率近似稳定时,余数/黄色以及 fast 绿色/黄色大致随 增大。
固定 ,fast 的实测结果为:
| 矩阵阶数 | 绿色/黄色 |
|---|---|
| 1024 | 80.6% |
| 2048 | 80.2% |
| 8192 | 27.5% |
| 16384 | 13.9% |
8192 到 16384 时,比值接近减半;1024 与 2048 时则几乎相同,说明小规模已经不能用恒定速率的 近似描述。两边的有效吞吐会随规模、线程工作量、内核选择以及启动和同步成本改变。比如 1024 阶、2 路的黄色只有约 79.6 INT8 TOPS,8192 阶、14 路则达到约 275.2 TOPS,因此速率比 903 不能直接搬过去。注意,GEMM 变慢本身会拉长黄色、压低绿色/黄色;小矩阵的高比例不能简单归因于 Tensor Core 利用率低。
小矩阵、少模数时,统计和缩放也更不能忽略。1024 阶、2 路的 fast 拆分诊断中,统计占绿色约 45.3%,缩放占约 28.4%,余数生成只占约 26.2%。原始绿色/黄色达到 234.9%,已明显不同于 8192 阶、14 路的成本构成。该小配置的拆分扰动也更大,因此这些占比用于判断主要工作,不能直接乘回原始计时作精确分解。
对 accu,还要考虑估界 GEMM 与主 GEMM 都按 增长:固定 时,单纯增大 不能像摊薄二次预处理那样摊薄这次额外乘法。
因此,比较其他柱子时,需要同时核对:分子是余数阶段还是完整绿色、模数数量是否相同、矩阵规模是否相同,以及是否包含 accu 的额外估界。 22% 和 27.5% 都有明确的配置与计时范围;其他配置更高或更低,应从这些工作量与有效速率的变化来解释。
10 对后续优化的指导意义
前面的证据已经把第一个修改位置缩小到了 mod_8i<double>:在大矩阵、多模数的诊断中,余数生成占 fast 预处理约 80%;它对每个元素、每个模数重复执行 FP64 乘法与 FMA,而原始预处理内核的 FP64 流水线已接近饱和。下面给出笔者的一些可能尝试的思考。
10.1 每个元素只转换一次整数表示,再生成各路余数
当前代码已经把缩放和截断放在模数循环外,同一个元素会在寄存器中供多路取余使用。利用缩放后的数已经具有整数值,在循环外完成一次精确的整数转换,让循环内主要执行整数运算。
可以尝试缩放后 有限且 的情形。在这个范围内,整数值的 FP64 数可以精确转换为 INT64;超出范围时保留原取余路径。CUDA 提供相应的 __double2ll_rz 转换;不过必须在转换前检查范围。NVIDIA 类型转换文档[6]
一种具体做法是把绝对值分成高、低两个 32 位无符号整数:
分解只做一次。对每个固定模数 ,预先计算 ,随后用
生成余数,最后处理原数的符号,并映射为 INT8 所需的有符号余数。由于 ,高、低两部分各自约化后,方括号内的值最多为 ,可以用 32 位整数完成组合。处理 时还要确保结果落在 INT8 范围内。
模数来自固定表,可以为各个模数生成专用代码,用固定除数的整数约化实现这些取余,并检查编译器是否将其变成乘高位、移位和校正等指令。直接把浮点取余替换成运行时的通用 INT64 %,并不能保证更快。转换、拆分和范围检查应尽量保留在原融合内核中,避免额外写出一整张 INT64 中间矩阵。
这个方案把工作安排改为:
当前:缩放、截断一次 → 每个模数执行 FP64 初步归约和 FP32 修正
原型:缩放、截断一次 → 转整数并拆分一次 → 每个模数执行整数约化
它针对的是之前发现的重复 FP64 成本。
10.2 按模数分组,让输入准备与主 GEMM 重叠
在取余实现稳定以后,可以试验每组准备少量模数的输入,用事件记录该组准备完成,再让计算流执行对应的 GEMM;与此同时,准备流生成下一组输入。两组输入缓冲区交替使用,每组只能在消费它的 GEMM 完成后覆盖。各路输出余数仍需保留给后续 CRT 重构。
准备流:组 0 的输入 → 组 1 的输入 → 组 2 的输入
计算流:              组 0 GEMM → 组 1 GEMM → 组 2 GEMM
这个实验尝试隐藏部分预处理时间。它需要移除阻断重叠的逐阶段同步,并避免每准备一组就重做输入统计。分组可能增加输入读取和 kernel 启动;FP64 与 Tensor Core 的操作也共享 SM、寄存器等资源,所以实际需要进行实验来确认是否会真的产生优化效果。
注释:对于 1024 阶、2 路这样的小配置,拆分诊断中余数生成仅占绿色约 26%,情况则和大矩阵有所不同,需要分别考虑。
11 结语
Ozaki II 展示了一个很具体的算法与硬件协同设计思路:用多路精确的小整数乘法,加上范围控制与高精度恢复,换取低精度矩阵单元的吞吐优势。
沿着它的实现继续追查,又能看到这种设计的代价。主 GEMM 被加速以后,估界、缩放和余数生成仍会产生开销。在我们采样的 H20 内核中,绿色的普通 FP64 路径已接近饱和;黄色则通过 INT8 Tensor Core 高效完成远多于前者的数学运算。
因此,要解释一个性能图表,我们需要同时知道:算法产生多少工作,代码把这些工作变成什么指令,以及对应硬件每秒能完成多少。 复杂度、时间分解、计数器和汇编在这里相互补充,才能够构成一个相对完整清楚的解释。
参考文献
[1] K. Ozaki, Y. Uchino, and T. Imamura. Ozaki Scheme II: A GEMM-oriented emulation of floating-point matrix multiplication using an integer modular technique. arXiv:2504.08009v4, 2026.
[2] RIKEN Center for Computational Science. GEMMul8. 软件源代码,提交 d3ffd5f52e89bdc5338ebff6ba1deccc02b5935a,2025-04-09.
[3] M. Andersch et al. NVIDIA Hopper Architecture In-Depth. NVIDIA Technical Blog, 2022-03-22.
[4] NVIDIA. Nsight Compute Profiling Guide. 在线技术文档,访问日期:2026-10-01.
[5] NVIDIA. CUDA Binary Utilities. 在线技术文档,访问日期:2026-10-01.
[6] NVIDIA. CUDA Math API Reference Manual. 在线技术文档,访问日期:2026-10-01.