
Sparse Attention 的 Algorithm–Infra Co-design
Aug 10, 2026
TL;DR
- 稀疏程度高不一定更快。 Sparse Attention 少算了多少,只是问题的一半; 选中的数据能否被规则地搬运和复用,以及为了找到这些数据付出了多少代价, 同样决定端到端性能。
- NSA 在读取数据之前制造规则性。 它选择连续的 64-token blocks,并让 16 个 query heads 共享选择结果,使稀疏工作负载可以直接映射为规则 GPU tile。
- DSA 在读取数据之后恢复规则性。 它允许选择离散 token,但让 128 个主 heads 共享 token IDs,再由 FlashMLA 将随机 rows 搬入 SMEM、重组为规则 tile; 代价是 Discovery(Indexer + exact Top-K)仍需扫描全部候选。
- DSA 的瓶颈与地址随机性没有强关联,而在于找出这些 token 的过程。 在 本文测试的 H100 sparse-prefill 配置下,八组随机行序排列与有序访问的延迟 点估计相差不超过 0.47%;但在公开 DSA 链路中,Discovery(Indexer + Top-K) 在 64K 检查点已经比 FlashMLA 更慢,并且随着上下文继续增长而迅速扩大差距。
- 因此需要优化 Discovery,而不只是最后的 sparse kernel。 系统层面可以 融合 Indexer 和 Top-K,避免完整 FP32 scores 的写回与重复读取;算法层面则 需要避免每个 query 都扫描全部历史 KV。前者降低当前实现的常数开销,后者 才可能从根本上改变长上下文下的增长趋势。
1. Opening
Sparse Attention 的公式并不难。难的是:算法选出的 KV 不再构成规则矩阵, GPU 该怎样读取、计算和反向归约?本文用 NSA 与 DSA 回答这个问题。它们都在 减少 query–KV pairs,却选择了两条不同的 co-design 路线。
- NSA 在 load 之前制造规则性。 连续 64-token blocks 与 16-head 共享 selection,使算法输出可以直接映射为规则 tile。
- DSA 在 load 之后恢复规则性。 128 个主 heads 共享 token IDs,FlashMLA 将离散 rows 搬入 SMEM 后再计算;代价是候选发现(Indexer + Top-K)仍可能 二次增长。
两者共同指向本文的中心命题:
稀疏率只说明“少算了多少”。真正决定能否加速的,是选中的数据能否被 规则地搬运和复用,以及发现这些数据本身需要多少工作。
后文先统一 tensor 与 tile 的观察方式,再逐步拆解 NSA 和 DSA 的算法数据流、 kernel ownership 与访存路径。两组 H100 实验只在它们真正回答问题的位置出现: 一组检验 DSA sparse kernel 对 selected-row 地址模式有多敏感;另一组检验被 稀疏主核遮住的 Discovery 二次项会怎样随上下文增长。
本文不再重讲 dense Attention 或 FlashAttention,而从 block IDs 与 token IDs
怎样产生、又怎样被 kernel 消费开始。[PAPER]、[CODE]、[DERIVATION]
与 [MEASURED] 分别标记论文陈述、代码事实、本文推导与正式测量。
2. 阅读本文只需了解三个概念
后文会出现很多 shape,但观察方法只有三条。
先约定几个常用词:一个 program 在 Triton 中对应一次独立的 kernel 实例;在 CUDA 语境下可近似理解为一个 CTA(thread block)。SMEM 是 CTA 内部共享的片上内存,HBM/global memory 是容量更大但延迟更高的设备内存。
第一,logical tensor 不等于 HBM tensor。 以一条 Attention row 为例,
在语义上产生 与 。这里的 和 不一定写回 HBM。后文会明确区分:算法上存在的 logical shape、跨 kernel 保存的 materialized shape,以及一个 CTA/program 当前处理的 tile shape。
第二,每个输出都要有明确的 owner。 这里的 owner 是“最终负责写回这块 输出的 program”。假设一个 program 独占 条 softmax rows,并分批读取 条 KV:
其中 是 score scale。局部计算始终是两个规则矩阵乘:
Program 只需为自己拥有的 rows 保留 online-softmax 状态
每个 KV tile 到来后,先更新 row-wise maximum ,再把旧的 与 缩放到新基准,累加当前 tile 的概率和 value numerator。 因此 selected blocks 或 selected rows 可以分批进入,而无须物化完整概率矩阵。
第三,重点不是“跳过多少”,而是“不规则性停在哪里”。 对 每条路径,我们只追踪四件事:
- selection 如何产生,是否物化中间 tensor;
- 一个 program 独占什么 output;
- 一次 KV load 被多少 rows 或 heads 复用;
- 动态 index 在哪里重新变成规则 tile。
一次 FMA 按 2 FLOPs 计。除非特别说明,byte count 使用 BF16 useful payload; cache-line overfetch、page/TLB 与 allocator 影响会在相关位置单独讨论。
3. NSA:先让算法产生可执行的块级工作负载
Takeaway. NSA 的关键不是“选 16 个 block”,而是每个 ID 都指向连续的 64 个 tokens,并由同一 KV group 的 16 个 heads 共同使用。算法输出因此已经 接近一个规则的 计算 tile。
NSA 将长程注意力拆成三种访问模式:
真正关键的推导链不是“三路相加”,而是
算法公式来自 NSA 论文。论文实验所用 kernel 没有完整公开,因此本文的
online Top-K、forward grid 与 backward 代码分析以 FLA 社区实现为例;凡是
实现特有的选择都会明确标出。[PAPER] [CODE/community] [GAP]
3.1 算法契约:三路稀疏各自提供什么
NSA 没有要求一条稀疏路径同时承担所有信息。Compression 保留远程概貌, selection 找回重要细节,sliding window 保证局部连续性。三路各自做 softmax, 最后再融合输出。
省略 batch 轴,使用 sequence-major layout。对长度为 的序列,
NSA 面向 GQA。论文默认配置采用
第 个 KV head 对应的 query-head group 为
三条分支的算法参数是:
| 分支 | 稀疏单位 | 论文默认配置 | 每条 query 的可见规模 |
|---|---|---|---|
| compression | overlapping window | 约 | |
| selection | contiguous token block | 至多 | |
| sliding | local token window | 至多 512 |
其中 是位置 的因果前缀长度。它包含
个完整 compression windows,以及
个因果可见的 selection blocks。
三路不是同一份 KV 上的三个 mask。论文为它们提供独立的 K/V projection:
因此,即使三路访问了同一个 token,也不能简单求 union 后只算一次 Attention:它们使用不同表示、分别归一化,最后才组合输出。
Compression 回答“远处大致有什么”。 每个 KV head 将长度为 的 overlapping window 压成一行 K/V,相邻窗口 stride 为 。完整序列因此产生约 行 compressed K/V。
位置 、group 的局部 shapes 为
固定 stride 时,所有 query 的 compression Attention pair count 仍为
在相同 feature dimension 下,它相对 dense causal pair count 约减少 倍, 但仍不是线性复杂度。这里比较的是算术规模,不是包含 compressor、routing 与 kernel efficiency 后的 wall-clock speedup。
Sliding window 回答“眼前发生了什么”。 局部分支只访问
提供固定、连续且易于 tiled attention 处理的局部上下文。
Selection 回答“远处哪些细节值得重新展开”。 它怎样产生 block IDs 是 下一小节的主线。三条分支分别完成 softmax,得到
再由独立 sigmoid gates 组合:
这些 gate 不要求和为 1。执行 DAG 上,sliding branch 可以与 compression/routing chain 并行,selection Attention 则必须等待 block IDs。 至于 compression probabilities 如何到达 routing,属于实现选择:可以物化、 与 Top-K 融合,或者像后文分析的 FLA 路径一样,根据 、compressed 与 LSE 分块重算。
3.2 Routing:从 Compression Probability 到 Top-16 Block IDs
Selection 没有另训练一套 router。它复用 compression Attention 已经得到的 概率,将“哪些压缩窗口重要”转换为“哪些 64-token blocks 值得展开”。整个过程 只有三步:空间重映射、16-head 求和、Top-16。
空间重映射。 令
为 query head 的 compression probability。论文 Eq. 9 将它变成 selection-block score:
越界的 compressed-window index 视为零。论文配置满足
直觉上,一个 64-token block 会与多个 overlapping compression windows 相交; 这个双重求和就是把所有相关窗口的概率累加到该 block。
GQA group reduction 与 Top-。 同一 KV head 的 个 query heads 必须共享 selection IDs,因此
论文 Sec. 4 的具体配置还规定:16 个 selection slots 中固定激活 1 个 initial
block 和最近 2 个 local blocks,其余 slots 才由上述动态 ranking 填充。
[PAPER]
对成熟位置,
它是带有 slot 顺序的 index tensor,而不是数学集合。序列开头可能只有少于 16 个因果有效 blocks;kernel 可维持 16 个 selection slots,但必须用 或 block count 标记 padding。“固定 16 个 slots”不等于“始终存在 16 个有效 blocks”。
这三个固定 slots 也会影响 backward:initial block 会被大量 queries 共同选择,
而 local blocks 随 query 移动。到 3.4 节讨论 时,这种 fan-in 差异
会直接变成负载不均。[DERIVATION]
完整 shape 链为
compression probabilities       [T,Hq,≈T/16]
  → Eq. 9 spatial remap          [T,Hq,≈T/64]
  → reduce G=16 query heads      [T,Hkv,≈T/64]
  → Top-16                       [T,Hkv,16]
但概率在哪里? 标准 FlashAttention 不会把完整 probability matrix 写回 HBM,通常只返回 output 与 LSE。因此,“复用 compression probability”只说明 算法关系,还没有给出可执行的数据流。
在 上,完整窗口数实际为 。为说明固定 shape allocation 的上界,令 padded capacity
若按该 capacity 物化 per-head FP32 compressed scores,
一层需要
若在 Eq. 9 remap 之前先对每个 GQA group 求和,物化
仍需
若讨论的是 remap 之后的 group-reduced block scores,令 ,其 shape 应为
对应
这三个数字描述不同的数据流位置,不能混用。
当前 FLA 给出了一种可行机制:保存 compression LSE,根据 Q 与 compressed K 分块重算 probability,并用 bitonic merge 在线维护 Top-,从而不物化上述 二次 score tensor。这条路径以重算换显存:Top-k kernel 必须再次用 Q 扫描 compressed K,因此 routing 仍包含一次 的 QK scan 与候选 merge。它消除的是二次 score tensor 的 HBM materialization,不是二次 pair scoring 本身。
其配套路径还把 compression 简化为 non-overlap mean pooling、共享 K/V,并对
GQA group size 施加至少 16 且为 2 的幂等实现约束;这些都不是论文算法的通用
定义。因此,FLA 只能证明一种 infrastructure 路径可行,不能证明论文作者采用
了同样实现。[CODE/community] [GAP]
3.3 Selection Forward:逻辑 Gather,物理 Block Tile
现在 block IDs 已经产生。Forward 只剩一个问题:是否先把 16 个 blocks gather 成紧凑的 tensor?答案是否定的。这个 tensor 只应存在于 数学视图中;kernel 应保存 IDs,并按 block 直接读取原始 KV。
从 16 个 IDs 到逻辑上的 1024 个 Tokens
Routing 输出离散 block IDs:
每个 指向 selection K/V 中一段连续的 64-token block:
对成熟 query,如果 16 个 slots 都有效,数学上可以拼成
逻辑 attention shapes 为
这里的 1024 是 padded capacity,不是所有位置的有效 token 数。序列开头可能有无效 slots;包含当前位置的 causal block 也可能只有部分 token 可见。实现必须同时应用 ID mask、range mask 与 causal mask。
这个 只是逻辑 shape。原始 KV 中仍是 16 段离散 blocks;每个 block 内的 64 个 token rows 则可由一个 base 加规则 offsets 得到。NSA 改善的 不是“16 个 blocks 彼此连续”,而是把 1024 次 token-level 间接寻址收敛成 16 次 block-level 定位。
如果真的为每条 query/group 构造这两个 tensors,外部 gather 既要处理 16 个不规则 block bases,又要将它们组装为 compact selected-KV tensor 写回 HBM。 仅 K/V payload 就有
(BF16)。这些数据写入 HBM 后还要被 Attention 重新读取。因此 kernel 只保存 IDs,并在内部按 block 加载原始 K/V。
一个 Program 最终写回什么
先看论文默认配置。 此时 ,所以 。一个 program 对应一个 query position 和一个 KV group,独占 16 个 query heads 的 完整 output:
这就是最重要的 ownership:同一个 program 既持有 16 条 softmax rows,也能 让它们共同复用每个 selected block。
再展开通用 grid。 当 value 维需要分成多个 tiles 时,完整 owner 还多一条 value-feature 轴:
它由 唯一标识。这里 是 batch, 是 query position, 是 KV group, 是 value-feature tile。
对 fixed-length 输入,FLA 使用
其中:
- 是 batch size;
- 是每条序列在本次调用中的 query 与 KV token 数;
- 是 query-head 与 KV-head 数;
- 是一个 KV head 服务的 query-head 数;
- 是每个 head 的 Q/K feature 与 V/output feature 维度;
- 是 selection-ID 末维的 slot capacity,源码记作
S,本文配置为 16; - 保存 block IDs;
block_counts若为 tensor,则记录 每个 query/group 的有效 slot 数,若为 scalar capacity,kernel 扫描全部 个 slots; - 是一个 program 沿 value feature 轴计算的 tile 宽度;
- 是覆盖完整 value 维所需的 tile 数。
FLA 还假设 对应每条 KV sequence 最后的 个 tokens。因此 fixed-length 路径中,query slot 在 KV sequence 内的绝对位置不是 简单的 ,而是
后面的 causal mask 与 selected-block 起点都相对于 判断。
源码中的 launch grid 是一个三维 program-count tuple:
源码将三个 program IDs 命名为 i_t、i_v 与 i_bh。为避免
i_v 和 value tensor 混淆,本文把第二个 ID 改记为 :
它们依次表示 query position、value-feature tile,以及被压平的 batch/KV-head 位置。第三个 ID 按
还原成 batch index 与 KV-head/group index 。这里特意用 表示 batch,避免和后文的 KV block ID 混淆。第 个 group 服务的 query heads 仍是
再定义 program 负责的 value-feature 区间
于是 program ,等价地说 ,是下面这个输出 slice 的唯一 writer:
物理 accumulator 按 分配;最后一个不满 的 tile 通过 feature mask 处理。由此也能看清 axis 顺序:去掉 batch flattening 后 grid 是 ,而不是 。
如果 ,同一个 会展开成 个 programs;它们为各自 的 value-feature slice 重算相同的 QK/softmax,但写入的 两两不交,因此 output 没有写冲突。LSE 不沿 value 维切分, 源码只允许 的 program 写回 。
回到论文配置,,当前 FLA 也取 ,所以
此时每个 恰好只对应一个 program,它独占 的完整 selection output。该 program 随后加载并常驻 逻辑 query tile
一个 64-Token Block 怎样变成规则 Tile
随后循环 16 个 selection slots。本文用 表示一次内循环
加载并计算的 KV-token row 数;在当前 FLA 路径中,它对应源码参数 BS,并
恰好等于 NSA 的 selection block length :
对一个有效 block ID ,program 计算 ,并加载
这是算法层面的逻辑 tile。在当前 FLA 的 Hopper 分支中,
所以为了匹配 Triton dot 的 feature tile,实际构造
其中 feature 维 的尾部通过 mask/padding 处理。因此逻辑 contraction 是
而 QK 的物理 padded execution shape 是
这组 的执行 shape 是 当前 FLA Hopper 路径的
结论。非 Hopper 分支将 BK 上限设为 128;当 时会得到两个
feature tiles,并触发源码的 NK == 1 断言,因此不能把这里的
直接外推到该路径。
动态性只存在于每轮加载前的 block base;进入片上 tile 后,计算重新变成固定 shape。
这里特意不用 表示 token tile。NSA 论文中的 token-tile 记号 在当前 FLA 源码中对应 BS;FLA 的 BK 表示 padded feature width,例如
混用两套记号会把“64 个 tokens”误读成“256 个 feature elements”。
在线归一化。 Program 对 16 个 blocks 使用前文统一介绍的 exact online-softmax merge,只维护每个 query head 的 running max、normalizer 与 output accumulator,不写出 。所有 selected blocks 完成后直接写回
因此 output 拥有唯一 writer,forward 不需要对 output 做 atomic reduction。
为什么 head sharing 是执行契约。 对一个 64-token block,QK 与 PV 的乘加量约为
若 K/V 为 BF16,本轮主要 K/V payload 为
只看这份被 16 个 heads 共享的 K/V payload,局部 arithmetic intensity 为
这不是整 kernel 的 roofline 数字:它没有计入 Q、output、indices、LSE、mask 和 launch 开销。它只说明,同一 K/V block 被越多 query heads 复用,一次不连续寻址带来的搬运就越容易被规则 matmul 摊薄。
对成熟 query,selection 主循环有 16 个 slots;序列开头仍运行相同控制结构,但无效 slots 被 mask。NSA 提供的是“固定容量、可 padding 的 workload”,而不是没有边界条件的绝对固定工作量。
可跳读的实现补充:variable-length 不改变 ownership。 公开路径将多条 不等长序列 pack 到 batch 轴为 1 的 tensor 中。第一条 grid 轴由 改成总 query 数 ,再通过
token_indices_q找回每个 query 的序列号与局部位置;另外两条轴仍是 。因此 varlen 只改变 的定位方式,不改变“一个 program 唯一写一个 output slice”的 ownership。完整 packed shapes 为[ Q:[1,T_Q^{\mathrm{total}},H_q,d_k],\quad K^{\mathrm{slc}}:[1,T_K^{\mathrm{total}},H_{kv},d_k],\quad V^{\mathrm{slc}}:[1,T_K^{\mathrm{total}},H_{kv},d_v]. ]
3.4 Forward 与 Backward 使用不同的稀疏图
Takeaway. Forward 的
query → selected blocks关系只给 output 找到了 owner。若继续使用 query-centric ownership, 需要浮点 atomics 或 partial-gradient reduction;本文审计的 FLA 社区实现选择把它转置为KV block → selecting queries,再让每个 KV-block program 完成自己的 many-to-one reduction。
Forward 的自然 owner 是 query,因为每个 program 能独立完成一个 。Backward 则有两种归约方向。
以下只讨论 selection branch 的 backward。完整 NSA 还包括 gates、compression branch、sliding branch,以及三个分支对共享 Q/input 的梯度合并。
重算 Probability,保留稀疏图
Selection backward 不需要保存完整 probability matrix。当前 FLA 首先由 forward output 与上游梯度计算每个 softmax row 的
随后根据 与 分块重算 score/probability。对 batch/sequence 、query 、group 与 selected block , 有
这里 表示 block 内 行 value vectors,shape 为 。相应的局部量 shapes 为
若不使用 activation checkpoint,FLA selection autograd state 至少包括
以及 variable-length 场景所需的 block counts 和 sequence metadata。当前 FLA
的 autograd 路径实际保存 q, k, v, o, lse,并在 context 中保留 block
indices 等 metadata。准确结论是“不保存 ”,而不是
“forward 只需保存
”。
继续由 Query 拥有
对 query ,只有它自己选择的 blocks 参与
每个 block 的局部 shape 为
同一 program 可以循环全部 slots。逻辑上的最终结果为
而当前 Triton kernel 取
所以物理 accumulator b_dq 的 shape 是 ;末尾 64 个 padded
feature lanes 由 mask 处理,最终只写回前 192 维。因此 dQ 仍适合
query-centric ownership。
源码中 fixed-length 的 dQ launch grid 为
Backward 取
使 softmax backward 中的 始终对应完整 value 维。因此当前路径中 program ,等价地说 ,独占一个 的 dQ slice。variable-length 路径只把第一条 grid 轴换成 packed token 位置,ownership 不变。
为什么不能继续由 Query 拥有
一个 KV block 可能被许多 queries 选中。令
它的梯度是跨 queries 的 many-to-one reduction:
若沿用 query owner,不同 programs 会同时更新相同的 ,只能使用大量 floating-point atomics,或写 partial buffers 再归约。更自然的办法是先转置稀疏关系:
forward adjacency:   query → selected KV blocks
backward adjacency:  KV block → all selecting queries
然后让一个 program 拥有一个 KV block。
转置稀疏图,让 KV Block 成为唯一 Owner
这里先看 fixed-length 路径。令完整序列的 block 数为
将一个 KV block 压平为 row
CSR 用两个一维 arrays 保存“每个 block 被哪些 queries 选中”:
其中 csr_indices 分配到 padded edge capacity;只有
csr_offsets[-1] 之前的 prefix 有效。源码存入的是压平后的 absolute query
position
因此 row 满足
当前 FLA 通过 counting-scatter 构造它:
遍历有效 selection edges
  → atomic count 每个 (batch,group,block) 的 fan-in
  → prefix sum 得到 csr_offsets
  → 再遍历 edges,用 atomic cursor scatter query IDs
atomic 只作用于紧凑整数 metadata;昂贵的 浮点归约则获得唯一 owner。variable-length 路径改用 packed block/query IDs,但“一个 CSR row 对应一个 KV-block owner”的 关系不变。这里真正重要的不是 CSR 格式本身,而是它完成了从 query-centric 到 KV-centric 的稀疏图转置。
KV-centric dKV tile。 fixed-length 的 dKV launch grid 为
由于当前 backward 路径中 ,program 是 KV block 的唯一 writer。variable-length 路径将第二条 grid 轴替换为“packed KV blocks 数 ”,但仍然 由一个 program 独占一个 KV block。该 program 持有
和同 shape 的 gradient accumulators。它从对应 CSR row 每次读取 个 query positions,并展开每个 query 的 个 heads:
批内 query 与 output-gradient shapes 为
局部重算与归约重新形成规则 matmul:
例如 时,。逻辑上的 score-recompute contraction 为
当前 Triton kernel 的 ,所以实际 tl.dot tile 是
其中末尾 64 个 feature lanes 由 mask 补零;b_dk 也相应使用
的物理 accumulator,再只写回前 192 维。
CSR 的作用不只是压缩 metadata。它把“多个 queries 向同一 KV gradient 地址写入”的冲突,改写为“一个 KV owner 顺序读取自己的 queries”,再在 owner 内部恢复规则 Tensor Core tile。
写冲突消失了,Fan-in 长尾还在
定义
当 block_counts=16 是固定标量 capacity 时,
program 扫描固定的 16 个 padded slots;FLA 也接受逐
query 的 tensor block_counts,此时运行时 可以缩短。dKV program
的循环长度则由 决定。fixed initial/sink block,以及由动态 ranking 形成的热门
blocks,可能拥有远高于平均值的 fan-in,形成长尾 CTA;移动的 local slots
本身只产生有界的局部 fan-in。拆分热门 row 可以改善负载均衡,却会重新引入
partial reduction 或 atomic。Backward 因而把问题从“跳过多少 FLOPs”转成了
“如何调度 many-to-one reduction”。
本文没有继续把 fan-in 长尾做成性能实验。一方面,论文作者使用的 backward
kernel 没有公开;另一方面,社区实现中改变 routing topology 时,fan-in skew、
query gather locality 与 CSR row 顺序会一起变化,很难把 latency 差异归因给
单一变量。因此,FLA backward 将不规则性从浮点写冲突转移成了 CSR row
length、query-gather locality 与 CTA load balance。本文没有对这些因素报告
性能测量;这里只把它作为源码可确认的执行后果,而不声称它解释了论文作者
kernel 的 backward latency。[DERIVATION] [CODE/community] [GAP]
3.5 NSA 的规则性来自算法契约,不来自 Kernel 魔法
在论文默认配置下,NSA selection 能映射为高效 kernel,是因为算法主动提供 三项执行契约:
Routing 输出的每个动态 ID 已经对应一段连续的 64-token block。因此,kernel 在 load 之前就知道:不规则性只存在于 block base,block 内 64 个 token 可以 通过规则的 affine offsets 展开。Program 加载规则的 K/V tile, 再与共享该组 IDs 的 16 个 query heads 形成 score tile。本文分析 的 FLA community backward 则进一步转置稀疏图,让 KV block 成为 的唯一 owner。
这也给出三个不能越过的边界。
第一,NSA 不是“任意 block sparsity 都会自动加速”的证据。真正产生硬件效率的是连续 block、head sharing、固定 slot capacity 与明确 ownership 同时成立。
第二,selection 与 sliding 的 token budget 在成熟位置近似固定,但 compression 仍访问约 行 compressed K/V。固定 时,全层 compression 仍为 。
第三,FLA 展示了 online Top-k、group-centric forward 与 CSR backward 的一套完整可行机制;它不能证明论文作者的未公开实现采用相同 routing materialization、tile 参数或 inverse-adjacency construction。
论文报告,在其 配置与 A100 测试环境中,作者的 Triton NSA 相比 Triton FlashAttention-2 在 64K 达到 9.0× forward 与 6.0× backward speedup。这个结果可以归因于论文报告的完整系统,不能直接归因于本文从社区代码拆出的某一个 kernel 选择。[PAPER] [GAP]
换句话说,NSA 最值得复用的不是某一条稀疏公式,而是一种共同设计方法:
先让算法输出 GPU 能消费的稀疏单位,再分别为 forward output 与 backward gradient 选择唯一 owner。
4. 从 Block 到 Token:DSA 为什么能走得更细
NSA 与 DSA 不是简单的“旧方案”和“新方案”。NSA 选择 block,是为了让训练 和推理都能直接使用连续 tile;DSA 选择 token,是因为它在 MLA 上找到了另一条 足够强的复用轴。这里的变化不是取消硬件约束,而是改变算法满足硬件约束的方式。
4.1 Infra:连续 Block 不再是规则性的唯一来源
先看 NSA 面对的问题。任意 token selection 会产生大量离散 KV row;在训练中,
这些 rows 还要参与 的反向归约。NSA 因而把选择单位固定为连续
64-token block。代价是 selection 只能表达“这一段值得看”,不能只取 block
中真正相关的几个 token。换句话说,NSA 用选择粒度换取了 load 前的规则性。
[PAPER]
DSA 的出发点不同。DeepSeek-V3.2 已经建立在 MLA 上,每个 token 只保存一条
共享的 latent KV entry。DSA 又让同一个 query 的 128 个主 heads 共用一组
token IDs。于是,一条离散 KV row 虽然难以读取,却能在读入后同时服务很多
heads;FlashMLA 可以把随机寻址留给 producer,再让 Tensor Core consumer
处理规则的 SMEM tile。此时,连续 block 不再是获得硬件效率的唯一办法。
[PAPER] [CODE]
从 infra 角度看,设计重心因此发生了三步变化:
| NSA | DSA | |
|---|---|---|
| 选择粒度 | 连续 token block | 任意单 token |
| 用来摊薄访存的共享轴 | 同一 KV group 的 16 个 query heads | 同一 query 的 128 个主 heads |
| 规则 tile 在哪里出现 | global load 之前 | 离散 rows 进入 SMEM 之后 |
这给 DSA 更细的内容选择能力,但不是免费的升级。NSA 的 routing 在压缩后的
token 轴上进行;DSA 的 Indexer 保留完整 token 分辨率,随后还要执行 exact
Top-K。它把主 Attention 限制为 ,却没有消除 Discovery 的
。所以这次变化更准确的描述是:用更强的跨 head 复用和专用
gather kernel,换取 token-level selection;再把系统瓶颈从 sparse main
Attention 推向 Indexer 与 Top-K。 [DERIVATION]
4.2 Training:把新 Router 接入已有 MLA Checkpoint
DeepSeek 没有从头训练 DSA,而是在已扩展到 128K context 的 DeepSeek-V3.1-Terminus 上继续训练:
- Dense warm-up: 保留 dense Attention、冻结主模型,用 dense Attention 分布产生的 KL loss 训练 Indexer。
- Sparse training: 启用 Top-2048,主模型用 language-modeling loss 适应稀疏模式;Indexer 继续使用独立 KL loss。它的输入从主模型计算图中 detach,使两路梯度彼此隔离。
这套流程的意义是:保留已有 MLA 参数化,只接入新的 router 和 sparse kernel,
而不必从头训练整套 Attention。[PAPER]
证据边界。 DeepSeek 的报告并没有给出一项“NSA 对 DSA”的直接消融, 也没有逐条声明放弃 NSA 的原因。上面确认无疑的是两篇论文各自的 algorithm contract、DSA 对 MLA/MQA sharing 的选择,以及它的 continued-training 流程; “设计重心为什么能够从 block 转向 token”则是基于这些公开事实作出的系统分析。
下面进入 DSA 的实际数据流,依次追踪 Indexer score、Top-K token IDs、MLA 执行表示与 FlashMLA kernel。
5. DSA:把任意 Token Selection 重新变成规则矩阵
Takeaway. DSA 允许任意 token selection,但让 128 个主 heads 共享同一 组 IDs。FlashMLA 只让 producer 处理离散地址;进入 SMEM 后,consumer 看到的 仍是规则矩阵。
DSA 的完整前向链只有三个阶段:
下面逐阶段展开,并保留理解 shape 所需的记号。
| 符号 | 含义 | DeepSeek-V3.2 |
|---|---|---|
| 本次调用的 query 数与可见 KV 数 | 运行时决定 | |
| Indexer head 数与维度 | ||
| 主 MLA query heads | ||
| latent KV 与 RoPE 维度 | ||
| 原始主 MHA NoPE 维度 | ||
| 原始 MHA value 维度 | ||
| 每个 query 最多选择的 tokens |
这里的 不能和 FlashMLA 内部的 latent value 维度 混写。主 Attention 也有两套代数等价、执行 shape 不同的表示:
5.1 Indexer:低维,但仍扫描全部历史
第一步:为每个 Query–Token Pair 打分
Indexer 的任务只有一个:为 query 和每个历史 token 计算便宜的 routing score,再选出 Top-。论文公式是
其中
对全部 query 与历史,最终 routing-score matrix 为
后面的 projection、RoPE、Hadamard、FP8 和 DeepGEMM fusion 都在回答同一件 事:怎样以更低代价计算这个 ,而不把更大的 中间量写进 HBM。
DSA 一层里同时存在两种 score:
以及
是 Lightning Indexer 的 routing score,只负责产生 token address; 是主 MLA 在 selected tokens 上重新计算的 attention logit,只有它会进入主 Attention 的 softmax。
Indexer 决定“去哪里看”;主 MLA 再决定“看见以后怎样加权”。
第二步:生成低维 Query、共享 Key 与 Head Weight
归一化 hidden states
先生成主 MLA 与 Indexer 共用的低秩 query latent:
Indexer 不再从 7168-D hidden 独立做一次大投影,而是从 得到:
reshape 后:
发布版公开 DeepGEMM 接口以物化的 FP8 Q 为输入;生产系统是否把这段 projection、旋转和量化进一步融合,公开代码没有给出答案。
历史 token 的 Indexer key 则只有一条共享向量:
持久 cache 的逻辑 shape 为:
这意味着 64 个 Indexer query heads 共享同一个历史 key,而不是为每个 head 维护一份 K cache。
Indexer 还从当前 hidden state 直接生成 query-dependent head weights:
其中 是 query 对第 个 Indexer head 的基础权重; 这条分支不经过 softmax。把官方 reference 的两个固定 normalization 吸收后, 定义
需要注意,只有 Indexer Q 复用 ;Indexer K 与这里的 weights 都直接 由 生成。
第三步:RoPE、Hadamard 与 FP8
每条 128-D Indexer Q/K 被拆成:
前 64 维应用 non-interleaved RoPE,与主 MLA 使用的 interleaved RoPE 不同。这不是排版差异:若两边使用不同的 pair layout,对应位置的 dot product 就会改变。
旋转后再应用归一化 Hadamard 变换 :
所以量化前有:
Hadamard 不改变精确实数内积;它的作用是扩散 outlier,使后续 E4M3 量化更稳定。“内积不变”不能外推成“量化后逐 bit 不变”。
关于两个 的记号。 是一个标量,表示 Indexer head 数; 才是 Hadamard 变换 矩阵。它的元素为 ,是固定、正交且不参与学习的线性 变换。实现无需在内存中物化这张 矩阵,而是用 fast Hadamard transform 通过分层加减在 时间内完成。Q/K 使用 同一个 ,所以精确算术下内积不变;它位于 partial RoPE 之后、FP8 量化之前,量化后的内积则只近似保持。
令 表示 E4M3 数据, 表示相应 scale。官方 reference 将 query scale 与两个 normalization 一起折入 query-dependent weight:
于是 scorer 的实现语义可写成:
这里的 明确指经过 partial RoPE、Hadamard 与 FP8 量化后的向量,不再和变换前的 混用。
Indexer K cache 的逻辑 payload 是:
与完整主 KV row 相比,这是全历史扫描带宽能够显著下降的基础。
第四步:在片上融合 64 个 Heads,只写最终 Score
按数学定义,固定 query 时先有:
全局 logical shape 是:
再经过 ReLU、weight 和 head reduction:
如果把 写入 HBM,低维 Indexer 会先制造一个比最终 score 大 64 倍的中间量。发布版 DeepGEMM scorer 因而把矩阵乘、ReLU、query-dependent weighting 与 64-head reduction 融合起来,只写最终的 FP32 。
它的一种核心 tile 按代码中的 GEMM 方向可以概括为:
最后一步对 64 个 Indexer heads 做 ReLU、query-dependent weighting 与 reduction,再将 candidate-major accumulator fragments 直接映射到逻辑 的输出地址。这里没有单独的 transpose 阶段。中间的 64-head 结果 停留在片上;HBM 只看到每个 query 对 256 个 candidates 的最终 score tile。
但这个发布版 scorer 不包含 Top-K。公开 DeepGEMM pipeline 仍然为
分配并物化完整的矩形 carrier。主 scorer 写入每行的合法 candidate 区域;
启用 clean_logits 时,invalid/future 区域由独立 cleanup kernel 填充。
随后 exact Top-K 仍需重新扫描这张完整矩形结果。
因此 DeepGEMM 已经完成的是 scorer 内部融合:FP8 matrix multiply、ReLU、 query-dependent weighting 与 64-head reduction 在同一 kernel 中完成, 的 per-head scores 不写入 HBM。但这不是 Indexer–TopK fusion。发布版公开 pipeline 仍然物化完整的 ,后续 exact Top-K 仍由独立实现重新扫描。
第五步:Top-K 将 Score 变成 Token 地址
对 query 位置 ,令 表示最后一个 causal 可见位置。数学上:
是 token address,不是 routing score。同一个 query 的 128 个主 heads 共享 ,不同 query 的集合则可以完全不同。
公开接口还需要两步 shape/dtype 适配。
第一,官方 inference reference 的 torch.topk 返回 INT64 indices,并以一次调用的 min(index_topk, end_pos) 作为固定末维;causal mask 负责让未来位置保持无效。
第二,在本文的 DSA 配置下,FlashMLA sparse-prefill 接收固定宽度为 的:
若某行只有 个合法 tokens,其余 slots 必须改写为 invalid
sentinel,例如 -1 或不小于 的地址。不能重复某个合法 token 来填满,
否则 softmax 会把该 token 计算多次。
从 reference 的 INT64 Top-K 到 kernel 的固定宽度 INT32 tensor,因而是一项真实的数据准备工作,不是可以在 shape 图里省略的类型标注。
Top-K IDs 是离散控制流,language-modeling loss 不能直接穿过“某个 token 是否 入选”这一决策。4.2 节介绍的两阶段训练用独立 KL loss 解决 Indexer 学习问题; 它不改变推理时 exact Top-K 的执行成本。
至此,Indexer 阶段结束。它交给下一阶段的不是 Attention 概率,而是 token addresses。
5.2 MLA Bridge:为什么主 Kernel 是 576-D MQA
Indexer 只产生地址。真正的 Attention 权重仍由主 MLA 计算。本节只做一次代数 重排:把每个 head 独有的 K/V up-projection 移到 Attention 两侧,使 selected KV row 能被所有 heads 共享。结果是 FlashMLA 看到 576-D shared key 和 512-D latent value,而不是 128 份展开后的 MHA K/V。
原始 MHA 表示会重新展开 KV Cache
共享 query latent 经过主 MLA 的 query up-projection:
每个 head 拆成:
使用主 MLA 的 interleaved RoPE。另一侧,hidden states 先投影出 512-D KV latent 与 64-D RoPE key:
前 512 维经过 RMSNorm 得到 ,后 64 维经过 RoPE 得到 。因此 KV cache 保存:
若直接恢复成 MHA,每个 head 的 content key 与 value 分别为:
其中:
这会得到:
如果真的为 128 个 heads 展开这些 tensors,MLA 压缩 cache 的意义就会在 attention 前被抵消。
将 Key Up-Projection 吸收到 Query
NoPE score 中的 content 项满足:
定义:
再把 RoPE 部分拼回去:
于是主 QK 的执行 shape 变成:
这里的 “1” 表示所有主 query heads 共享同一条 MQA key row。
执行 dot product 的向量虽然是 576-D,softmax scale 仍继承原始 192-D MHA score。公开 reference 在长上下文配置下使用
其中 与 分别是配置中的 YaRN 系数与 RoPE 扩展因子。 不能机械地替换成 ,因为 576-D 只是代数吸收后的执行表示,不是新的模型 score 定义。
将 Value Up-Projection 移到 Attention 之后
原始 MHA 的 head output 为:
利用线性性:
因此 MQA core 直接使用:
先得到 latent output:
再通过每个 head 的 恢复:
最后将 heads 展平并应用 :
FlashMLA sparse core 只返回 ; 恢复与 都在该 kernel 之外。
在精确算术下,MQA mode 不是新的近似,而是 MLA 的代数重排;实际 BF16/FP8 量化与不同运算顺序不保证逐 bit 相同。论文 Appendix A 给出 MHA/MQA 的代数 关系,官方 Python inference reference 的 prefill 分支仍显式 up-project K/V 并执行 MHA,decode 分支才直接体现这条 MQA 吸收路径。本文这里推导的是 FlashMLA sparse-prefill caller 需要准备的 576-D MQA 执行表示,而不是声称 reference prefill 已经调用该 kernel。
这条重排的最终意义只有一句:同一个 selected KV row 在算法上可以服务全部 128 个主 heads。下一节的 FlashMLA 正是围绕这条复用关系设计。
这里还要区分算法共享与物理共享。SM90 release kernel 以 64 heads 为一个 CTA,所以 CTA 内可严格确认 64-way row reuse;另一个 CTA 读取同一组 IDs,但跨 CTA 没有共享 SMEM,也不能把 L2 hint 写成必然命中。
5.3 FlashMLA:把随机 Rows 收进 SMEM 边界
Takeaway. FlashMLA 不在 global memory 中物化 与 ;producer 直接按 IDs gather 64 条 rows 到 SMEM,consumer 因而只看到规则的 QK tile 与 latent PV tile。
有了 、 和共享 KV,主 Attention 的数学程序很短:
对一次固定 selection width 的 kernel 调用,把所有 query positions 重新写成 batched matrix program,完整 logical shapes 是:
这两次 batched matrix multiplication 分别沿 576-D QK feature 与 selected-token 轴 收缩。它们定义算法语义,但不要求两个 selected tensors 真正在 HBM 中存在。
问题不在公式,而在 应该在哪里存在。
阶段一:输入只有 Q、共享 KV 与 Token IDs
本文审计的 Hopper sparse-prefill API 是:
flash_mla_sparse_fwd(
    q,
    kv,
    indices,
    sm_scale,
    d_v=512,
)
其 release contract 是:
q       : [TQ, HQ, 576]  BF16
kv      : [TK, 1,  576]  BF16
indices : [TQ, 1,  κ]     INT32
output  : [TQ, HQ, 512]   BF16
max     : [TQ, HQ]        FP32
lse     : [TQ, HQ]        FP32, log2-based
同时要求:
architecture = SM90
H_KV         = 1
HQ % 64      = 0
κ > 0
κ % 128      = 0
D_QK         = 576
D_V          = 512
Q、KV 和 indices 的最后一维必须连续;invalid index 可以是 -1 或任何不小于 的值。这些约束是当前 release kernel 的能力边界,不能泛化成任意 head、任意维度、任意 Top-K。
这里还有一个重要的调用约束:kernel 只检查 index 是否落在 ,并不知道每个 query 的绝对位置,也不会在内部重新施加 causal mask。因此所有有效的 都必须已经满足该 query 的因果可见性;这由 上游 Indexer、causal cleanup 与 Top-K pipeline 保证,而不是 FlashMLA 补救。
阶段二:不在 HBM 中构造 Selected-KV
若先在单独 kernel 中收集:
单个 query 就需要写出:
后续 Attention 还要再读一遍,仅这个中间 tensor 就增加约:
的 logical global-memory round trip。这个数不是必然发生的物理 HBM bytes: 中间结果的重新读取可能由 L2 服务。它对应的还是最节省的 external-gather 方案,因为
所以只需物化一条 576-D fused row,再让 使用其前 512 维;若分别物化 K/V,额外流量只会更高。原始 KV-cache read 是 external 与 fused 两种方案共有的成本,因而没有计入这里的“额外流量”。
FlashMLA 不在 global memory 中创建该 tensor。它只把每轮需要的 64 条离散 row 搬入一个规则的:
tile,然后让 Tensor Core consumer 把它当普通二维矩阵使用。
阶段三:一个 CTA 负责 64 个 Heads
SM90 sparse-prefill release 使用:
其中 是一个 CTA 覆盖的 query-head tile 长度, 是一次处理的 selected-token tile 长度。
launch grid 为:
一个 CTA 固定拥有:
128 个主 heads 因而使用两个 CTA,两者读取同一个 。
384 threads 分成三个 128-thread warpgroups:
| warpgroup | 角色 |
|---|---|
| WG0 | consumer:even 64-token chunk;持有输出 |
| WG1 | consumer:odd 64-token chunk;持有输出 |
| WG2 | producer:读取 indices,将间接 KV rows 搬入 SMEM |
当论文默认配置 时:
个 selected-token chunks 被组织成 16 轮 even/odd paired iterations。
阶段四:Producer Gather,Consumer 只看规则 Tile
随机的是 row base,不是 row 内的 576 个元素。一条 BF16 KV row 占:
决定下一条 row 的 base address,相邻 selected rows 可以落在完全不同的 cache line、page 或 HBM partition。但 base 确定后,该 row 的 576 个 BF16 元素在逻辑地址上连续。SM90 producer 实际将它拆成九个连续的 128 B feature slabs 协作搬运;这不是一条 1152 B bulk transaction,也不保证底层 DRAM transactions 全部合并。
所以 producer 面对的不是 576 次彼此无关的 scalar random load,而是:
随机确定 row base
→ 多线程合作搬运连续 row
→ 写入 swizzled SMEM
→ consumer 读取规则 [64,576] tile
不规则性被限制在 global-memory hierarchy 到 SMEM 的边界;QK 和 PV 的内部 shape 重新变成规则矩阵。
阶段五:两个 Consumers 分担 Token 与 Value 两条轴
WG0 与 WG1 都计算完整 QK feature:
它们的 QK 区别在 token 轴:WG0 处理 even chunk,WG1 处理 odd chunk。
PV ownership 则沿 value feature 轴拆开:
| WG | 本地 probability | 常驻 FP32 accumulator | 对本地/远端 的贡献 |
|---|---|---|---|
| WG0 | |||
| WG1 |
两个 warpgroups 各向对方提供一块 probability tile:
因此一个 even/odd pair 的双向 useful payload 是 16 KiB,而不是搬动各自约 64 KiB 的 FP32 output accumulator。
online softmax 仍维护 三类状态。新增的同步只在于:WG0 先把历史状态与 even chunk 合并并发布更新后的 max,WG1 再把 odd chunk 纳入, 得到这一 pair 的统一 max 基准;两边据此重标度 probability 与各自的 output half。两份 partial normalizer 仍分别累积,直到 epilogue 才跨 warpgroup 相加。因此 even/odd pipeline 改变的是 ownership,没有改变 selected-token softmax 的数学定义。
阶段六:Pipeline 隐藏下一批 Gather 的延迟
这里不是两块完整 tile 做简单
ping-pong。plan.k[0] 与 plan.k[1] 分别保存当前 pair 的 even 与 odd
64-token chunk;每个 chunk 又沿 feature 轴拆成 与
两段,并各自拥有 ready/free barrier。Producer 对一对 chunks
的搬运顺序是:
even[0:256]
→ odd[256:576]
→ even[256:576]
→ odd[0:256]
→ next pair
Consumer 用完某一段便发布对应 free barrier,producer 随即可以用下一 pair 的 数据就地覆盖该段。因此在稳态中仍然形成
compute pair i
        ||
gather pair i+1
的重叠,只是流水发生在四个可独立复用的 feature segments 上,而不是两个完整 tile 交换角色。它减少的是 Tensor Core 等待下一批离散 rows 到达的可见 latency;不减少必须读取的 KV bytes,也不改变 selected row addresses 的 随机性。若 L2/TLB/HBM 延迟超过当前 pair 计算可覆盖的窗口,consumer 仍会 停顿。
为什么这套 Pipeline 有机会成功
在一个 CTA 内,每条 576-D KV row 被 64 个 query heads 复用。只计该 row 参与的 QK 与 latent PV,局部算术量约为:
除以 1152 B useful row payload:
这个数字解释了为什么 “任意 token selection” 不必然意味着 consumer 只能做低强度随机访存。算法让 64 个 heads 共享地址,kernel 再把同一 row 变成片上高复用 tile。
但 只是以逻辑有效载荷为分母的 CTA-local intensity,不是端到端 roofline,也不是实测的 L2 或 DRAM bytes。它没有计入:
- Indexer 与 Top-K;
- index tensor 的读取;
- Q、输出与 softmax 状态;
- cache-line transaction、L2/TLB miss 与
L2::256Bprefetch hint; - 两个 CTA 之间不保证发生的 cache reuse;
- launch、调度与服务固定开销。
5.4 受控实验:随机 KV Rows 还剩多少代价
前面的 kernel 拆解给出一个可以直接 检验的现象预测:FlashMLA 没有消灭随机 row address,但在完整 kernel 中, row order 与 row concentration 的变化可能只表现为较小的 latency 扰动。 下面的 KV-row locality experiment 测量这个响应有多大;它本身不识别是哪一种 infra 机制造成该响应。
先给结论:在这组固定 H100 sparse-prefill 条件下,把同一 selected set 从 地址升序改成八种随机顺序,没有测到稳定的 latency penalty;把 2048 个 rows 压进 2K/4K 的紧凑窗口只出现亚百分比小收益,而且随窗口大小并不单调。这个 结果说明当前 kernel 对所测地址模式不敏感,不说明随机访存没有代价。
我们在一张 NVIDIA H100 PCIe 上冻结未修改的官方 FlashMLA SM90
sparse-prefill kernel(commit 3969f20),使用:
每个 query 拥有一块互不重叠的 128K-row KV arena,因此跨 query 的
selected-row IDs 不会重叠。这排除了某个条件偶然获得更多跨 query 同-row
cache reuse 的混杂因素;但同一 query 的两个 64-head CTAs 仍然请求同一组
selected rows,二者之间仍可能发生 L2 reuse。
每种条件包含 10 个 interleaved campaigns、每个 campaign 20 个 matched
rounds,共 200 次逐调用 CUDA-event 测量;16 个不重复条件共保存 3200 条
observation,并统一使用 eight-slot rotating schedule。官方 34 个
sparse-prefill tests、自建的 16 条件 correctness gate 和 formal validation
均通过。[MEASURED]
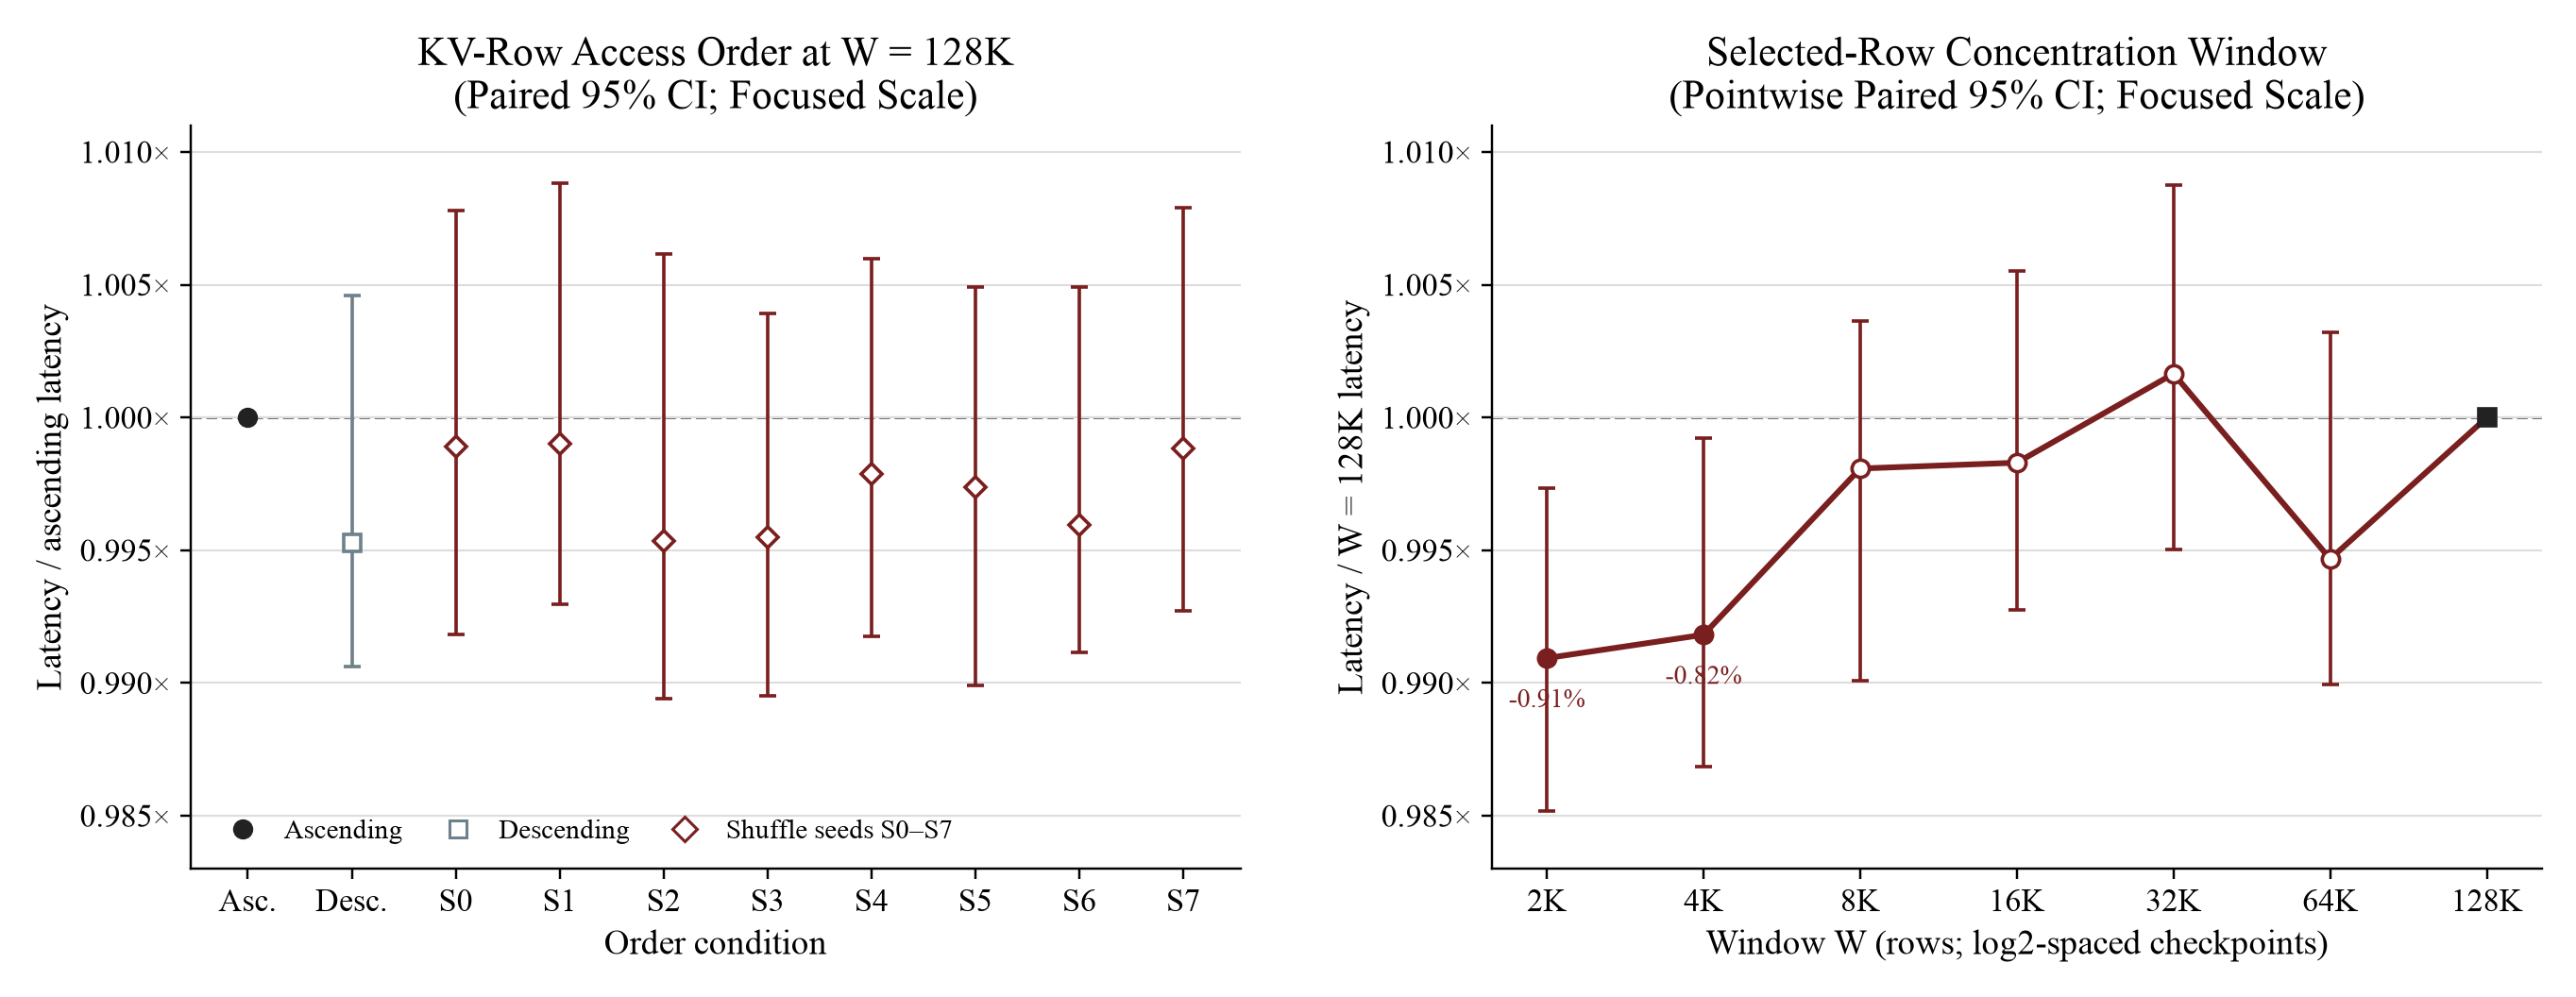
图 1:纵轴使用 focused scale。左图固定完全相同的 selected-row set,只改变 ascending、descending 与八种 shuffle-seed 顺序;右图改变采样窗口 , 不同 会重新采样 window origin 与 exact selected IDs,因此折线只作视觉 引导,不表示同一 selected set 的连续轨迹。误差棒均为 paired campaign-block bootstrap(5,000 resamples)得到的 pointwise 95% CI,不是所有可能 permutations 或多重比较校正后的总体区间。
先只改变访问顺序。 顺序实验对每个 query 和每个 ring slot 固定完全相同的 2048-row selected set,只将它排列成地址升序、地址降序和八种独立随机顺序。
Ascending 的中位 latency 为 ;descending 为 ,归一化 ratio 为 ,paired 95% CI 为 。点估计相差 ,但区间包含 1。
八个 shuffle seed 的 ratio 落在 –,seed-level median 为 ,IQR 为 。对于这八个预先冻结的排列,每个 shuffle 相对 ascending 的 pointwise timing CI 都跨过 1。因此在这个固定 kernel point 上,我们没有检测到随机排列相对于地址升序的 latency 惩罚。这些区间 量化的是每个 fixed-permutation condition 的 timing uncertainty,不是所有 可能 permutations 的总体区间;关于 permutation-to-permutation variation, 独立单位只有八个 seeds,每个 seed 下的 200 次 timing 仍是重复测量。
这个 null result 不是因为两组 indices 实际上仍然很接近。地址有序时,相邻 row
距离的中位数为 44,每个 64-index tile 触及的 64-row regions 中位数为 41;
在 W=128K, shuffle-00 下,这两个数字分别变成 38,435 和 63,同一
64-row region 内的相邻访问比例也从 降至 。软件可见
的 locality 已经发生数量级变化,而 latency 仍几乎不动。
再改变 selected-set 的聚集范围。 聚集范围实验固定 、
uniform-without-replacement 采样规则和 shuffle-00 的 rank-permutation
rule,将 selected rows 分别从宽度为
的 64-row-aligned window 中采样。这里改变的是 selection distribution 的聚集
程度:不同 的 window origin 与 exact selected row IDs 并不相同,因此
它不是“同一组 tokens 只改变 span”的 paired ablation。只有
W=128K, shuffle-00 与顺序实验共享完全相同的 indices corpus,并作为
聚集范围实验的 baseline。
128K baseline 的中位 latency 是 。相对它,2K 和 4K 窗口的 latency 分别低 和 ,即绝对差约 与 ;对应 pointwise 95% CI 为
在预先报告的 pointwise 95% intervals 下,只有 2K 与 4K 的区间低于 1; 其余窗口均包含 1。这里同时进行了六个 W-vs-128K 比较,却没有作 family-wise multiple-testing correction,尤其 4K 的上界 已非常接近统计边界。 一个未预注册的 Bonferroni bootstrap sensitivity check 中,2K 的区间上界约 为 ,4K 则约为 。因此本文把 2K 视为较清晰的 tight-window 小收益信号,把 4K 降为更弱的 exploratory signal。
与此同时,每个 tile 触及的 region 数随 从 28、41、51、57、60、62 增至 63,latency point estimates 却不单调:64K 快于 8K–32K,32K 又略慢于 128K。这些跨窗口关系本身不是额外的 direct pairwise tests。实验没有建立 locality–latency 单调律、可信阈值或普遍的 显著性结论。
启动阶段的敏感性。 原始计时中还存在一个与每轮实验起点严格对齐的 短暂慢启动:10/10 轮实验的第一次计时都达到所属条件中位数的 –,总计 12/3,200 个观测超过各自条件中位数的 。正式结果遵守预先冻结的纳入规则,没有在看到结果后删除这些 观测;中位数估计与配对随机化降低了少数长尾点的影响。
作为补充的事后敏感性检查,删除每轮实验的
matched_round=0 后,2K/4K ratios 从 变为
,对应收益从约 缩小到
;重新计算的 pointwise 95% intervals 仍低于 1。方向没有
翻转,但精确效应量对实验所处阶段有一定敏感性,因此这里只把它解释为
亚百分比的小信号,而不是稳定的硬件常数。
Profiler 只用于解释这个 clean-timing 结果。相对于
W=128K, shuffle-00,单次 capture 的 NCU DRAM read 少
,device-read sectors 少 ,NCU/Nsys duration 分别短约
和 。但 L2 hit rate、long-scoreboard stall 与
Tensor-pipe activity 都没有随 形成一致的单调链条。四个代表点的
GMMA 指令数完全相同,achieved occupancy 也都在
–。这确认了 dominant Tensor Core work 与静态执行
形状受到控制,但不表示地址生成、cache transaction 或 stall behavior 相同。
每个条件只有一个 NCU/Nsys kernel instance,而且 NCU 使用 replay、不清 cache、
不锁频;这些 counters 只能作为补充诊断,不能给出带方差的因果解释。
因此,这组 locality experiment 最稳妥的结论不是“随机访问已经免费”,而是:
在冻结的 H100/SM90 sparse-prefill operating point 上,对于八个预先测试的 随机排列,我们没有检测到相对地址升序的 latency penalty,所有 point estimates 与 ascending 相差不超过 。W-sweep 的 latency 不随 locality 单调变化;2K 给出较清晰的亚百分比小收益信号,4K 则是更接近统计 边界的 pointwise signal。
这个结果与前面的 co-design 解释相符:一个 CTA 将每条 selected row 复用于 64 个 heads,producer 把离散 global-memory rows 重排成规则 SMEM tile, feature-segment pipeline 再尝试用 QK、softmax 与 PV 覆盖下一批 row 的到达 时间。但本实验没有关闭 64-head reuse 或 pipeline,因此只能说结果“与这些机制 隐藏了大部分 locality 差异相一致”,不能声称实验已经证明是哪一种机制导致了 本实验观察到的小响应。
实验边界同样重要:indices 是 uniform-without-replacement 的 synthetic stimulus,private arenas 还刻意消除了真实 workload 可能具有的热门 token 和 跨 query reuse。结果只覆盖 、、BF16 576-D rows、 和一张 H100 PCIe;它不是完整 DeepSeek-V3.2、production DSA、 真实 Indexer trace,也不是 sparse decode 测量。顺序实验的统计结论限于八个 冻结的 permutation seeds;聚集范围实验比较的则是不同 下重新采样的 synthetic corpora。实验还使用 作为冻结的 synthetic kernel stimulus,而不是模型的 192-D-plus-YaRN score scale。
因此这个受控实验只能证明 FlashMLA 在当前 operating point 上对 row locality 表现出较低敏感性;它不能保证 production DSA 一定得到相同结果。验证外部 有效性还需要保存真实 Indexer 输出的 indices trace,原样 replay 到同一 kernel, 并比较其 adjacent distance、regions-per-tile、跨 query overlap 与 latency 是否落在本实验覆盖的范围内。
5.5 可跳读的实现与架构补充
Decode 是另一条 kernel。 上面的微架构与 locality experiment 都对应 BF16、非分页的 SM90 sparse-prefill。作为补充测量的 H100 single-query decode 路径使用的是另一条公开实现:paged FP8 sparse-decode。
在固定 实验形状下,它使用:
q                : [1, 1, 128, 576] BF16
main KV cache    : [num_blocks, 64, 1, 656] mixed-byte packing
physical indices : [1, 1, 2048] INT32
page size        : 64 tokens
latent D_V       : 512
其中每个 token 的 656-byte cache row 由
组成,并非 656 bytes 全部使用 FP8。physical indices 也不是 Indexer 输出的
逻辑 token IDs,而是经 page table 改写后的 paged-cache token offsets。该路径
的 Top-K multiple-of-64 约束、split-KV scheduler 与 combine kernel 都不同于
本节的 sparse-prefill contract。二者实现同一 selected-token Attention 语义的
不同 operating point,不能共用 cache shape、metadata 成本或单 kernel 结论。
Blackwell 将 gather 进一步下沉给 TMA。 下述结构对应所核对的 FlashMLA commit
9241ae3
;在这个版本中, 的 public dispatch 精确落到
SM100 regular head128_k576,而不是 head64:head64 prefill 要求完整
,small-topk head128 又只支持 。
这与前文形成一条直接的架构演进。Hopper/SM90 将一个 128-head query 映射成 两个拥有独立 SMEM 的 64-head CTAs;Blackwell/SM100 则使用
并以
为每个 query 组织一个 two-CTA cluster。每个 CTA 仍处理 64 个 query heads,
但 K producer 改用 TMA tile::gather4 的 cta_group::2 形式。
一条 gather4 指令描述四条任意 row 的 64-D BF16 feature slab,因此 useful
payload 为
在每个 128-token chunk 中,两个 CTA 各负责 64 条 selected K rows。于是每个
CTA 的一个 K slab 需要 次 gather4;完整
576-D K 路径共有九个 64-D slabs,最后一个正是 RoPE 部分。与 standalone
head64_k576 不同,这条实际 head128 路径不会把 RoPE tail 改走专用
cp.async。
V 使用另一组 producer warps:两个 CTA 都覆盖 128 条 selected rows,但分别 gather 256 个 value dimensions,合起来形成 latent V tile。 因此 cluster 在 token 轴协作准备 K、在 value-feature 轴拆分 V,正好对应后续 two-CTA QK/PV ownership。
gather4 将四行间接寻址、bulk-copy issue 与 completion tracking 下沉给 TMA,
并能直接落入 swizzled SMEM;源码可以直接确认软件逐行地址生成与细粒度 copy
指令减少,但总同步开销和实际 latency 的变化仍需 benchmark。四条 row 仍可能
对应完全不同的 global-memory addresses,指令不保证把它们合成连续的物理
DRAM transactions。这不是本文 H100/SM90 实验所能验证的路径。
5.6 隐藏的二次项:稀疏主核不等于线性系统
Takeaway. FlashMLA 将昂贵的主 Attention 限制在固定 Top-,但 Lightning Indexer 仍为每个 query 计算全部历史 candidates,随后执行 exact Top-;因此 sparse core 是 ,完整 causal prefill 仍保留低常数的 Discovery term。
FlashMLA 只访问 selected 2048 tokens,但 DSA 必须先发现它们。只要 routing score 仍依赖每个 query–candidate pair,Indexer 就保留了一次全历史扫描。
本节先做理论计数,再看 H100 实测。两者回答不同问题:理论说明二次项为什么 存在;实验说明在冻结的公开实现链中,它何时开始主导 latency。
下面的 只计 dominant dot/QK/PV,并省略所有式子共同的 FMA factor 2。它是 shape-derived useful-MAC count,不是不同 dtype 与 kernel 的 等价时间单位。
理论一:单个新 Token 的成本
面对长度 的历史,Indexer 成本为:
selected main MQA core 为:
所以:
第一项随历史持续增长;第二项在 后饱和。
理论二:完整 Causal Prefill 的累计成本
现在用 表示完整 causal sequence 的长度,对 query positions 求和:
sparse core 的精确求和是:
当 :
因此:
固定 时:
DSA 没有把 quadratic attention 变成 asymptotically linear attention。它把:
替换为:
这是很有价值的常数重构,不是渐近阶数改变。
DSA 改变的是二次项的常数
用原始 192-D MHA score 和 128-D MHA value 作 prefill-style baseline:
Indexer 的二次项系数是其:
若比较 single-query dense MQA decode,完整扫描 576-D key 与 512-D latent value:
Indexer 的线性扫描系数比它小:
这些比例还隐含一个带宽变化:全历史扫描中占主导的 per-candidate KV payload 只需读取共享的 128-D FP8 Indexer key 与 scale;Indexer query、head weights 与 score carrier 写入仍然存在。完整 576-D 主 KV 则只为 selected tokens 读取。
可跳读:算术量的解析交叉点
只比较 DSA 内部的 Indexer 与 sparse main。单个新 token 面对长度 的 历史时是 endpoint;完整 causal prefill 则对所有 query positions 累加。 在 下:
| 口径 | useful-MAC 交叉关系 | tokens |
|---|---|---|
| endpoint | Indexer = sparse main | 34,816 |
| full causal | cumulative Indexer = cumulative sparse main |
这些只是由 shape 推出的算术交叉点,不是 latency 预测。它们没有包含:
- projection、RoPE、Hadamard 与量化;
- FP8、BF16 与 Tensor Core 吞吐差异;
- FP32 logits materialization;
- exact Top-K 与 index rewrite;
- FlashMLA scheduler、split-KV 与 combine;
- 通信、launch、cache 和服务固定开销。
后面的实验还包含 scorer、Top-K 与 index transform,因此 34,816 和约 68,592 只能提供量级参考,不能预测实测的 bracket。
公开实现还要物化 FP32 Score Carrier
如果把 full prefill 一次性写成
那么在 时,仅最终 routing logits 的逻辑 payload 就是
这是 one-shot materialization 的 shape-derived logical payload,不是后面
Discovery scaling experiment 的实际峰值,也不是该路径的完整显存需求。
公开 prefill scorer 支持 query chunk。令 chunk size 为 ,最终处理
长度 ,第 个 chunk 的右端点为 。忽略
BLOCK_Q=2、BLOCK_KV=256 带来的有界 tile rounding,真正有 causal
语义的 scorer pairs 为
但交给独立 Top-K 的是每个 chunk 的矩形 carrier:
二者之差是每个 chunk 内必须清理为 的 future triangles:
这里的 只计算真正写成 的 future elements, 不能直接代表整个 cleanup kernel 的 issued work。公开 cleanup kernel 仍按 遍历每一行的完整 carrier。记所有 query rows 累计访问的 cleanup blocks 数为 ,则
因此固定 时,无效值写入量是 ,但 cleanup kernel 的 traversal 并不是线性的。 公开 API 将 scorer 与 cleanup 合并计时,后面的实验也保持这一边界。
因此:
在 2M 的最后一个 chunk 中,公开链真正物化的 logical view 是
其 DeepGEMM backing 因 256-token stride padding 再多 4 MiB。从 4K replay 到 2M,所有矩形 carriers 的累计 logical write volume 约为 8.016 TiB,但它们 不需要同时保持为 live tensors;allocator 仍可能保留已经申请的 reservation。 Chunking 把单次 live carrier 从 square tensor 降到矩形 tile,却没有改变 scorer 与 Top-K carrier 的二次累计增长。
Exact Top-K 为什么仍要扫描全部 Candidates
若 query-dependent routing score 没有额外结构,也没有 candidate-specific bound 能安全排除未检查候选,那么 exact global Top- 在最坏情况下 必须检查全部 个 candidates。
否则,对任何被跳过的候选 ,都可以构造一个保持已检查 scores 不变、但令 大于当前第 大值的输入。selector 因而无法证明结果 exact。
在这些明确前提下:
Chunking、streaming Top-K 和 kernel fusion 可以减少 peak memory、HBM 往返与 launch,但不会自动减少必须判断的 candidate 数量。要改变渐近项,需要允许 approximate retrieval、引入具有可证明安全排除保证的层次化候选结构,或让 相邻 queries 在同样的 exactness 保证下复用已经排除的候选。
H100 实验:二次 Discovery 何时超过稀疏主 Attention
上面的 operation count 只描述算法结构;GPU latency 还取决于 dtype、kernel efficiency、 中间张量以及内存流量。下面的实验因而只问一个更窄、也可直接测量的问题:
在冻结的公开实现链中,随着完整 causal prefill 长度 增长,Discovery 何时超过 fixed- 的 FlashMLA sparse main attention?
先给结果:32K 时 Discovery 仍小于 FlashMLA;64K 时已经超过它;到 2M 时, 二者之比达到 。从 256K 到 2M,Discovery 与 sparse main 的 端点有效指数分别为 2.027 与 1.031,与“前者近二次、后者近线性”的预测一致。 这些数字只属于下面这条冻结的公开组件链,不是 production DSA 的固定拐点。
我们没有实现或测量 Indexer–TopK fused kernel。被测对象是下面这条 released unfused chain:
DeepGEMM FP8 scorer
→ causal cleanup
→ FP32 score carrier
→ PyTorch exact Top-K
→ invalid-index padding / INT32 cast
→ FlashMLA sparse prefill
记
对同一个 query chunk,FlashMLA 必须等 Top-K IDs 生成后才能启动,因此这里的 Discovery 不是可以和该 chunk 的 main attention 任意重叠掉的旁路成本。
实验在单张 H100 PCIe(SM90)上固定 。2 次 warmup replay 后,Direct full-chain total 使用 20 次重复 clean replay 的 start-to-checkpoint CUDA event;阶段归因 来自另外 5 次 instrumented replay,并在每个 trial 内累加所有 chunk events。 二者是不同的测量轨迹,下面不会用阶段中位数相加冒充 direct total。
这个 workload 是 shape-controlled synthetic chain:同一份 4K Indexer query、 weights 和 main query 被重复 replay,直到 2M 时一共处理 512 个 chunks; selection 也不来自真实模型 trace。因此它控制了 shape 和执行路径,却没有复现 真实语义输入的 score 分布。下面的 crossover 只适用于这条冻结的公开组件链, 不是 production DeepSeek DSA 的性能预测。
Extended campaign 的 CUDA-event 中位数为:
| 已处理长度 | Discovery cumulative | FlashMLA sparse prefill | Direct full-chain total | Discovery / FlashMLA |
|---|---|---|---|---|
| 32K | 0.0307 s | 0.0422 s | 0.0728 s | |
| 64K | 0.1135 s | 0.0896 s | 0.2026 s | |
| 128K | 0.4255 s | 0.1861 s | 0.6135 s | |
| 256K | 1.670 s | 0.394 s | 2.066 s | |
| 512K | 6.607 s | 0.813 s | 7.421 s | |
| 1M | 27.454 s | 1.655 s | 29.098 s | |
| 2M | 113.149 s | 3.367 s | 116.490 s |
其中 Discovery 与 FlashMLA 两列来自 5 次 instrumented replay 的同-trial chunk-event sums;Direct total 来自另行采集的 20 次重复 clean replay。 由于测量轨迹不同,不应把前两列的阶段中位数相加,或要求其和精确等于 Direct total。
64K 是第一个预先指定的 discovery-dominant checkpoint。严格结论只能写成
而不能把 64K 插值成连续、精确的 crossover。[MEASURED]
为了区分有限区间上的缩放形状与单点波动,我们还在 5 条 paired attribution trajectories 内计算相邻 doubling 的局部有效指数:
| 区间 | ||
|---|---|---|
| 128K→256K | 1.972 | 1.083 |
| 256K→512K | 1.984 | 1.045 |
| 512K→1M | 2.055 | 1.025 |
| 1M→2M | 2.043 | 1.025 |
从 256K 到 2M,Discovery 增长 ,对应两端点有效指数 ;FlashMLA sparse prefill 增长 ,对应 。这些指数只描述本次五条 fixed-input timing trajectories。结果与 “all-candidate discovery 近二次、fixed- sparse main 近线性”的 有限范围预测一致,但它们不是 OLS 拟合、模型输入分布上的总体估计,更不是对 渐近复杂度的实验证明。
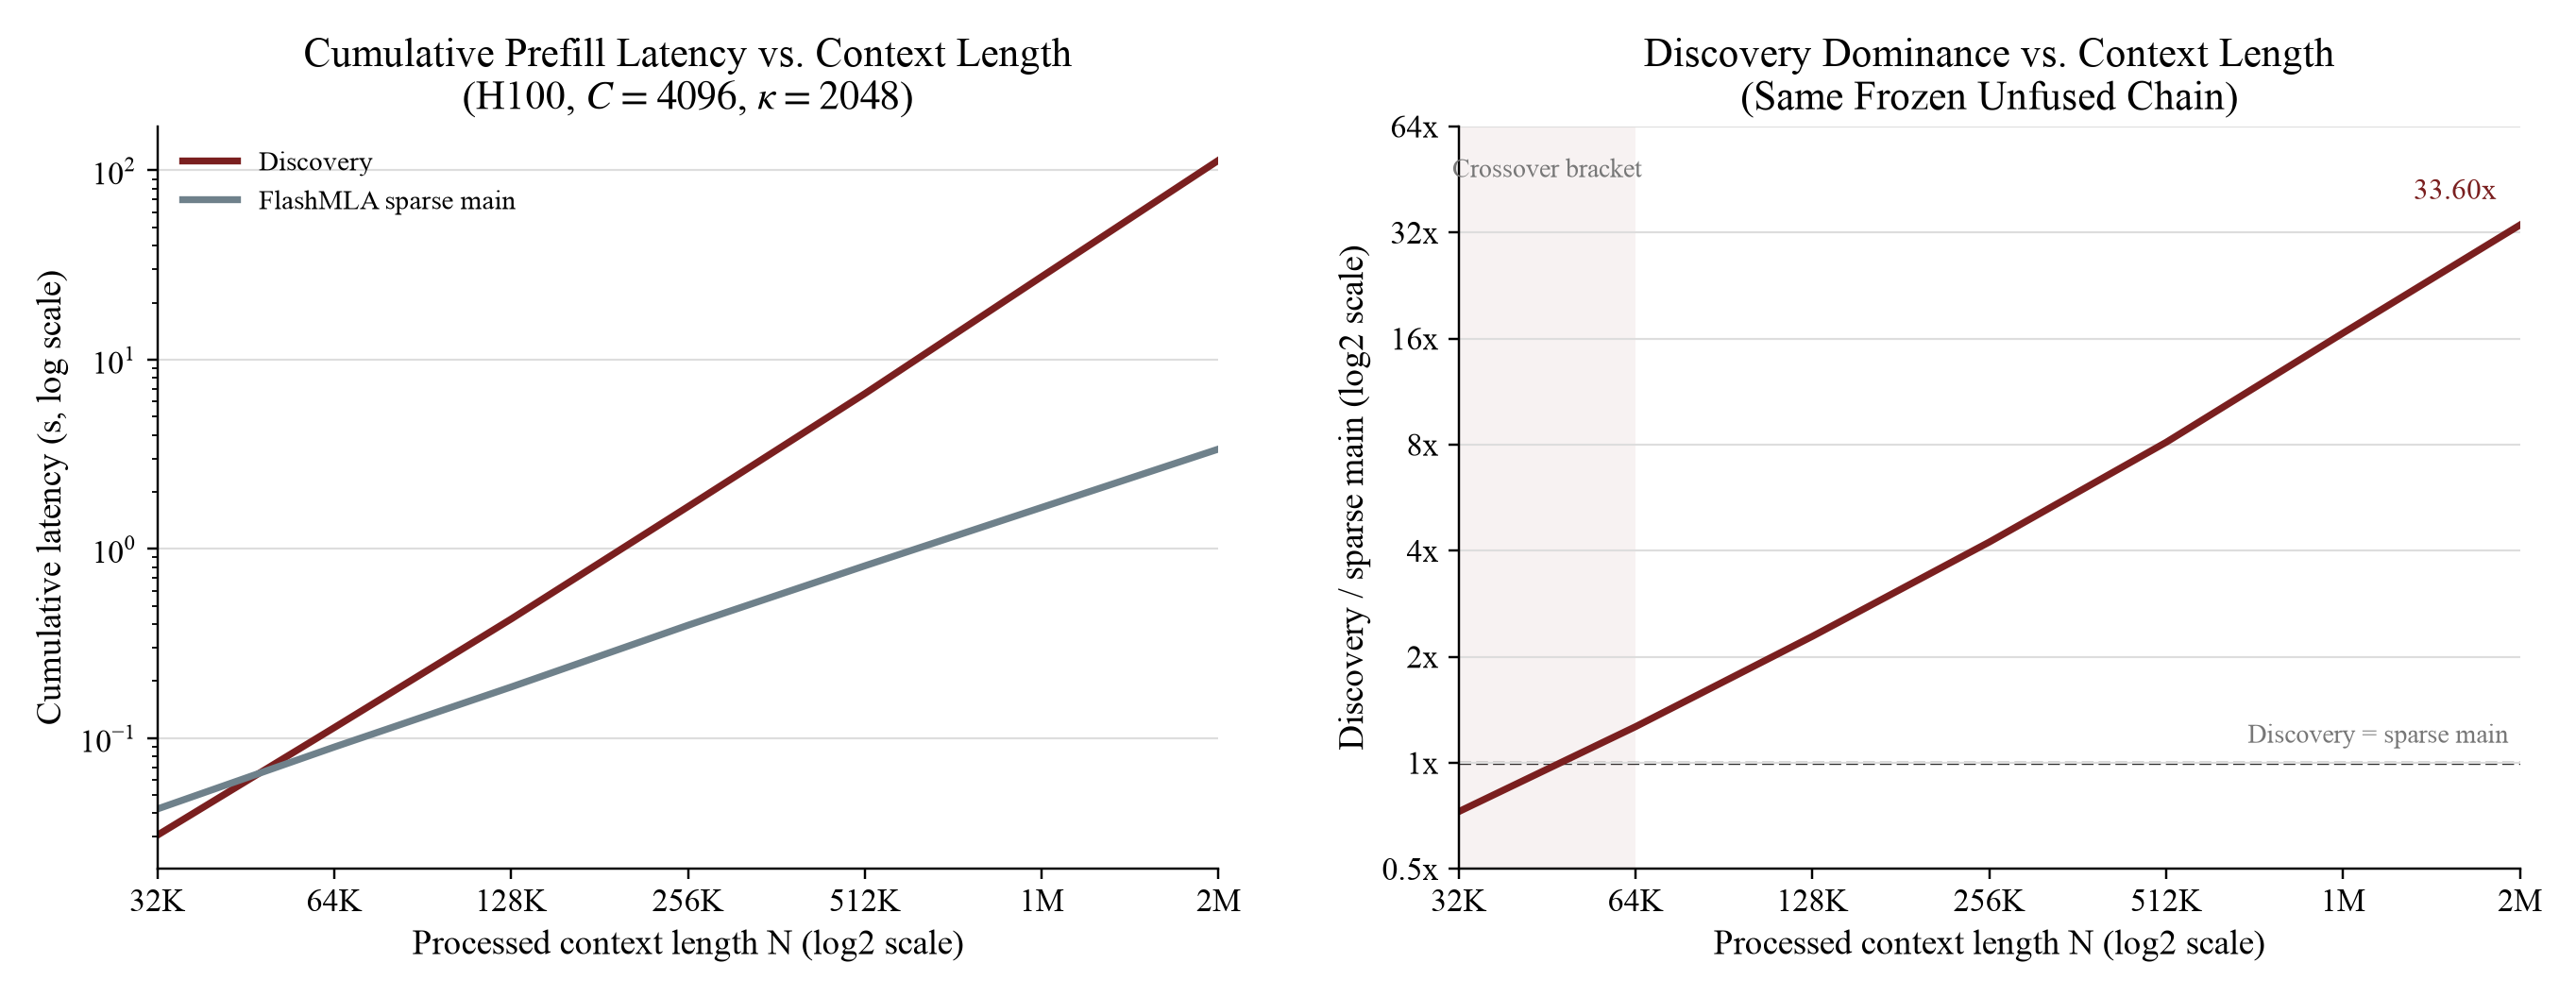
图 2:左图的 Discovery 与 FlashMLA 曲线来自 5 次 instrumented replay 的 同-trial cumulative chunk-event sums,不是 20 次 clean replay 的 direct total; 右图绘制二者之比。所有 checkpoint 都是预先指定的离散测量点,连线只作视觉 引导;阴影表示 的离散 crossover bracket,不是连续插值或 置信区间。
4M 是容量删失点,而不是一个 latency 数据点。 在冻结的 和当前 unfused PyTorch Top-K 路径下,preflight 给出的 严格下界包括 64.004 GiB DeepGEMM carrier backing、64 GiB Top-K contiguous copy,以及 5.626 GiB resident tensors,总计至少
因此实验在实际分配前将 4M 标记为 capacity-censored,没有伪造 latency,也 没有把它称作实测 OOM。这个结论不等于“DSA 的最大上下文是 2M”:减小 、 改变 Top-K 实现或做 scorer–selector fusion,都可能改变容量边界。
长序列上的 Nsys 数据用于解释 kernel 结构,而不是替代正式计时。 在一个 target chunk 上,PyTorch Top-K 的一次语义 contiguous copy 会被 TensorIterator 拆成约 1 GiB 的 shards:512K 为 8 个 launches,2M 为 32 个 launches。除去 这些 copy shards,Top-K 的 kernel-family sequence 与 launch count 都保持为 15,但 radix、scan 和 gather 等 kernel 的 grid 会随 增长,不能笼统说 “Top-K topology 完全不变”。
同一诊断中,target-chunk attention kernel-active time 从 512K 的 变为 2M 的 ,而 discovery/attention 从 增至 。这些 Nsys duration 只佐证同一机制的增长方向,不能和 cumulative CUDA-event latency 混成一条曲线。
128K 的 NCU 数据进一步解释了这些流量来自哪里。 对 128K 最后 一个 query chunk 的 2 GiB FP32 carrier,NCU 观察到 scorer 写出约 1.958 GiB DRAM;随后 Top-K 读取 12.064 GiB,即 carrier 的 ,并写出 2.180 GiB。这些流量来自一次 contiguous copy、四轮 radix threshold,以及 count、scan、gather 等步骤,不是“一次读 logits、一颗 Top-K kernel”。该 target chunk 的 Top-K stage 包含 17 个 CUDA kernels; 完整 4K→128K replay 中共有 513 个 Top-K kernels。
但 launch 数量本身不是主要损失。三次 Nsys full replay 中,kernel span 内 未被 kernel 覆盖的 GPU gap 只有 –。因此 fusion 真正 可能消除的是
而不是把 CPU launch 数直接换算成 GPU speedup。
已测量的事实到此为止。 下面是源码与资源约束给出的设计推论,而不是 fused performance result。当前 DeepGEMM mapping 让一个 persistent CTA 拥有 两个 query rows,并在 CTA 内遍历它们的全部 KV tiles。若保持这种 ownership, exact Top-2048 可以被组织为 CTA 内跨 tile 的在线状态,不天然需要跨 CTA global merge。仅 score 与 ID payload 就是
但这 32 KiB 不是免费的。当前 scorer 已使用 640 threads、96 registers/thread 与 152,228 B dynamic shared memory,并按一 CTA/SM 运行。H100 opt-in SMEM 上限为 232,448 B;扣除 candidate payload 与约 4 KiB 的双缓冲 score tile 后, 名义空间只剩约 42 KiB 给 merge scratch、barriers 与对齐。把 selector consumer 塞进主循环还可能产生 register spill、SMEM competition 或 producer backpressure,反过来伤害原有 WGMMA/TMA scorer。
所以这组测量支持的是一个设计机会,而不是一个已经测得的加速:
scorer–TopK fusion 有机会消除完整 logits 的 HBM round trip,但不会减少 exact selector 必须判断的 candidate 数,也尚未证明其片上维护成本低于被 消除的流量。
我们还单独测量了 paged decode 在生成一个新 token 时的端点开销,并将历史 长度扩展到 4M:256K–1M 的 discovery/decode ratio 为 –,随后在 2M 与 4M 变成 与 ;4M 的 direct full-chain total 为 。但这组计时并不平稳:trial 0–4 与 5–99 之间存在明显的 event-latency regime shift,而 sparse-decode event median 在 1M→2M 又从约 降到 。
4M 与旧 128K profile 中观察到的 attention launch signature——kernel identity、 grid、block 与 launch count——相同,所以已有证据没有把这个台阶解释为一次 可见的 kernel dispatch 切换;它仍不能排除 kernel 内部分支、cache、clock 或 其他 runtime state。因此,这组 decode 数据只用于判断各阶段开销的方向, 不把 或任一绝对 latency 当成稳定硬件常数,也不把 paged FP8 decode 与上面的 BF16 causal-prefill 曲线拼接。
5.7 回到开头:两条 co-design 路线共同揭示了什么
Takeaway. 算法决定“哪些数据值得访问”以及“谁可以共享一次访问”,infra 决定这些访问能否被一个 program 拥有、重排和归约。二者的接口是 shape、 ownership 与 reuse,而不是一个抽象的 sparsity ratio。
把 NSA 与 DSA 放回同一张表,差别就不再只是 block sparse 与 token sparse:
| 问题 | NSA | DSA |
|---|---|---|
| 全局 control plane | 分辨率的 compression Attention | 全 token 分辨率的 128-D FP8 Indexer |
| 最终选择单位 | 连续 64-token block | 任意单 token |
| 算法共享轴 | 一个 KV group 的 16 个 query heads | 128 个 main heads |
| 规则性出现位置 | HBM load 之前 | 离散 rows 搬入 SMEM 之后 |
| 一个 program 内的 load reuse | 16 heads | SM90 head64 CTA 内 64 heads |
| 主要 hidden cost | compression path 与 的 many-to-one reduction | exact all-history scan 与 Top-K |
二者都有“较便宜的全局扫描 + 较昂贵的 sparse data plane”。NSA 的 compressed sequence 长度约为
所以 compression Attention 的 score 数仍约为
它一方面产生 coarse global-context output,另一方面复用 probability 做 selection routing。DSA 的 Indexer 是 routing-only,但保持 full token resolution,因此完整 causal sequence 的候选分数仍为
在论文默认把压缩步长 与 selection width 视为固定配置时, 两种方法都没有把“发现全局相关位置”变成渐近线性;它们只是把发现过程搬到了 更便宜的表示上:NSA 降低 token resolution,DSA 降低 feature dimension 并使用 FP8。真正不同的是规则性在什么时候出现:
这里还要区分两个容易混淆的 reuse:
- semantic fanout:一个 selection ID 在算法语义上代表多少 logit pairs;
- physical load reuse:一条 KV row 进入某个 CTA/program 后,实际服务多少 个 heads 或 query rows。
对于一个 query,NSA 的一个 block ID 代表
个 logit pairs,而同一 KV row 在一个 program 内被 16 heads 使用。DSA 的一个 token ID 在算法上由 128 main heads 共享,但公开的 SM90 sparse-prefill 路径 以两个 CTA 分别处理 64 heads;shared memory 不能跨 CTA 共享,所以单 CTA 内可保证的 physical load reuse 是 64,而不是 128。算法共享是 kernel 复用的 必要条件,却不自动等于一次 HBM transaction 的最终复用次数。
因此,评估 sparse Attention 时必须把完整链条放进同一本账:
只 benchmark 最后的 sparse core,会恰好把最难扩展的部分移出图表。只解释 forward skip 了多少 pairs,却不给 找到稳定 owner,也还不是一个 训练可执行的 primitive。
NSA 与 DSA 最终代表两条互补而不等价的路线:
这条研究链留下的真正开放问题不是“下一种 sparse mask 应该长什么样”,而是:
能否避免全量 Discovery,同时仍向 kernel 暴露足够共享、规则且可归约的 sparse workload?
层次化 routing、近似检索、跨 query 复用候选集,都可能打破 exact all-candidate scan 的前提;但它们也会同时改变模型质量、动态性与 execution contract。下一步真正值得研究的,是这三者之间可验证的边界,而不是孤立地再降 一次 nominal sparsity。
资料与证据
- Native Sparse Attention 提供 NSA
算法、program mapping 与论文性能结果;本文的 CSR backward 机制核对自
fla-org/flash-linear-attention社区实现,不能归因给论文作者的未公开 kernel。 - DeepSeek-V3.2 提供 DSA/Lightning
Indexer 的算法定义;公开参考逻辑位于
DeepSeek-V3.2-Exp。 - DSA scorer 与 sparse Attention 的代码级结论分别核对自
DeepGEMM与FlashMLA。 - causal-prefill Discovery scaling 的长尺度正式数据来自单张 H100;实验范围、计时口径、4M 容量限制与长序列 Nsys 分析均已冻结在正式实验记录中(Run ID:e2-h100-20260809-extended1)。另一组 128K NCU 测量用于解释 carrier/Top-K 的流量。
- KV-row locality experiment 的正式数据来自单张 H100;完整条件、统计方法、 profiler 限制与 provenance 均已冻结在正式实验记录中(Run ID:e3-h100-20260805-formal2)。
- Blackwell
tile::gather4的指令语义以 NVIDIA PTX ISA 为准。它不是本文 H100/SM90 实验所能验证的路径。 - 本文的组织方式参考 MLA, dim by dim 及其中文版: 先给结论,再用一个统一的 tensor lens 逐维推导;本文把同一方法进一步追到 program ownership、memory movement 与 backward reduction。