
一种 DeepSeek V3.2 的融合算子策略的尝试
Oct 13, 2026
代码:EdgePro001/FusedIndexTopK(本文测量的是 v0.3.0,commit
05b44daa)。 本文只覆盖 prefill 侧的算子工作。文中数字都来自原始实验结果,并由脚本逐项核对过。
TL;DR
- 这是一次在 H20 上为 DeepSeek-V3.2 的 Indexer 写融合算子的尝试。Indexer 要先给所有历史 token 打分,再选出得分最高的 2048 个;常规做法是把完整的分数矩阵写进显存,再读回来做选择。我们把打分和选择放进同一个 kernel,结果与原来完全一致(精确 TopK)。
- 收益同时来自两方面:打分与选择重叠执行,以及省去分数矩阵的显存读写。 H20 上打分本身受限于算力,省下的分数矩阵写出与读回在 128K 时约占未融合耗时的 2.7%;更大的一块来自重叠。第一版融合已经省掉了这部分读写,却因为打分要停下来等选择而比未融合还慢;改用双缓冲让两者同时进行之后,性能才明显超过未融合方案。
- 长上下文下,这个算子已经接近 H20 的算力上限。 160K 时主 kernel 达到 FP8 峰值的 95.2%;即使把选择相关的工作全部删掉,主 kernel 也只能再快 0.31%。短上下文和 query 很少的情况还有改进空间。
- 放进整个模型后,首 token 延迟(TTFT)也随之降低,上下文越长降得越多。 在 vLLM 中只替换 prefill 阶段的 Indexer,TTFT 在 16K 时降低 0.19%,在 128K 时降低 1.64%,与”Indexer 占比 × 算子节省”的估算处于同一量级。算子本身在真实输入上相对 DeepGEMM + DeepSelect 加速 1.04×~1.16×。
1 引言
1.1 问题
DSA 的打分公式是:
其中 是 query 位置, 是历史 token, 是 Indexer head。
每个 query t 要对所有合法历史 token s 打分,再选出分数最大的 K=2048 个 token 交给稀疏 MLA。主注意力因此只随 K 增长,但 Indexer 的打分仍随历史长度增长,整个 causal prefill 的打分总量是二次的。
表 1 是原生 vLLM 在真实语料上的成本归因:六种完整输入长度,同一 normal-A 输入包,Nsight Systems 按 NVTX 归因到 Indexer 的打分与 TopK。
| 完整输入长度 | Indexer 累计 GPU 时间(ms) | 非通信 kernel 累计时间(ms) | 占比 |
|---|---|---|---|
| 8K | 291.1 | 5375.6 | 5.42% |
| 16K | 1105.2 | 11492.2 | 9.62% |
| 32K | 4236.8 | 25244.8 | 16.78% |
| 64K | 16703.2 | 58884.8 | 28.37% |
| 128K | 66721.3 | 151246.2 | 44.11% |
| 约 160K | 104917.9 | 210734.2 | 49.79% |
表 1:原生 vLLM 的 Indexer 工作量占比。6×H20,TP2 / PP3,eager,并发 1,chunked prefill 8192。占比的分母是六张卡的 kernel 时间之和,不是 TTFT,不能直接套 Amdahl 定律。
常规实现分两步:DeepGEMM 打分 kernel 写出 的 FP32 分数矩阵,再由独立 TopK kernel 读回。以 Q=4096、N=131072 为例,分数矩阵 2 GiB,写一次读一次共 4 GiB,而最终输出的 int32 索引只有 32 MiB。
1.2 设计目标与约束
- 保持精确语义:逐行输出分数最大的 K 个索引,并列值允许任选合法项;不以近似换性能。
- 去掉中间矩阵:分数产生后就在片上筛选,正常路径不把完整分数写回显存。
- 让选择与打分重叠:TopK 不应让 Tensor Core 停下来等。
1.3 贡献
- 一个适合流水化的精确 TopK:采样估计筛选阈值,全行只做”比较 + 追加”,再在小候选集上用 radix 找第 大;用”数量足够 + 集合完整”的证书判定快路径,失败则精确 repair(第 3 节)。
- 一个 warp 专用化的融合算子:TMA、Math、TopK 三类 warp 各司其职,用 ready / free 双缓冲跨 query 重叠;又依次消除了写候选争用、读空槽、溢出整行重算和调度尾波四类低效(第 4 节)。
- 用干预实验做归因:Math-only 对照、SM 分配 trace、改变 CTA 数的干预,把每项收益归到具体机制,并排除了几个看似合理的错误解释(第 5、7 节)。
- 从算子到整模型的验证:冻结公开版本,用 240 组真实激活测完整算子,再在 vLLM 里测 TTFT,并用量级分析核对两者是否一致(第 6 节)。
矩阵计算的主体,即 TMA 搬运、WGMMA 指令、SMEM 描述符与 swizzle,沿用 DeepGEMM;radix 选择、warp collective 都基于已有方法。本项目的工作在于把两者结合时的候选布局、片上生产—消费同步、容量补救、形状调度,以及证据驱动的性能验证。
2 背景:硬件与算术强度
2.1 硬件
所有实验都在 NVIDIA H20-3e 上进行:
- 78 个 SM,每个 SM 最多 233472 B(228 KiB)SMEM、64 个驻留 warp;
- FP8 dense 规格峰值 296 TFLOPS,HBM3e 141 GB、4.8 TB/s;
- 算力与带宽的拐点约 62 FLOP/B。
H20 的算力约为 H100 的七分之一,带宽反而更高(H100 SXM 为 3.35 TB/s),所以在 H100 上访存受限的很多计算,到 H20 上会变成计算受限。
2.2 Indexer 打分是计算受限的
一个 key 对一个 query 行的打分:64 个 head 各做一次 128 维点积,即 FLOP。一个 key 要读 128 B 的 FP8 向量加 4 B 缩放系数,共 132 B。所以:
这是”每个 key 只被一个 query 行使用”的保守下限。prefill 里一个 key 被大量 query 行复用,实际的 HBM 强度更高。64 个 head 共用同一份 key(MQA),是强度高的根本原因。
这决定了优化方向。 128K 时,写出再读回 4 GiB 分数矩阵,在 4.8 TB/s 下约需 0.9 ms;而未融合方案的完整耗时是 33.738 ms(表 11),这部分搬运约占 2.7%。所以融合的主要收益不会来自省带宽,而要来自让 TopK 不再与打分串行。第 5 节的版本轨迹证实了这一点。
2.3 问题定义
- 输入:FP8 的 Q 和 KV (各带缩放系数),head 权重 ,以及每行的合法范围 。
- 输出:每行 K=2048 个 int32 索引。不要求按分数排序。
精确性的检查标准:
- 索引在合法范围内且不重复;
- 选中的 K 个分数,与真实分数的前 K 大在排序后逐项相等;
- 并列值允许不同实现选出不同的合法索引。
3 精确 TopK:先让选择跟得上
融合的前提是 TopK 跟得上打分的速度,否则候选会堆积,反过来让 Math 停下来等。所以第一阶段先在完整分数上优化独立 TopK(Q=4096,K=2048)。
3.1 反例:在线维护
最直接的思路是边扫描边维护候选,依据是 。
第一版:每线程在寄存器里维护 Top-16。 每接受一个新值,就要重新遍历局部数组找最小值。N=128K 时的 NCU 数据:
- SM 吞吐率 90.79%,DRAM 吞吐率只有 4.19%;
- 每个 warp 平均只有 14.79 / 32 个线程活跃;
- 3.125B 条执行指令中,重算最小值占 55.4%,动态替换槽位占 25.3%,维护合计 80.7%;
- 耗时 10.233 ms,FlashInfer 为 2.834 ms。
第二版:改成 SMEM 上的小根堆。 维护降为 ,输入读取改为 warp 连续:
- 执行指令减半到 1.565B,寄存器从每线程 64 个降到 32 个;
- 但堆维护仍占 68.8% 的指令,128K 时 4.220 ms,仍慢于同期 FlashInfer 的 2.833 ms;
- 每个 CTA 的候选堆要 128 KiB SMEM,一个 SM 只能驻留一个 CTA,occupancy 仍约 50%。
结论:只要扫描与在线维护耦合在一起,降低复杂度也消除不了维护本身。
3.2 采样阈值:把维护问题改成筛选问题
每个 query 先在扫描前估计一个固定的筛选阈值 :
- 采样估阈值:分散抽取约 0.5% 的 token,按样本分布估计 ,目标保留约 4096 个候选,是 的两倍,用来吸收采样误差。
- 全行筛选:固定 扫描整行,把所有 的元素追加进候选集 。扫描中只有比较、计数和写入,没有有序状态要维护。
- 精确选择:在 上用四轮 8-bit radix,找到精确的第 大 ,再按 输出。
正确性证书。 设 被完整保存,且 。那么全行的第 大一定 ,阈值以下的元素不可能进入 TopK,所以
快路径失败只有两种情况:
- underflow:,阈值估得偏高;
- overflow: 超过片上容量,阈值估得偏低或并列值太多。
两种都交给精确 repair。采样只影响快路径能否成功,不影响答案是否精确。
radix 部分把浮点分数转成保序的 32-bit 整数,从高字节到低字节每轮统计 256 个桶。最后剩下的 rank 正好是”还需要从等于 的元素中选几个”,所以不需要排序。
效果:128K 时从堆版的 4.2200 ms 降到 2.7478 ms。配对 NCU 显示执行指令 1.565B → 1.007B,shared loads 196.89M → 7.87M,occupancy 不变,收益来自不再维护堆。
3.3 资源门槛:驻留看门槛,不看用量
每个候选存 score 和 index 共 8 B。把候选容量从 16384 调到 14080,并约束寄存器分配后:
- 每个 CTA 的 SMEM 从 133760 B 降到 115328 B,两个 CTA 共 230656 B,低于每 SM 的 233472 B;
- 每个 SM 可驻留的 CTA 从 1 个变成 2 个,achieved occupancy 从 49.77% 升到 98.66%;
- 在真实 Layer-0 输入、N=128K 下,TopK 从 2.4819 ms 降到 1.9082 ms(−23.1%)。
反例:继续减少 SMEM,只存 index(68224 B)。1024 线程的 CTA 已经把驻留上限卡在 2 个,没有带来更多并行,radix 却要反复从显存取回 score。结果八个真实测试点全部变慢 2.60%~13.54%。
3.4 指令级优化
- 批量预留位置:每线程四项先各自 ballot,合并成一次 shared atomic 申请空间。单变量对照:128K TopK 1.9038 → 1.7474 ms(−8.21%)。
- 向量读取:把每线程四个相隔 1024 的元素改为连续四个,用
float4一次读入。global load 指令减少约 74.6%,L1 sectors 和 DRAM 读取量都不变;128K TopK 1.7259 → 1.6493 ms(−4.44%)。
3.5 阶段结果
| N | FlashInfer(ms) | 本项目 TopK(ms) | 加速 |
|---|---|---|---|
| 16K | 0.660 | 0.647 | 2% |
| 64K | 1.506 | 1.149 | 31% |
| 128K | 2.494 | 1.651 | 51% |
| 160K | 3.219 | 1.852 | 74% |
表 2:独立 TopK 与 FlashInfer FilteredTopK。真实 Layer-0 分数,每个 N 取两组输入的均值;加速 = FlashInfer ÷ 本项目 − 1。FlashInfer 是同协议、同一 block 的单次对照,只覆盖 Layer 0;深层分数分布不同,不外推为”全面领先”。
TopK 已经跟得上,但独立 TopK 改变不了”分数矩阵先写出、再读回、两段串行”的结构。
4 融合算子的设计
4.1 分工与计算映射
| 角色 | 线程 | 负责 |
|---|---|---|
| TMA | 1 warp | 异步搬运 Q、KV tile |
| Math | 8 warp(2 个 warpgroup) | WGMMA 打分、head 归约、按 筛选候选 |
| TopK | 3 warp | radix 精确选择、输出索引 |
表 3:一个 CTA 内的角色,共 384 线程,每个 SM 一个 CTA。TMA 与 TopK 共用一个 128 线程的 warpgroup。
KV tile 为 128 行,两个 warpgroup 各负责 64 行。WGMMA 的形状是 m64nNk32:
- m = 64 行 KV;
- n = BLOCK_Q × 64 个 head;
- k = 32,head 维 128 沿 k 重复 4 条。
每个 warp 拿 16 行 KV,head 归约在寄存器里完成:每个 lane 先累加自己的 16 列,再用两次 shfl_xor 在 4 个 lane 间求和。所以每个 warp 对每个 query 恰好得到 16 个最终分数,一次 ballot 就能完成筛选。分数在寄存器里就地归约、就地筛选,不必写出,这是把筛选放进 epilogue 的前提。
TMA 与 WGMMA 之间沿用 DeepGEMM 的 stage 环:每级一对 full / empty barrier,再加 phase 位区分轮次。我们先在原版 DeepGEMM 上测了这一级:KV stage 从 1 级到 2 级,延迟降低 13.1%(16K)/ 24.3%(128K),第 3 级没有收益,Tensor 指令族活动率约 95%。这一级已接近峰值,剩余空间在它后面新接的一级:Math ↔ TopK。
4.2 双缓冲:Math 与 TopK 跨 query 重叠
第一次把候选和 TopK 放进同一个 CTA 时,真实 N16K 输入耗时 6.616 ms。同一输入重测的有效吞吐只有 147 TFLOPS,比未融合方案的 176 还低。原因是 Math 算完一批 query,必须等 TopK 选完才能写下一批:省掉了显存往返,也失去了并行。
改法是给候选两个槽位。第 批 query 使用槽位 ,phase 位为 :
- ready barrier(256 个 Math 线程到达):Math 写完一批候选,通知 TopK。
- free barrier(96 个 TopK 线程到达):TopK 读完,Math 才能覆盖这个槽位。Math 第一次等待 free 时用相反的 phase,所以两个槽位一开始都可写。
| 指标 | 串行 | 跨 query 重叠 |
|---|---|---|
| 完整算子耗时 | 5.498 ms | 3.848 ms(−30.0%) |
| Eligible warps / scheduler | 0.269 | 0.446 |
| Issue slots busy | 24.32% | 35.34% |
| Achieved occupancy | 18.71% | 18.20% |
表 4:同一布局下只改”Math 是否等 TopK”的消融。H20,Q4096 / N16K,合成输入,含采样与 repair。
occupancy 不变,能发射指令的 warp 变多,收益来自减少等待,而不是提高驻留。
4.3 候选布局:warp 私有段
每行候选区分成 8 段,每个 Math warp 一段,每段 736 项,每行共 5888 项。每个 warp 用 ballot 加 popcount 在寄存器里维护自己段的计数,直接算出写入位置,不再向全 CTA 共享的计数器做 atomic 申请。
代价是段之间不能互借容量:某段满了,即使别的段还有空位,也只能按溢出处理。把同一 warp 原先的两个 368 项小段合成一个 736 项大段后,四组 160K 真实输入的完整耗时降低 0.04%~4.37%。
4.4 按每段的实际数量扫描
TopK 原先遍历整个预留容量,逐个判断位置是否有效。改成按每段的实际 count 遍历后(Q4096 / N16K):
- TopK 处理两行从 167166 降到 123213 cycles,快约 26%;
- 但完整算子只从 3.8556 ms 降到 3.8135 ms(−1.09%);
- Math 等空 buffer 前后都是 102 cycles,TopK 等 ready 反而从 70643 变长到 114362 cycles。
解读:Math 本来几乎不等 TopK,推进速度由 Math 决定。TopK 已被流水线藏住,剩余损失在异常路径与任务调度。
4.5 溢出备用区:避免整行重算
160K 真实开发集中,只有 0.664%(544 / 81920)的行候选溢出,却让 20 个输入里只有 6 个快过 DeepGEMM + DeepSelect。原因是溢出的行要丢弃候选、整行重新打分。先对失败分类:
| 失败原因(共 544 行) | 行数 |
|---|---|
| 单段溢出,但整行总数未超过容量 | 449 |
| 整行候选总数超过容量 | 95 |
| 候选不足 K | 0 |
表 5:160K 开发集的失败分类。
449 行正是 4.3 节”段间不能互借”的代价。改法是保留 SMEM 正常路径,把少量溢出项写进显存中的备用区(每段 256 个位置),TopK 合并两处候选直接完成精确选择。备用区也装不下或候选不足 K 时,仍走原来的精确 repair。
| 方案 | 整行重算行数 | 完整耗时 |
|---|---|---|
| 丢弃后重算 | 544 | 42.072 ms |
| 保存后合并 | 0 | 40.387 ms |
| DeepGEMM + DeepSelect | — | 41.830 ms |
表 6:Q4096 / N160K,5 层 × 4 组真实输入。原本无溢出的 6 个 case 只变化约 0.011%。
开发集从 6/20 变为 20/20 胜出。在不参与开发的独立 holdout(五层、六个原生 N,共 120 个输入)上,16K~160K 为 100/100 胜出,8K 为 0/20(平均慢 4.26%)。8K 的问题由后面的 BLOCK_Q=1 和输出路径优化解决,公开版在 8K 也快于基线(表 11)。
4.6 每批一个 query:让各 SM 的工作均衡
kernel 要等最忙的 SM 做完。query 以每批 BLOCK_Q 行为一个任务分给 SM:Q=512、78 个 SM 时平均 6.56 行。BLOCK_Q=2 时每个 SM 的行数只能是偶数,%smid / %globaltimer 实测有 22 个 SM 拿 8 行。改成 BLOCK_Q=1 后,最忙的 SM 只拿 7 行(44 个 SM)。
- 效果:Q512 / 历史 128K(合成 causal 输入)完整耗时 5.006 → 4.409 ms(−11.9%)。
- 代价:WGMMA 从 m64n128k32 变为 m64n64k32,动态 QGMMA 指令 8.41M → 16.82M,TMA 加载 0.53M → 1.05M,都翻倍。
排除错误解释。 Tensor 指令族活动率从 79.6% 升到 91.4%,看起来像”更窄的 MMA 更高效”。但绝对的 Tensor active cycles 两版完全相同,活动率上升只是因为分母变小;每个 query 的 Math 周期也不变(1.058M → 1.060M)。
干预验证。 保持输入和 kernel 不变,只改变持久 CTA 的数量:
| CTA 数 | 每批 2 query | 每批 1 query |
|---|---|---|
| 156 | 8 行 · 4.807 ms | 7 行 · 4.207 ms |
| 128 | 8 行 · 4.812 ms | 8 行 · 4.787 ms |
| 104 | 8 行 · 4.822 ms | 10 行 · 5.962 ms |
| 96 | 10 行 · 5.975 ms | 10 行 · 5.967 ms |
表 7:最忙 SM 的行数与主 kernel 耗时。
耗时只取决于最忙 SM 的行数,与每批几行无关:
在 420 组真实输入上,Q2 ÷ Q1 的几何平均为:Q=8 与 Q=64 约 1.77×,Q=512 约 1.15×,Q≥1024 约 1.02×~1.04×,最终索引集合全部一致。
5 离天花板还有多远
5.1 版本轨迹
为了看各步优化加起来走了多远,我们用同一份真实输入、同一套计时协议,把未融合方案和每个历史版本重新测了一遍。
有效吞吐只数因果掩码内真正需要的打分,时间是完整算子(含采样、主 kernel 和 repair):
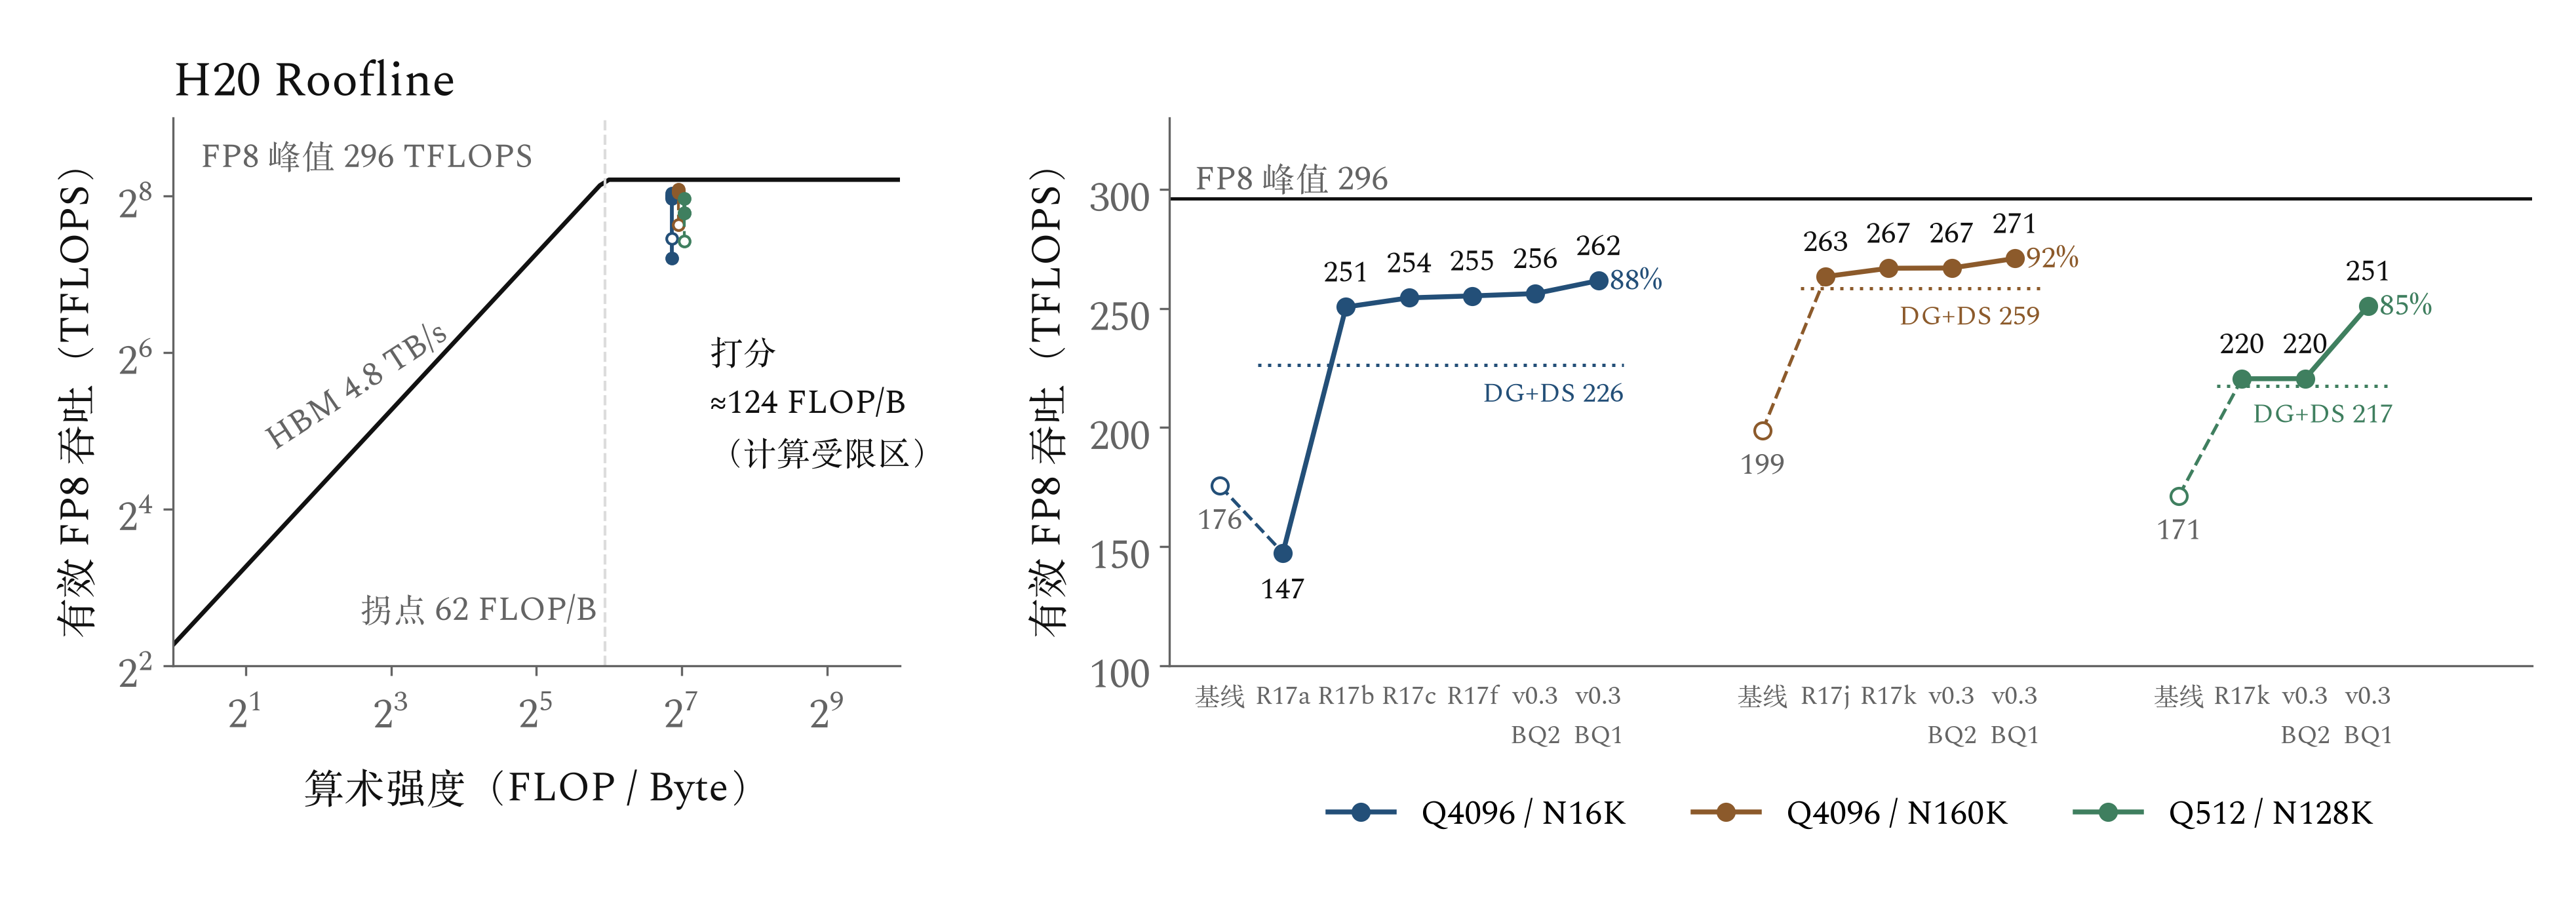
图 1:H20-3e 上的 roofline 与版本轨迹。左:所有版本的算术强度相同(约 124 FLOP/B),都在拐点 62 右侧的计算受限区。右:同一输入、同一协议下的有效吞吐(eager),空心点为未融合的 DeepGEMM + torch.topk,虚线为 DeepGEMM + DeepSelect。
| 形状 | 未融合(torch.topk) | 各融合版本 | 公开版 v0.3.0 | DeepGEMM + DeepSelect |
|---|---|---|---|---|
| Q4096 / N16K(1 份) | 176(59%) | R17a 147 → R17b 251 → R17c 254 → R17f 255 | 262(88%) | 226 |
| Q4096 / N160K(20 份) | 199(67%) | R17j 263 → R17k 267 | 271(92%) | 259 |
| Q512 / N128K(1 份) | 171(58%) | R17k 220 | 251(85%) | 217 |
表 8a:有效 FP8 吞吐(TFLOPS,eager),括号内为占 296 TFLOPS 规格峰值的比例。CUDA Graph 下与 eager 只差 1~2 TFLOPS。
- 起点:未融合方案只有峰值的 58%~67%。它也是计算受限的,慢在打分和 TopK 两段串行。
- R17a 的下凹:省掉了中间矩阵,却因 Math 等 TopK 从 176 掉到 147。省掉搬运本身不等于快。
- R17b 的跳升:双缓冲重叠后升到 251,是全图最大的一步。融合的价值在重叠。
- 后面的小台阶:异常路径(160K 上 263 → 267)和调度尾波(Q512 上 220 → 251)。
- 天花板:160K 达到峰值的约 92%。相对 DeepGEMM + DeepSelect,三种形状分别约 1.16×、1.05×、1.15×。
5.2 Math-only 对照:选择还露在外面多少时间
在公开版主 kernel 的副本上,保留 TMA 加载、WGMMA 和 barrier,删去分数归约、候选生成与 TopK。WGMMA 的累加结果算成 checksum 写出,防止编译器删掉矩阵计算。在 Q4096 / H128K 上用 NCU 核对,两版的动态 QGMMA(68,190,208 条)与 TMA 加载(4,265,984 条)逐项相同,总 SASS 指令减少 85.4%。
| Q | 历史长度 | 删掉全部选择工作后,主 kernel 快了 |
|---|---|---|
| 8192 | 128K | 0.20% |
| 4096 | 128K | 0.31% |
| 4096 | 24K | 1.64% |
| 512 | 128K | 2.00% |
| 512 | 8K | 21.75% |
表 9:Math-only 对照。合成输入,与未改动版同轮交替计时。
指令少了 85%,时间只少 0.31%:长历史时,选择工作几乎都不在关键路径上。注意这个数是”固定当前矩阵路径时,选择露在外面的时间”,不是选择本身的耗时,也不是所有优化的上界。短历史时矩阵计算不够把选择盖住,删掉选择仍能快 21.75%。
5.3 主 kernel 的算力利用
| Q | N | 有效 TFLOPS | 占峰值 | 用到的 SM | TopK 忙碌比例 |
|---|---|---|---|---|---|
| 4096 | 8K | 264 | 89.1% | 78 | 0.85 |
| 4096 | 16K | 273 | 92.2% | 78 | 0.43 |
| 4096 | 32K | 277 | 93.5% | 78 | 0.19 |
| 4096 | 64K | 279 | 94.1% | 78 | 0.09 |
| 4096 | 128K | 279 | 94.4% | 78 | 0.05 |
| 4096 | 160K | 282 | 95.2% | 78 | 0.04 |
| 512 | 128K | 261 | 88.1% | 78 | 0.05 |
| 64 | 128K | 220 | 74.4% | 64 | 0.04 |
| 8 | 128K | 28 | 9.4% | 8 | 0.04 |
表 10:公开版主 kernel(不含采样与 repair),真实 replay 行,固定阈值,20 组计时。Q4096 的六行来自同一次测量(2026-10-13);后三行来自更早的一次测量(2026-10-05),两次都测过的 Q4096 / N8K 为 89.1% 与 88.7%、N32K 均为 93.5%,可作为两次之间可重复性的参考。TopK 忙碌比例 = TopK warp 处理候选的时间 ÷(处理时间 + 等待候选就绪的时间),取自单独的插桩运行,只用来看趋势。
Q4096 时 78 个 SM 都有活,主 kernel 从 8K 的 89.1% 随长度上升到 160K 的 95.2%。最后一列给出了原因:8K 时 TopK warp 有 85% 的时间在处理候选,选择几乎跟不上打分;到 64K 以后只剩不到 10%,大部分时间在等 Math 产出下一批候选。这与 5.2 节的结论一致:历史越长,每行的矩阵计算越多,越能把选择盖住。
Q 小于 SM 数时,按 query 并行的任务不够分:Q64 只用到 64 个 SM,Q8 只用到 8 个,这时 TopK 再闲也无济于事,瓶颈是并行度。另外,在 2026-10-05 的测量中,Q128 / Q256(N128K)虽然用满了 SM,却只有 75.1% / 76.8%:128、256 行不能被 78 整除,最忙的 SM 要多算一行,属于 4.6 节的尾波问题。
小结:长上下文、大 Q 的主场景下,流水线是满的,这条路线已接近天花板;再要大收益,只能少做矩阵乘。剩下的边界是”短历史藏不住选择”和”小 Q 并行度不够”。
6 评估
6.1 设置
- 被测版本:公开版 v0.3.0,commit
05b44daa14991d241de26162aa1bcb773cb6dafb,从干净的 checkout 构建,测量期间不修改。 - 基线:DeepGEMM(
7c95b14a)打分 + DeepSelect(0f03b687)TopK,即未融合方案;在端到端测试中另有原生 vLLM。 - 环境:NVIDIA H20-3e,PyTorch 2.10.0+cu130。B=1,64 head,dim 128,K=2048。
- 输入:240 组真实激活 replay,来自 DeepSeek-V3.2 的 layer 0/15/30/45/60、六个长度(8K~160K)。其中 Q4096 为 120 组,Q64 和 Q512 各 60 组(后两者是原激活的后缀切片)。另有 46 组合成输入,只用于形状与正确性检查。
- 计时协议:完整算子,包括采样 gather、采样 GEMM、阈值、融合主 kernel 和精确 repair。7 组 CUDA Event,同一输入、轮换顺序配对测量;热缓存,不清 L2。JIT、准备和 Graph capture 不计时。eager 与 CUDA Graph 分开测,正文报 Graph。未锁 GPU 时钟。
6.2 算子性能
| N | 本项目(ms) | DeepGEMM + DeepSelect(ms) | 加速 |
|---|---|---|---|
| 8K | 1.795 | 1.872 | 1.04× |
| 16K | 3.685 | 4.258 | 1.16× |
| 32K | 7.722 | 8.694 | 1.13× |
| 64K | 15.761 | 17.131 | 1.09× |
| 128K | 31.912 | 33.738 | 1.06× |
| 160K | 39.836 | 41.870 | 1.05× |
表 11:Q4096 完整算子耗时(CUDA Graph)。每个 N 为 20 组输入中位数的算术平均;加速 = 基线 ÷ 本项目。
| Q | 组数 | 相对 DeepGEMM + DeepSelect(几何平均) |
|---|---|---|
| 64 | 60 | 1.561× |
| 512 | 60 | 1.125× |
| 4096 | 120 | 1.086× |
表 12:按 Q 分组的逐 case 加速比几何平均。1.086× 不能直接说成”耗时降低 8.6%”。
vLLM 常用的 chunked prefill 预算是 8192 个 token,所以 Q8192 是实际会出现的形状。现有真实激活每份只采集了 4096 个 query,Q8192 只有合成输入:
| N | 本项目(ms) | DeepGEMM + DeepSelect(ms) | 加速 |
|---|---|---|---|
| 16K | 6.216 | 7.356 | 1.18× |
| 32K | 14.163 | 16.274 | 1.15× |
| 64K | 30.057 | 32.800 | 1.09× |
| 128K | 62.256 | 65.133 | 1.05× |
| 160K | 77.704 | 81.474 | 1.05× |
表 12b:合成 Q8192(CUDA Graph),两个随机种子的中位数取平均。Q8192 / N8K 因部分行的有效 key 少于 K 而不测。合成输入不能替代真实激活,这里只用来确认趋势与 Q4096 一致。
- Q4096 的 120 组全部快于未融合方案。N 越长加速越小,原因在 5.2 节:长 N 时两种方案做的矩阵乘一样多,能拉开差距的只剩中间矩阵和两段串行。
- eager 下 Q4096 结论一致(1.081×)。
- Graph 下重复组之间的变异系数中位数为 0.06%~0.12%。
6.3 正确性
- 全部 286 组(240 组真实加 46 组合成)都通过了逐行的越界与重复检查。
- 独立 oracle(DeepGEMM 打分加
torch.topk)检查了每组的首、中、末行,以及所有跨实现的索引集合不一致行,逐项比较排序后的 K 个分数。真实输入共审计 852 个 case-row。 - 真实 Q4096 中,快路径失败 10 行(491,520 行中的 0.00203%),全部由 repair 修复;没有未解决的失败。
这些检查不等于对每一行都做了独立 oracle,也不证明模型生成结果逐 token 相同。
6.4 端到端:TTFT
设置:
- 同一个已加载的 DeepSeek-V3.2 和同一个 vLLM 进程(vLLM 0.28.0),只替换 prefill 的 Indexer,decode 保持原生。
- 6×H20-3e,TP2 / PP3,eager,并发 1;FP8 权重,
fp8_ds_mlaKV cache,关闭 prefix cache,chunked prefill 预算 8192。 - 每个长度 2 份真实输入,每个请求生成 8 个 token。各实现按 Williams 顺序轮换,每个 case 测 8 轮。
- TTFT 从提交请求前到第一个非空 token,包含调度、通信、适配层检查、采样和 repair。
| 输入长度 | 原生 vLLM | DeepGEMM + DeepSelect | 本项目 | 相对原生 |
|---|---|---|---|---|
| 8K | 2.751 | 2.762 | 2.761 | 未调用融合路径 |
| 16K | 4.029 | 4.086 | 4.022 | −0.19% |
| 32K | 6.653 | 6.773 | 6.628 | −0.36% |
| 64K | 12.963 | 13.220 | 12.883 | −0.62% |
| 128K | 29.886 | 30.433 | 29.396 | −1.64% |
表 13:TTFT(秒),两份输入的中位数取平均。逐 case 的配对 bootstrap 95% 区间都很窄(例如 128K 为 1.0162×~1.0169×),但这只反映同一会话内的可重复性,两份输入不代表语料整体。
- 原生 vLLM 是很强的基线:它已经用 DeepGEMM 打分加专门的 prefill TopK,不是
torch.topk。 - 8K:早期 causal 行的有效 key 少于 K,适配层全部回退到原生,所以没有收益。两种经过适配层的实现在 8K 都慢约 0.4%,指向适配层的固定开销。
- 160K 不在表中:原始 160K 输入在随后的 decode 阶段超出位置范围,原生路径也复现了异常,所以不进入正式比较。
- 各实现生成的 8 个 token 并非每次都完全一致:精确 TopK 允许并列值任选,这不等于任务质量等价。
6.5 量级核对
端到端收益应当约等于 Indexer 的占比乘以算子相对原生的节省:
| 输入长度 | 原生 Indexer 占比 | 相对原生的节省 | 估算 | 实测 TTFT 降低 |
|---|---|---|---|---|
| 16K | 9.62% | 5.99% | ≈ 0.6% | 0.19% |
| 32K | 16.78% | 4.33% | ≈ 0.7% | 0.36% |
| 64K | 28.37% | 3.42% | ≈ 1.0% | 0.62% |
| 128K | 44.11% | 4.43% | ≈ 2.0% | 1.64% |
表 14:节省是实际调用的多种 Q/N 上、融合版相对原生减少的 Indexer GPU 工作量,含采样、repair 与接入检查。
两者同一量级,而且都随长度增长。实测低于估算,原因有几个:
- 占比按六张卡的 kernel 时间之和计算,不是关键路径;
- 首个 8192 token 的 chunk 回退原生,每个请求有 122 次这样的调用;
- TTFT 还包含 CPU 调度、通信和适配层开销。
这说明端到端收益的上限由 Indexer 的占比决定。
7 经验:预期与实测不一致的地方
| 尝试 | 预期 | 实测 | 收获 |
|---|---|---|---|
| 堆维护 | 降到 ,追上 FlashInfer | 指令减半,128K 仍为 4.220 ms,慢于 FlashInfer | 降复杂度不等于消除维护 |
| 只存 index | 少用 SMEM,应当更快 | 八个测试点全部变慢 2.60%~13.54% | 资源要看门槛,不看用量 |
| 首次片上融合 | 省掉显存往返,应当更快 | 6.616 ms,慢于未融合方案(147 对 176 TFLOPS) | 融合要设计谁等谁 |
| 按实际数量扫描 | TopK 快 26%,整体也应明显变快 | 完整算子只快 1.09% | TopK 已被流水线藏住 |
| 每批一个 query | 更窄的 MMA 更高效 | 每 query 周期不变,收益来自最忙 SM 少算一行 | 指标要靠干预实验验证 |
| 手写减指令 | 指令更少,应当更快 | 静态 SHFL 20 → 15、FADD 30 → 25,完整耗时没有可靠改善 | 指令数不等于时间 |
表 15:六次被数据推翻的判断。每行对应前文一节,口径各不相同,数字不跨行比较。
一条贯穿的经验:先找到决定总时间的那条路径,再动手。一个指标变好时,要先问它在不在这条路径上,再问变好的是分子还是分母。
8 局限
- 收益随形状变化:长 N 时加速最小(160K 约 1.05×),因为打分的矩阵计算占主导。小 Q、短历史时 SM 吃不满,选择也藏不住。
- 融合不彻底:只融合了主 kernel。每次调用仍依次经过采样 gather、采样 GEMM、阈值、主 kernel、repair 五段。即使零失败,masked repair 也要启动若干 kernel(8K 为 5 次,128K 为 26 次);160K 下合计约 0.357 ms,约占 0.9%。小 Q 时这些固定开销更显眼。
- 性能依赖数据分布:精确性由证书和 repair 保证,与分布无关;性能却取决于阈值估得准不准。换一个采样 seed,160K 开发集中 layer 60 仍会出现 underflow。
- 适用与验证范围:
- 只支持 Hopper(H20)、FP8,B=1 / 64 head / dim 128 / K=2048,N 为 8K~160K。
- 真实输入来自同一次采集:24 条提示、1032 篇源文档、五层。
- 真实 Q8192 没有测量(合成 Q8192 的 Q2 ÷ Q1 只有 1.004×)。
- 只验证了 TTFT:每个请求只生成 8 个 token,不能证明 decode 吞吐、并发 TPS 或尾延迟的改善。
9 相关工作
- DeepGEMM:提供 FP8 MQA logits kernel,以及本项目沿用的 TMA / WGMMA 流水线和 SMEM 布局。
- DeepSelect、FlashInfer TopK:独立的 TopK kernel,输入是已写入显存的完整分数矩阵。本项目的独立 TopK 阶段以它们为对照,融合阶段要消除的正是它们所在的那条”写出—读回”边界。
- vLLM 的 DSA 实现:DeepGEMM 打分加专门的 prefill TopK,是端到端实验的原生基线。
- FlashAttention:把注意力分数的生产与消费融合进同一个 kernel,避免物化 的矩阵。本项目面对的是类似的”生产者—消费者融合”,但消费者是精确 TopK,不能套用 softmax 的在线递推,所以要用有界候选加精确补救。
- NSA 与 HISA:NSA 选择连续块,让稀疏访问天然规整。HISA 用分层的块级筛选减少 Indexer 的计算,在 8×H200 上报告了 1.70× 的 TTFT 加速,但改变了选择语义。本项目保持精确语义,在实现层面优化。
10 结论
省掉中间矩阵只是起点。在 H20 上,Indexer 打分是计算受限的,融合的价值主要在于让精确选择与打分重叠,而不是节省带宽。为了做到这一点,我们先把 TopK 从”在线维护”改成”采样筛选加小集合精确选择”,再用 warp 专用化和双缓冲把它放进打分流水线,并依次消除写候选争用、读空槽、溢出重算和调度尾波。最终,完整算子达到 FP8 峰值的约 92%,长历史时选择几乎完全隐藏,在真实激活上稳定快于未融合方案,并在 vLLM 中转化为与估算一致的 TTFT 收益。
剩下的空间,在 prefill 侧要靠少做矩阵乘;小 Q 和 decode 侧则需要沿 KV 维度拆分的并行方式。
附录 A:复现信息
| 项 | 值 |
|---|---|
| 公开版本 | v0.3.0,05b44daa14991d241de26162aa1bcb773cb6dafb |
| DeepGEMM | 7c95b14aa4a66edd7b682e5acdde62351ca81197 |
| DeepSelect | 0f03b68748b304863fdf0181a11458d04ae533a9 |
| 算子测试环境 | NVIDIA H20-3e,PyTorch 2.10.0+cu130 |
| 端到端环境 | vLLM 0.28.0,PyTorch 2.13.0+cu132,6×H20-3e,TP2 / PP3 |
附录 B:计时口径
| 章节 | 口径 |
|---|---|
| 3(独立 TopK) | TopK 阶段的 CUPTI kernel 时间之和,含采样、筛选、选择、输出和 repair;真实 Layer-0 分数 replay |
| 4(融合设计) | 完整算子的 CUDA Event 热态中位数,24 组交替;cycles 来自单独的插桩构建 |
| 5.1(版本轨迹) | 完整算子,eager,CUDA Event;同一输入、交替轮换 |
| 5.2、5.3(主 kernel) | 只计主 kernel,不含采样与 repair |
| 6.2(算子) | 完整算子,CUDA Graph,7 组配对 |
| 6.4(端到端) | 整模型 TTFT,eager,并发 1,8 轮 Williams 轮换 |
不同口径的数字只在同一口径内比较。